导语
大型语言模型的“脑子”里,原来藏着一个类似生物大脑的“奖励系统”。清华大学与斯坦福大学的研究团队在一篇论文中发现,大模型隐藏状态里与“答案对不对、有没有信心”相关的信息,并非均匀散布在数以百亿计的参数中,而是高度集中在一小撮神经元里——研究团队将其命名为“奖励子系统”(reward subsystem)。这个子系统由两类神经元构成:编码“当前局面值多少分”的价值神经元(value neurons),和编码“这一步是惊喜还是惊吓”的多巴胺神经元(dopamine neurons)。
论文题为《Sparse Reward Subsystem in Large Language Models》(大语言模型中的稀疏奖励子系统),作者为清华大学的Guowei Xu与斯坦福大学的Mert Yuksekgonul、James Zou,2026年2月1日首次公开,5月11日修订至v2版本,这项工作把“大模型内部是否存在奖励信号”这个模糊问题,推进到了“具体在哪些神经元、能否干预、如何利用”的可操作层面。
一、从“读得出”到“找得到”:把探针做到神经元级
此前的研究已经发现,大语言模型的隐藏状态中编码着与答案正确性、模型置信度和奖励相关的信息。但主流做法是对完整的隐藏状态向量训练一个分类器(即“探针”),这类实验只能证明这些信息“能够被读出来”,却回答不了一个更根本的问题:究竟是模型中的哪些神经元在编码这些信号?
清华-斯坦福团队的做法是“先探针、后剪枝”:先训练一个简单的两层MLP价值探针,以时序差分学习(TD learning)为目标,从某一层隐藏状态预测当前状态的价值;再按权重L1范数逐步剪除探针的输入维度,只保留对预测最重要的少数神经元,观察预测能力是否依然保持。论文还从理论上给出了稀疏性为什么会出现的两个动机:其一,信息论上,预测“最终答案是否正确”这样一个二值结果,所需的全部信息原则上可以压缩成一个低维的对数似然比;其二,“超叠加假说”认为,训练中出现频率高、重要性高的特征,倾向于获得专门的稀疏表示——而“当前推理能否成功”恰恰是推理全程都有用的信息。
二、价值神经元:大模型内部的“估值器”
第一类被定位的神经元是价值神经元。它们编码的是当前状态的预期价值——用通俗的话说,就是“从当前这步推理继续生成下去,最终答对的概率有多大”。
剪枝实验给出了惊人的稀疏性:即使只保留不到1%的神经元,价值探针依然能较好地预测状态价值。这一现象并非某个模型的特例。研究团队在数学任务的GSM8K、MATH500,常识与科学问答的ARC,代码任务的MBPP+,以及通用指令遵循任务的IFEval等多个基准上,在Qwen-2.5-7B/14B-SimpleRL-Zoo、Qwen3.5-0.8B、Phi-3.5-mini、Llama-3.1-8B-Instruct等多个模型上都观察到了类似的稀疏价值神经元。进一步的交并比(IoU)分析显示,在不同数据集、不同模型上定位出的“最重要价值神经元”位置高度重合——也就是说,这些神经元不仅是稀疏的,还是可迁移的:换一个任务、换一个同底座的模型,关键神经元的位置基本不变。
三、多巴胺神经元:记录“惊喜”与“惊吓”的秒表
如果说价值神经元回答的是“终点还有多大胜算”,第二类多巴胺神经元回答的则是“刚刚这一步,让胜算变了多少”。它们编码的是逐步的时序差分误差(TD error),也就是强化学习中的“奖励预测误差”:当某一步推理让模型最终答对的可能性高于此前预期时,误差为正;让情况变差时,误差为负。
论文中一个直观案例展示了这类神经元的行为:模型起初对一道题没有太大把握,但随后找到了关键逻辑步骤并最终解题成功——多巴胺神经元在这些关键节点出现了明显的激活峰值;反过来,当模型起初信心满满、中途却出现逻辑错误时,对应神经元会在错误出现的位置形成一个清晰的低谷。剪枝实验同样表明,传递“预测误差”信息的功能同样集中在一小撮神经元中:在Qwen2.5-7B/14B-SimpleRL-Zoo模型上,对第20–22层(7B)与第15–17层(14B)的探针做大幅剪枝后,其预测TD误差的Spearman相关性曲线依然基本保持稳定。
“价值神经元”与“多巴胺神经元”这对命名,直接借用了神经科学的类比:生物大脑的奖励系统中,价值神经元(如腹内侧前额叶皮层相关回路)编码决策选项的主观价值,多巴胺神经元则编码奖励预测误差——论文指出,大模型中被定位出的这两类神经元,编码的恰好是同样两个量。
四、因果证据:不是“重要神经元”,而是“奖励神经元”
相关性证据之外,研究团队用干预实验补上了因果链。实验在Qwen-2.5-7B-SimpleRL-Zoo模型上进行:该模型在MATH500数据集上的原始准确率为75.2%。当研究人员把某一层中排名最高的1%价值神经元的激活置零后,模型平均准确率骤降至20.3%,平均下跌54.9个百分点;而作为对照,随机置零同样比例的神经元,准确率平均只变化0.6个百分点,基本保持不变。
分层数据更具冲击力:第2至5层分别置零后,准确率依次跌至37.0%、13.6%、29.4%、1.2%。更重要的是对照基线的“排他性”——用同样的架构和剪枝流程找出“下一词预测神经元”(与奖励无关的目标)再置零,准确率反而平均上升1.2个百分点;按权重大小置零(Magnitude)平均只损失3.6个百分点;经典剪枝方法Wanda平均损失9.4个百分点。价值神经元与“下一词预测神经元”的重叠度仅0.7%,与随机基线(0.5%)几乎没有差别。这说明价值神经元不是一般意义上的“结构重要神经元”,而是特异地与奖励信号绑定。论文据此给出三级证据:必要性(破坏它们推理崩溃)、特异性(破坏它们专伤奖励功能)、功能连贯性(破坏浅层价值神经元,会让深层多巴胺神经元随之丧失TD误差预测能力)——它们确实构成了一个围绕奖励信号组织的功能子系统。
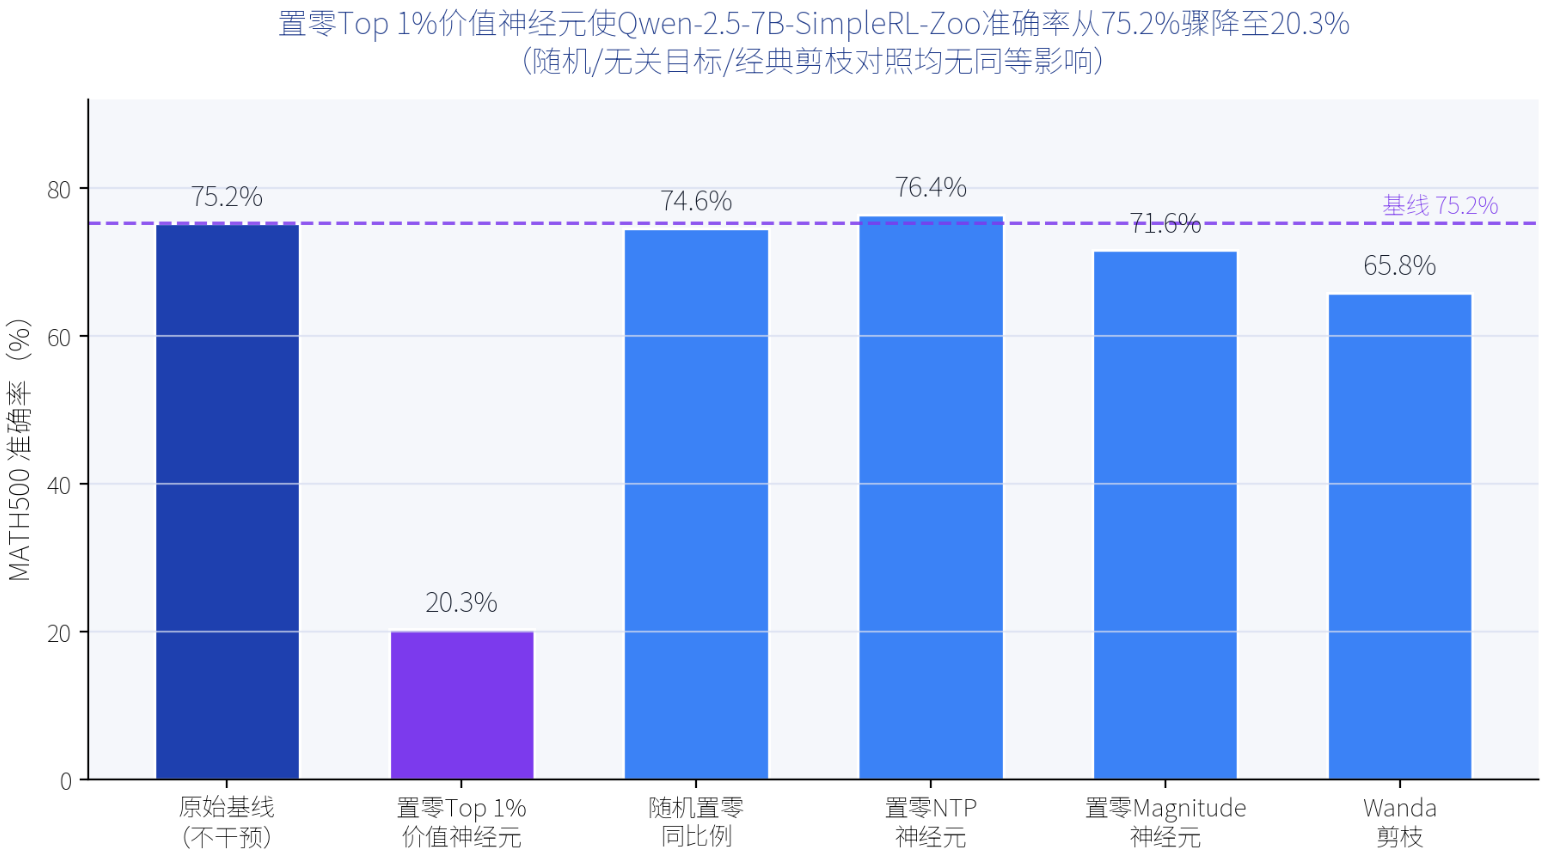
图1 置零Top 1%价值神经元的干预实验结果
五、从发现到应用:更便宜的置信度,更便宜的PRM
这项研究的价值不止于“看清”,更在于“好用”。
用途一:生成前的置信度估计。价值神经元在模型尚未生成任何答案token之前,就能从初始隐藏状态给出价值判断,因此可以充当一个轻量级的模型置信度估计器。在MATH500与ARC两个基准、四个模型上,价值神经元方法的平均AUC达到0.67,高于线性探针方法LCD的0.60、让模型“口头报告”置信度的0.52、基于token概率的0.48,以及问题长度代理指标的0.62。论文指出,现代推理模型的输出越来越长,如果能事前估计置信度,就可以按初始置信水平动态分配算力——有把握的题快速通过,没把握的题多花计算。
用途二:内生流程奖励模型(PRM)。多巴胺神经元编码的逐步预测误差,天然就是“给每一步推理打分”的信号。研究人员让模型在每个推理段落边界产生4个候选步骤,用多巴胺神经元预测的奖励变化为其评分,择优继续。在Qwen-2.5-7B-SimpleRL-Zoo的MATH500验证子集上,这种“内部PRM”引导的搜索把准确率推到77.8%,高于贪心解码与随机选择的72.2%,也高于隐式PRM方法的75.0%。
这一结果的产业含义值得放在更大的背景下看。OpenAI在2023年的论文《Let's Verify Step by Step》中证明,步级的“过程监督”显著优于只看最终答案的“结果监督”,但其代价是PRM800K数据集约80万条人工步级标注(来源:OpenAI, arXiv:2305.20050)。而多巴胺神经元方案不需要任何外部标注或额外的评分模型——奖励信号是模型“自带”的,这为低成本的过程奖励建模提供了一条新路径。
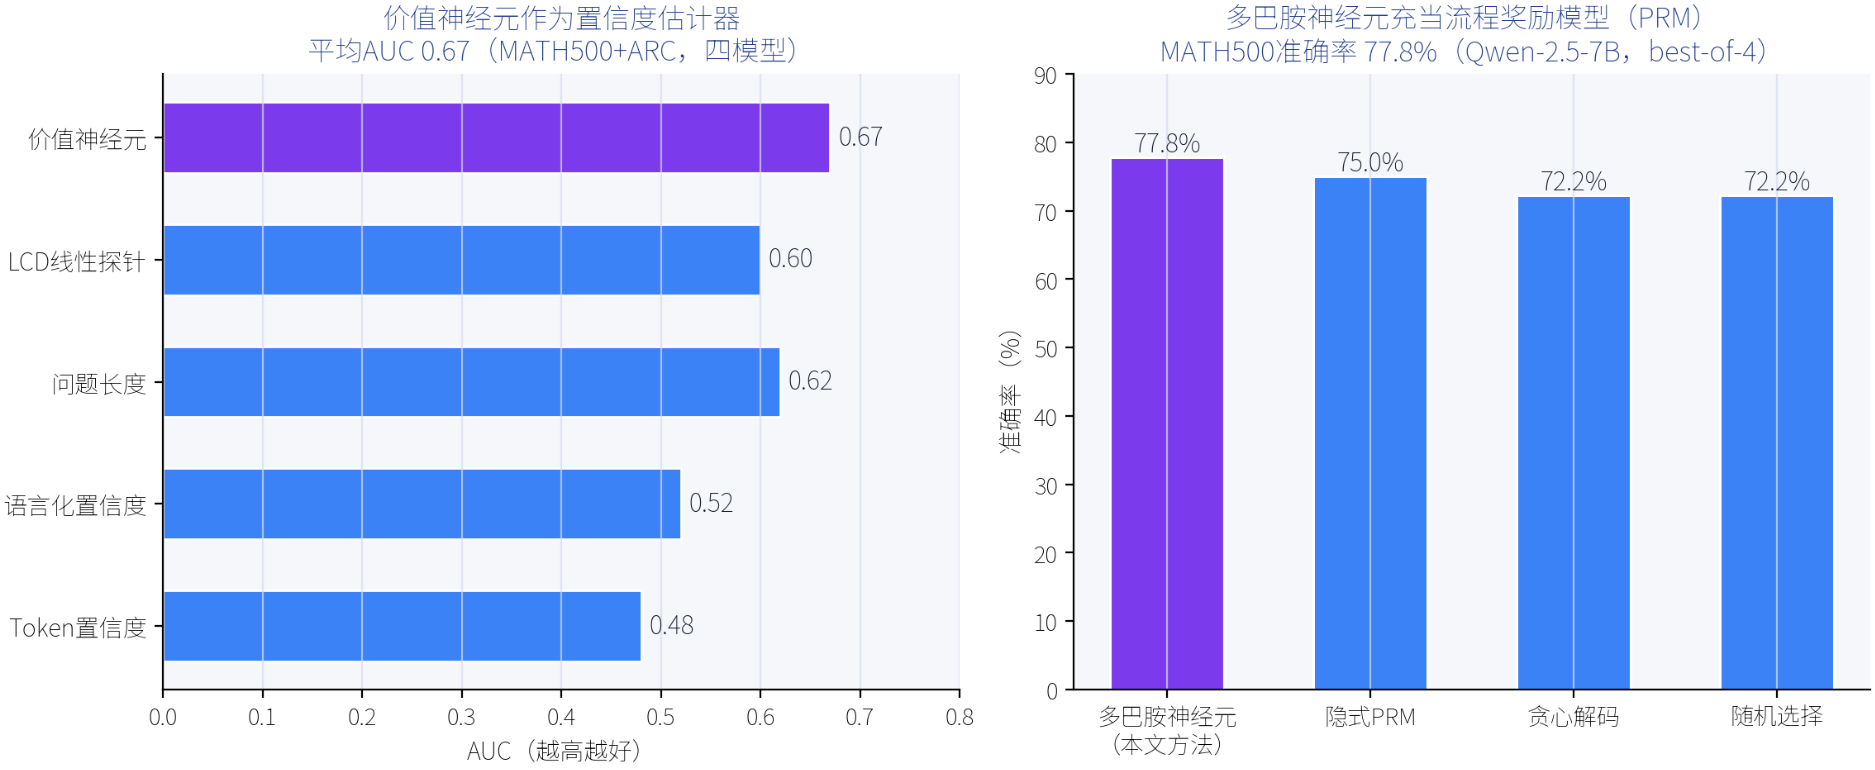
图2 两项应用的性能对比:置信度估计(左)与流程奖励模型(右)
六、走出黑箱:可解释性的下一步,与安全边界
这项工作也嵌在机制可解释性研究的大脉络中。Anthropic此前用稀疏自编码器(SAE)路线开启了“以特征理解模型”的进程:2023年的《Towards Monosemanticity》把一个512神经元的小模型层分解出4000多个可解释特征,2024年的《Scaling Monosemanticity》更是在生产级模型Claude 3 Sonnet上训练出最高3400万个特征的SAE。与SAE“把表征拆成海量特征”不同,清华-斯坦福这项研究选择的是另一个切面:沿着奖励这条功能主线,找到负责它的那撮神经元——从“模型知道什么”推进到“模型如何自我评价”。
论文作者同时坦陈了两点局限:其一,方法依赖环境提供奖励信号,尚未在难以获得此类信号的开放式生成任务上验证;其二,受算力所限,尚未在大于32B参数的模型上检验类似现象是否存在。论文还特别提示了潜在风险:既然奖励子系统可以被定位和干预,它同样可能被滥用于以非预期方式操纵模型行为——例如选择性地抑制或放大奖励信号来绕过安全机制。作者呼吁后续研究检验这些神经元在对抗环境下的鲁棒性,并在实际部署神经元级控制机制之前建立相应防护。
从更长的视线看,这项研究的意义在于把一个看似玄学的问题变成了工程问题:大模型内部确实存在与奖励相关的稀疏结构,而且至少有一部分可以被定位、干预和利用。当“模型如何看待自己这一步走得对不对”有了具体的神经元坐标,理解LLM推理、监控AI系统乃至构建更高效的对齐方法,都多了一把可以握住的把手。研究者们正在走出模型黑箱——这一次,他们不仅知道信息“能被读出来”,还知道它住在哪里。