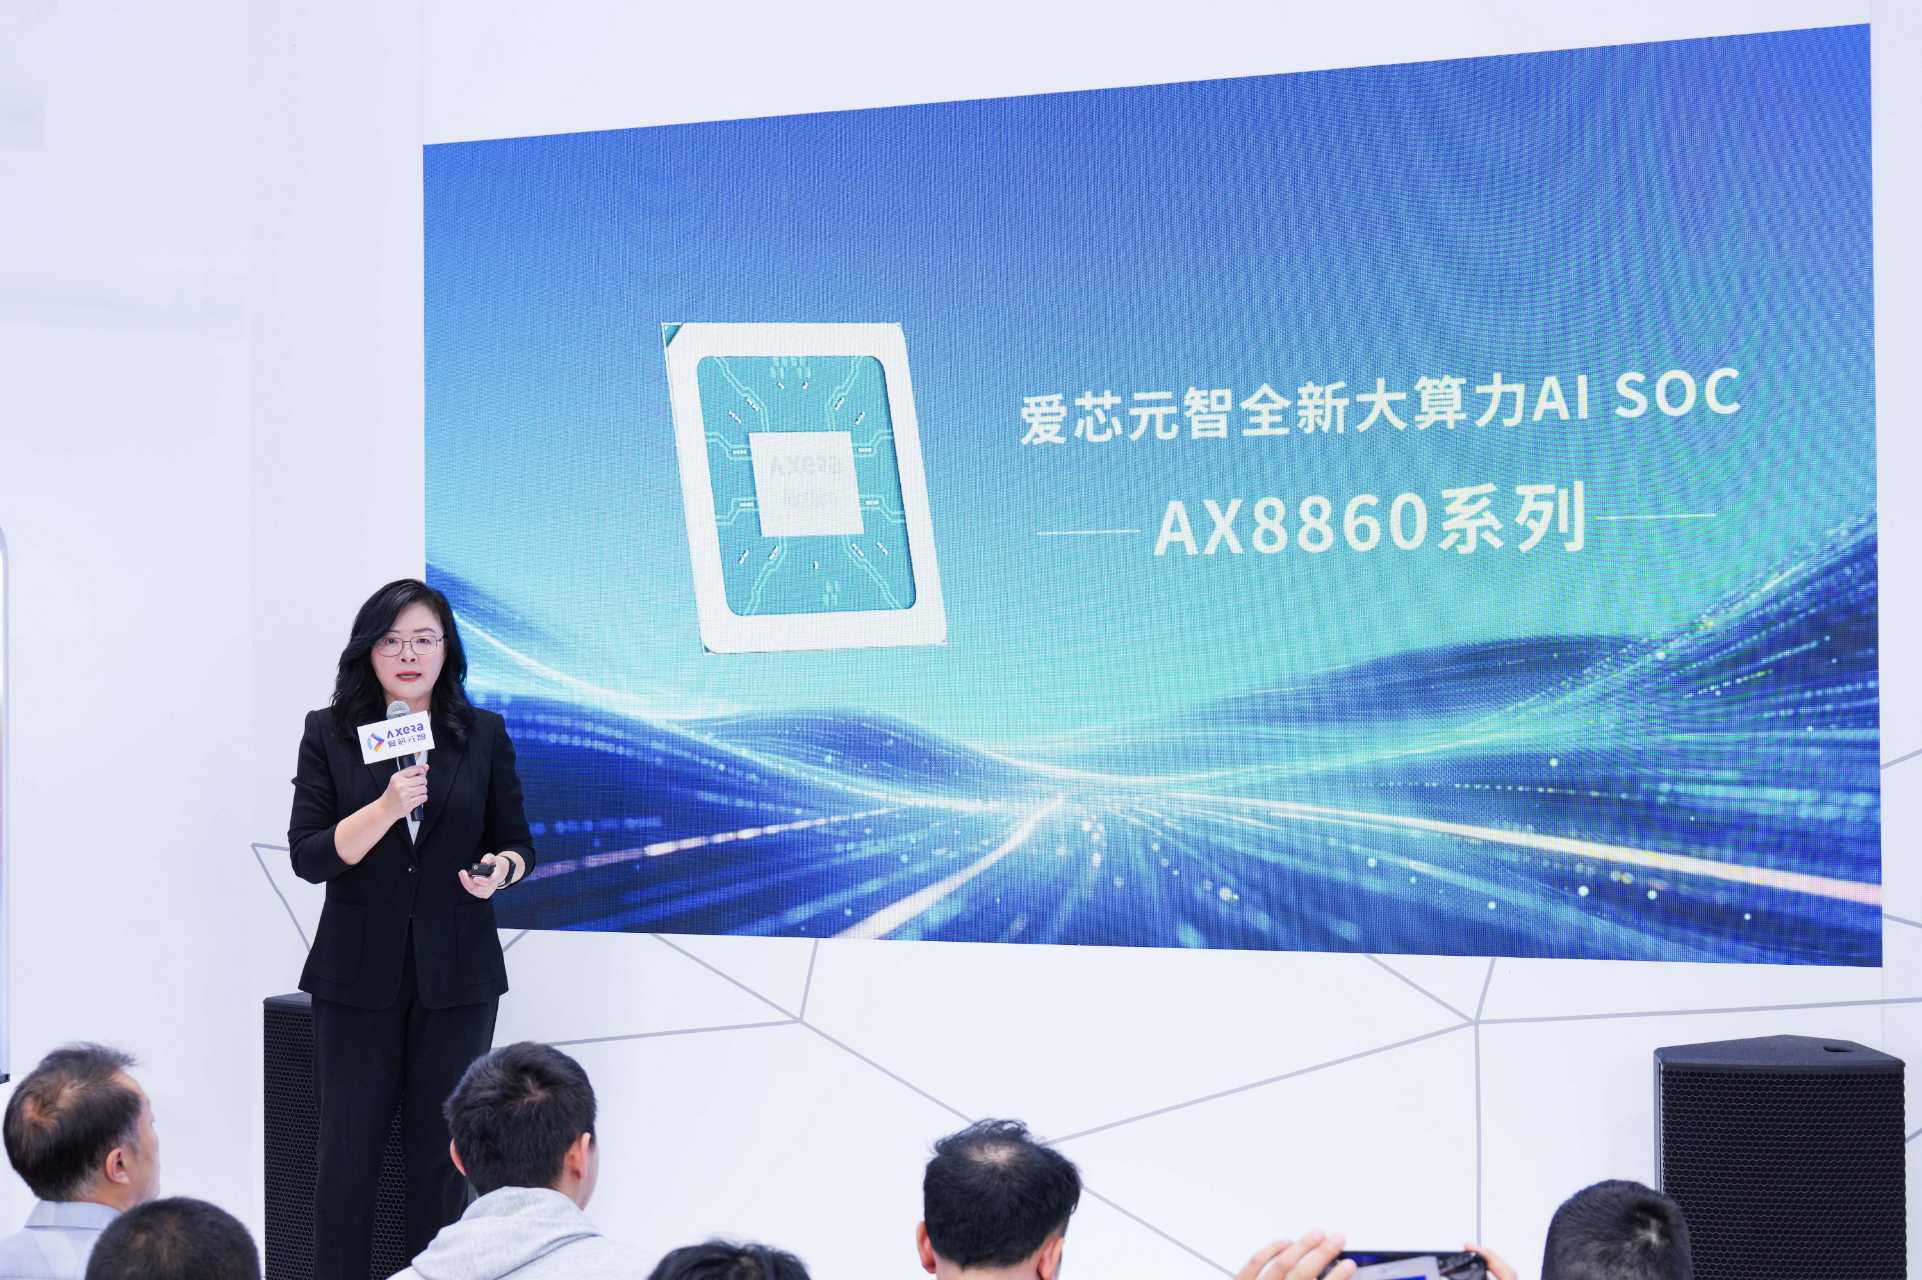
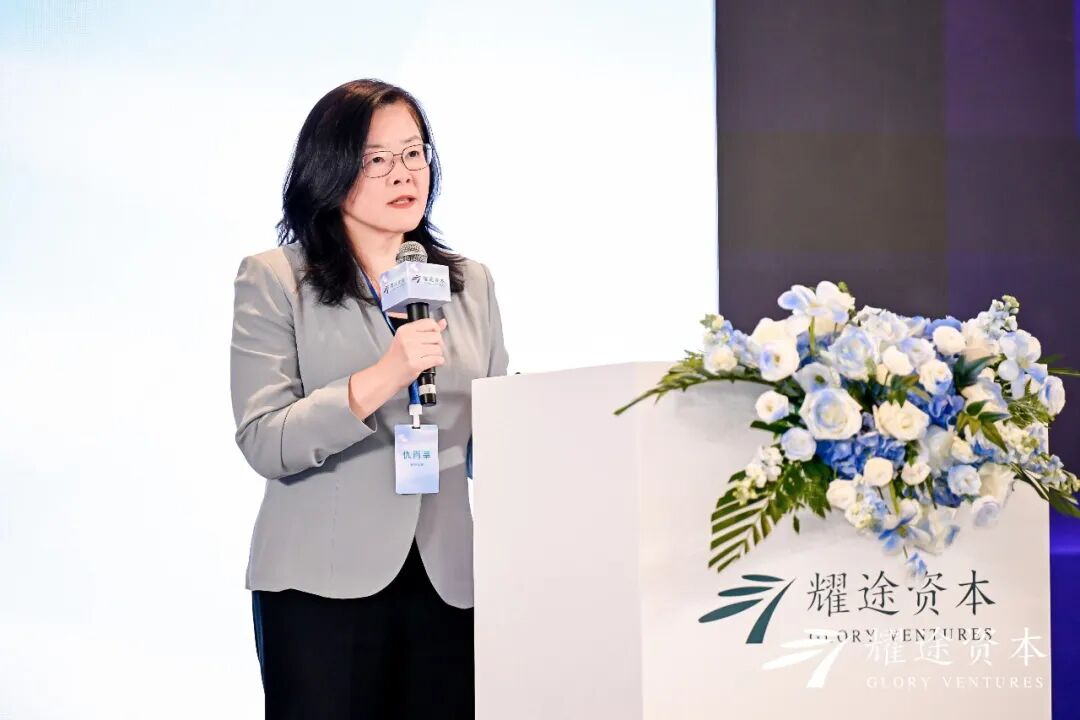
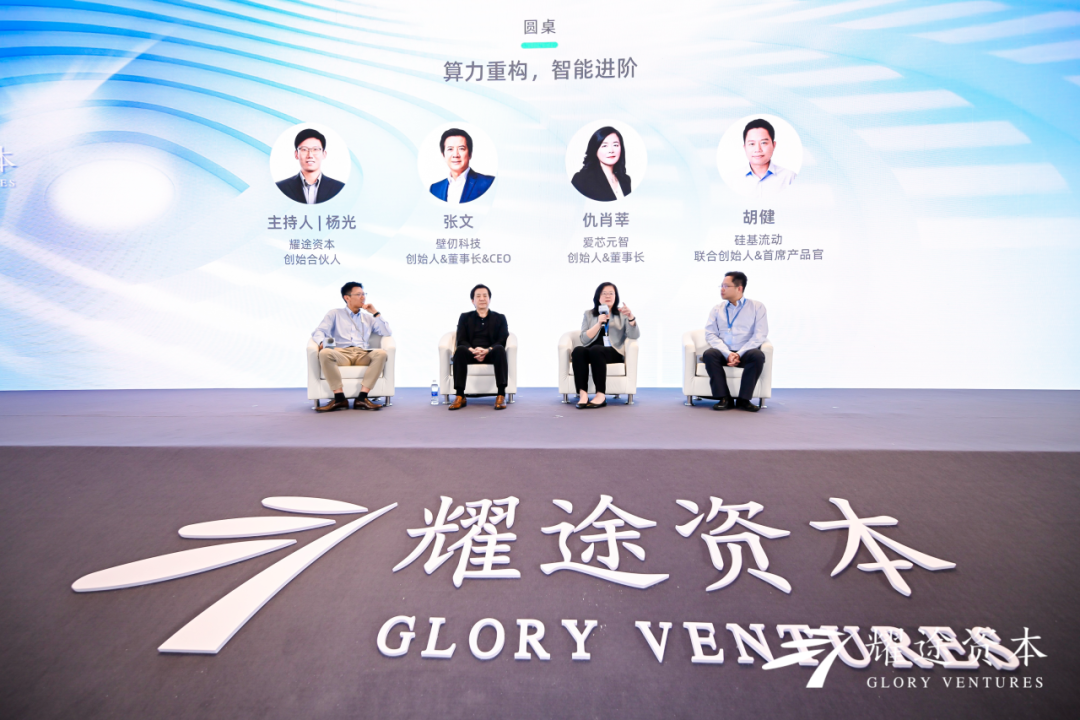
近日,耀途资本 2026 年人民币基金合伙人年会在上海举办,爱芯元智创始人、董事长仇肖莘博士受邀出席并发表主题演讲,同时参与行业顶尖圆桌对话。仇肖莘围绕边缘与端侧 AI 的发展逻辑、平台化芯片战略、AX8860 系列大算力芯片布局、云边端协同架构等核心议题展开深度分享,明确提出大模型算力从云端向边缘、端侧迁移的拐点已经到来,爱芯元智将以全栈技术底座与完整产品矩阵,将物理 AI 与智能体普及的产业势能转化为增长动能。
筑牢平台化底座
破解碎片化市场困局
仇肖莘在演讲中指出,AI 算力产业呈现云端与边端截然不同的市场特征:云端算力市场客户与供应商高度集中,是典型的“水大鱼大”的规模化市场;而边缘与端侧市场空间同样广阔,但呈现高度碎片化特征,单一细分赛道规模有限,无法支撑纯垂直赛道芯片公司的长期成长。
基于这一产业本质判断,爱芯元智自 2019 年成立起便确立了平台化发展战略。历经七年多技术沉淀,公司打造出覆盖爱芯智眸AI-ISP、爱芯通元混合精度NPU 、Pulsar2工具链与软件开发工具包等完整技术底座,以一套通用核心技术覆盖多类碎片化应用场景,持续抬升公司成长天花板。
依托统一技术底座,爱芯元智重点布局三大核心赛道,形成协同互补的业务格局。智能视觉处理跳出传统业务范畴,伴随机器人产业爆发,双目深度相机、数采终端、具身智能视觉设备带来全新增量,赛道进入“老树发新芽”的高成长周期。智能汽车作为边缘 AI 最早规模化落地的成熟场景,公司已建成全算力档位车载芯片矩阵,从支持 AEB 的 L2 级芯片到 700+TOPS 的 L3/L4 高阶智驾芯片,能力可直接对标国际一线厂商。边缘计算赛道则伴随巨头相继推出物理 AI、Agent Box 类硬件逐步升温,边缘计算从概念走向具象终端,本地高性价比算力需求快速爆发,而AX8860系列大算力矩阵的推出,则成为公司全新增长极。
聚焦有效算力
AX8860 系列打造边端 AI 算力基座
随着轻量化模型能力提升,越来越多 AI 任务具备在本地运行的条件;企业内部数据、实时响应及成本等需求,也推动算力向边缘与终端延伸。AI 的下一站是物理世界与现场智能,需要同时满足 “看得见、算得准、反应快、稳定执行”。芯片不仅要关注峰值算力、内存带宽、架构等共同决定的真实有效吞吐,还要关注完整的工具链与开发生态,以此降低模型部署和应用落地门槛。
仇肖莘强调,真正落地的物理 AI 应用,对感知精度、推理准确性、响应时延与运行稳定性都提出了严苛要求。这也决定了边缘芯片不能单纯追逐峰值算力参数,有效算力才是核心价值标尺,最终性能由峰值算力、内存带宽、内存容量与架构效率共同决定。边缘芯片的核心命题,是在成本与功耗的严格约束下,实现有效算力的最大化。
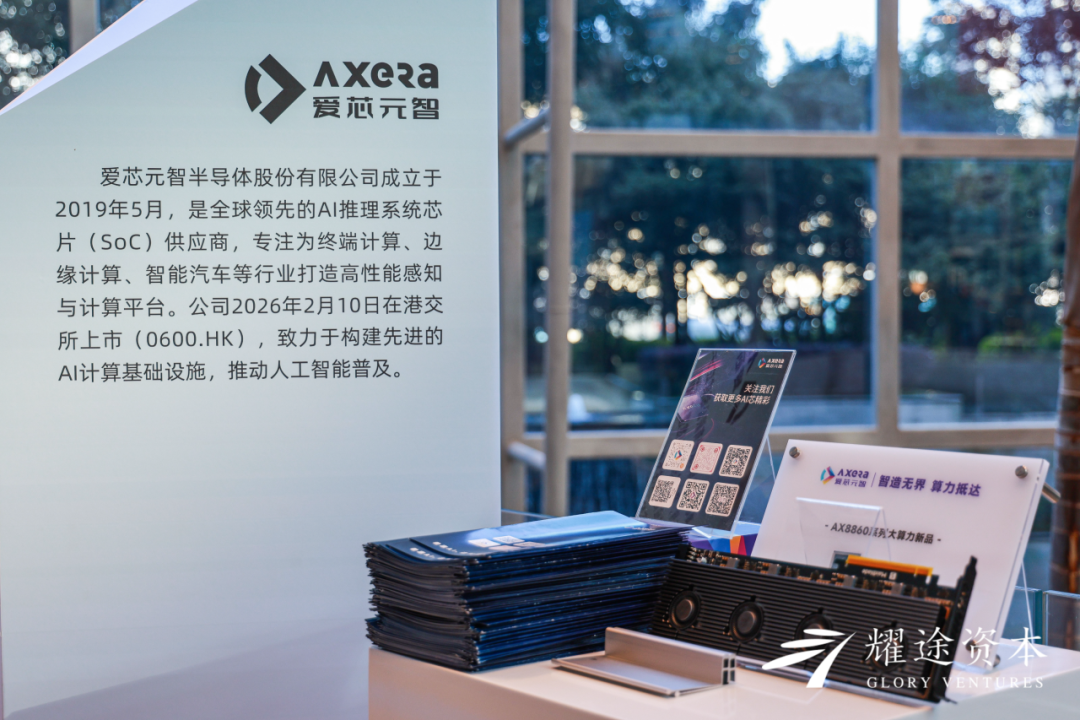
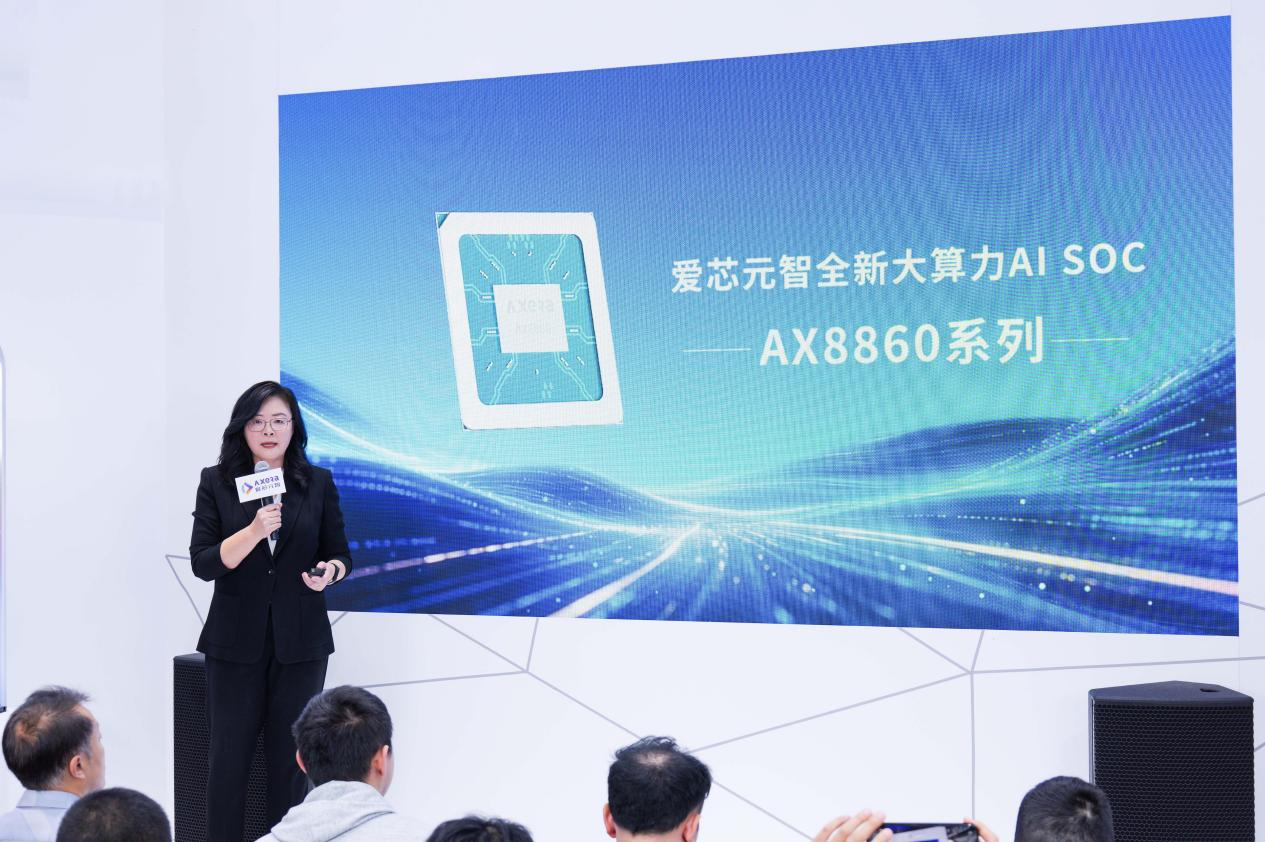
产品层面,爱芯元智在今年工博会上正式发布了 AX8860 大算力边端 AI 芯片系列,提供 256 TOPS 混合精度算力,支持多芯级联,并同步发布元曦 A256S 模组、展示配套推理卡与推理服务器,面向智慧家居、智能办公、智能制造及仓储物流等场景。
该系列产品直接对标国际头部厂商智能体终端的核心算力芯片,能够为边缘侧智能体运行提供高性能算力支撑,双芯片级联即可流畅运行 DeepSeek V4 Flash 大模型,四芯片级联性能接近主流显卡水平,充分满足企业本地私有化部署大模型的算力需求。同时产品支持核心板模组、双芯 PCIe 加速卡、四芯全高全长 PCIe 卡等多种形态,可将传统通用 CPU 服务器快速升级为 AI 推理服务器,覆盖企业本地算力集群、边缘数据中心、个人智能体终端等多元场景,为不同量级的边缘推理需求提供高性价比算力基座。
算力下沉拐点已现
云边端协同重构产业格局
在圆桌对话环节,针对 AI 推理向端边迁移的时间节点与核心场景,仇肖莘结合企业实践给出明确判断:大模型算力下沉的拐点已经到来。一方面,模型轻量化技术快速迭代,蒸馏后的中小参数模型能力已逼近早期千亿级大模型;另一方面,边缘端芯片算力持续提升,两者的交汇让具备生产力价值的大模型在本地运行成为现实。
她以爱芯元智内部研发场景举例:通过搭建本地 Agent 调试一个 IP 的底层配置问题,人工排查两周未能定位的隐藏参数问题,AI Agent 仅用两天便精准找到根因,生产力提升显著。但她同时指出,当前全行业能够熟练搭建、调优 Agent 体系的人才仍十分稀缺,AI 应用整体仍处于发展早期,生产力释放空间远未触顶。
针对云边端算力的长期分布格局,仇肖莘提出“三级协同”的核心判断:云端是无所不能的“大脑”,负责复杂决策与高精度推理;边缘侧是承上启下的 “小脑”,负责本地化数据处理与实时响应;端侧则是 AI 延伸出的“手和脚”,负责感知与执行。三者并非替代关系,而是协同互补。
她进一步指出,未来个人智能体的普及将成为端边算力的核心驱动力。用户的个人记忆、行为数据、隐私信息应当存储在本地专属设备中,实现数据主权的自主可控;智能体可自主调度算力,日常事务由本地算力完成,复杂任务按需调用云端大模型,在保障隐私、降低延迟的同时,大幅控制 Token 消耗成本,支撑智能体 7×24 小时高效运行。 深耕开源生态 实现从芯片到生产力的价值交付 谈及 AI 芯片企业从 “卖硬件” 向 “交付可用算力” 的行业转型,仇肖莘表示,边缘场景的核心痛点是客户模型碎片化、部署门槛高。爱芯元智始终围绕降低客户落地成本构建核心能力,深度拥抱开源生态,提前完成主流开源模型的适配优化,并将适配成果开源至 GitHub,大幅降低客户二次开发成本。同时,芯片硬件还原生支持 FP4 数据格式,可以避免量化精度损失,实现模型的高效无损部署。 针对行业普遍关注的存储瓶颈问题,仇肖莘认为,未来不存在单一的终极存储方案,HBF、3D DRAM、SRAM 存算等不同存储形态各有适配场景,将长期共存、各司其职。其中 HBF 适配权重只读场景,与 MoE 架构天然契合;SRAM 与逻辑芯片分离的架构具备性能潜力,但仍面临良率与成本的挑战。存储技术路线仍处于前沿探索阶段,多介质分层组合将是长期演进方向。 仇肖莘在总结中表示,芯片的最终价值标尺从来不是纸面参数,而是能否真正为客户创造生产力、实现商业落地。未来爱芯元智将持续完善全场景产品矩阵,加速 AX8860 系列的量产落地,以高性价比的边缘算力底座,支撑千行百业的物理 AI 与智能体应用落地,抓住算力下沉的时代机遇。