当AI生成内容以近乎零边际的成本涌入社交媒体、搜索引擎和学术论文,“眼见为实”正在从生活常识变成一种奢望。11月4日,以AI文本检测工具广为人知的美国初创公司Pangram发布Pangram Image 1.0与Pangram Image Flash 1.0两款模型,将检测能力从文本正式扩展至图像与视频。这家此前已为Substack、Quora等平台提供文本鉴别服务的公司,试图把“照妖镜”伸向AI垃圾内容(AI Slop)最泛滥的视觉地带。
AI垃圾内容泛滥成灾,鉴别需求倒逼检测边界扩张
检测能力的多模态扩张,首先是需求倒逼的结果。
AI生成内容在互联网上的渗透速度已经超出多数人的直觉。SEO研究机构Graphite对2020年至2025年间发布的6.5万篇英文网络文章的分析显示,AI生成文章的数量在2024年11月首次超过人类撰写的文章,到2025年中占比已升至约五成。由英国伦敦帝国学院、美国互联网档案馆与斯坦福大学合作开展的一项研究则显示,2025年10月至2026年3月间分析的超过120万个网页中,约35%的网站内容全部或部分由AI产生,其中18%完全由AI生成、17%部分由AI生成,人类创作的内容占比降至65%。该研究主要作者Amy Chen博士直言:“我们看到的是一个真实性遭侵蚀的网络,35%并不是临界点,临界点早就过去了。”
文本如此,视频与图像的生成扩散更为迅猛。视频剪辑平台Kapwing估计,YouTube上最受欢迎的AI垃圾内容频道年收入高达425万美元,该频道此后已被暂停参与平台创收计划;TikTok已自动标记超过30亿条AI生成视频,仅今年前3个月就删除了超过37.7万条违反其AI政策的视频。第三方统计显示,TikTok的AI内容标签数量已从2025年11月的约13亿条增至2026年7月10日的超过30亿条。而在X平台上,根据Pangram自己的数据,近一半超过50个字的帖子由AI生成。
泛滥的代价正在从舆论焦虑变成真金白银的损失。据NeuralWired援引美国联邦调查局(FBI)数据报道,2025年美国AI相关犯罪损失约达8.93亿美元。Gartner预测,到2030年,全球企业在数字内容真伪鉴别上的支出将超过250亿美元;到2027年,50%的企业将投资虚假信息安全产品或服务,而今天这一比例还不足5%。
“现在越来越难判断互联网上什么是真实的了。奖励虚假内容的平台将导致一场向低质量方向发展的竞争。”Substack首席执行官Chris Best如是说。Copyleaks首席执行官Alon Yamin的表述则更直接:当AI能够生成令人信服的照片和文本时,“眼见为实”的说法就不再成立了。
正是在这样的背景下,把检测边界从文本推向图像与视频,正在从“锦上添花”变成“必选项”。
合成镜像训练法:不靠水印,靠像素统计特征“揪出”AI
AI检测器究竟靠什么分辨真伪?这是理解Pangram此次发布的关键。
从定义上看,Pangram的检测系统本质上是一个大型机器学习模型。与OpenAI、谷歌DeepMind等厂商基于水印的检测机制不同——后者主要只能识别自家模型生成的内容——Pangram的检测不依赖复制粘贴元数据或隐藏水印。其图像检测系统基于像素级分布运作,学习真实照片与AI生成图像之间细微的统计差异;即便AI图像被嵌入真实场景照片中,也能通过热力图在图像上方高亮标出可疑区域。
训练方法颇有巧思。在文本侧,Pangram基于数千万份已知的人类文档训练,并为每份文档创建一个“合成镜像”——保留原文档的主题、长度和语气,但由大语言模型重新生成。在图像侧,这一思路被复用:团队用12家前沿AI图像生成器,以与原照片高度匹配的提示词,为100张真实照片批量生成合成镜像,共计1200张合成图像,模型的99.96%自测准确率即来自这组评测集。打个比方,这相当于给每张真照片都制造出一群“数字孪生嫌疑人”,让模型在成对真假的反复比对中,学会捕捉人眼难以察觉的统计“指纹”。
需要强调的是,检测与溯源是两条互补而非互斥的技术路线。以OpenAI textGrain为代表的统计水印,在生成端嵌入不可见信号,其定位是“溯源线索,而非判定AI与人类创作占比的裁判”;C2PA内容凭证等基于元数据的溯源标准,同样依赖生成端与平台的配合。而统计检测独立于生成端运行,可以作为第三方“裁判”,但代价是自身也存在误判与漏判——这也是所有检测类产品绕不开的先天约束。
99.96%与98.7%背后:双模型分工与真实世界的三道坎
具体到产品形态,此次发布采用“一旗舰+一轻量”的双模型分工。
Pangram Image 1.0是旗舰图像检测模型,官方称其在前沿AI图像生成器的检测上达到业界最佳水平:在由1200张合成图像组成的自建评测集上,准确率达到99.96%。模型还强化了对社交媒体压缩缩放、模糊、噪声等常见变换的鲁棒性——这些变换既来自平台的日常处理,也可能被恶意使用者用来规避检测。据Engadget报道,在其测试中,该模型标出了超过99%的AI图像,误报率为0.27%。
Pangram Image Flash 1.0则是更轻、更快的模型,通过逐帧分析支撑视频检测,尤其擅长前沿AI视频的识别。官方披露,在学术基准DF26上,该模型识别AI生成视频的准确率达98.7%,领先次优检测器29个百分点。值得一提的是,DF26研究曾显示,人类在分辨真人出镜的AI视频时几乎与随机猜测无异,而现有检测器的表现也并不理想。为构建更接近真实场景的评测,Pangram从129条真实社交媒体视频出发,用14家前沿视频生成器为其生成“合成镜像”,共计1529条视频进行行业对比。Engadget援引公司内部测试称,视频模型标记AI内容的准确率超过98%。
不过,从实验室指标到真实世界,还隔着至少三道坎。
其一是分辨率。此前Pangram图像检测的最低输入分辨率为512×512,低于该分辨率时准确率明显下降,官方为此将下限进一步放宽至256×256,但在512×512以下,检测结果仍会附带“置信度降低”的提示。Engadget注意到,在公司首席执行官分享的Chrome扩展实测截图中,两张明显并非真实照片的图像得到了“不确定”的结果,低分辨率正是重要变量。
其二是手机端的AI后处理。“包括iPhone在内,大多数手机摄像头都会对真实照片进行某种程度的AI后处理,以增加细节。”Pangram联合创始人兼首席执行官Max Spero在X平台上解释称,“我们必须构建一个对这类后处理足够鲁棒的模型,同时理解AI编辑与完全AI生成画面之间的区别。”据其向Pirate Wires透露,公司为此推迟了图像模型的发布,专门用多部iPhone 18 Pro进行了实测——因为模型一度把手机直出的真实照片误判为AI生成。
其三是误判的社会成本。在文本检测上,Pangram 4将人类文档误判为AI的概率约为万分之一;但即便如此,Substack集成该工具后,仍有部分通讯作者抱怨其作品被误标为AI生成。检测工具的每一次误报,都可能演变为对创作者的“有罪推定”,这也是Spero不希望技术成为针对AI写作用户“猎巫行动”导火索的原因。
商业化层面,Pangram采取订阅、扩展与API的立体布局:网页端订阅每月20美元;Chrome扩展可在用户浏览社交网络、购物网站与租房信息时自动标记AI内容;API同步支持图像与视频检测;免费账户可获得少量图像免费检测额度。文本侧,今年7月29日发布的新一代模型Pangram 4识别AI辅助写作及人机混合内容的准确率超过99%,误将人类文档判定为AI的概率约为万分之一。今年7月,Substack还推出了由Pangram提供技术支持的“AI扫描”功能,读者可获得帖子人机创作占比的百分比评分,该功能面向回复、评论以及超过100个单词的帖子。
【图表:Pangram三模态AI检测准确率对比】
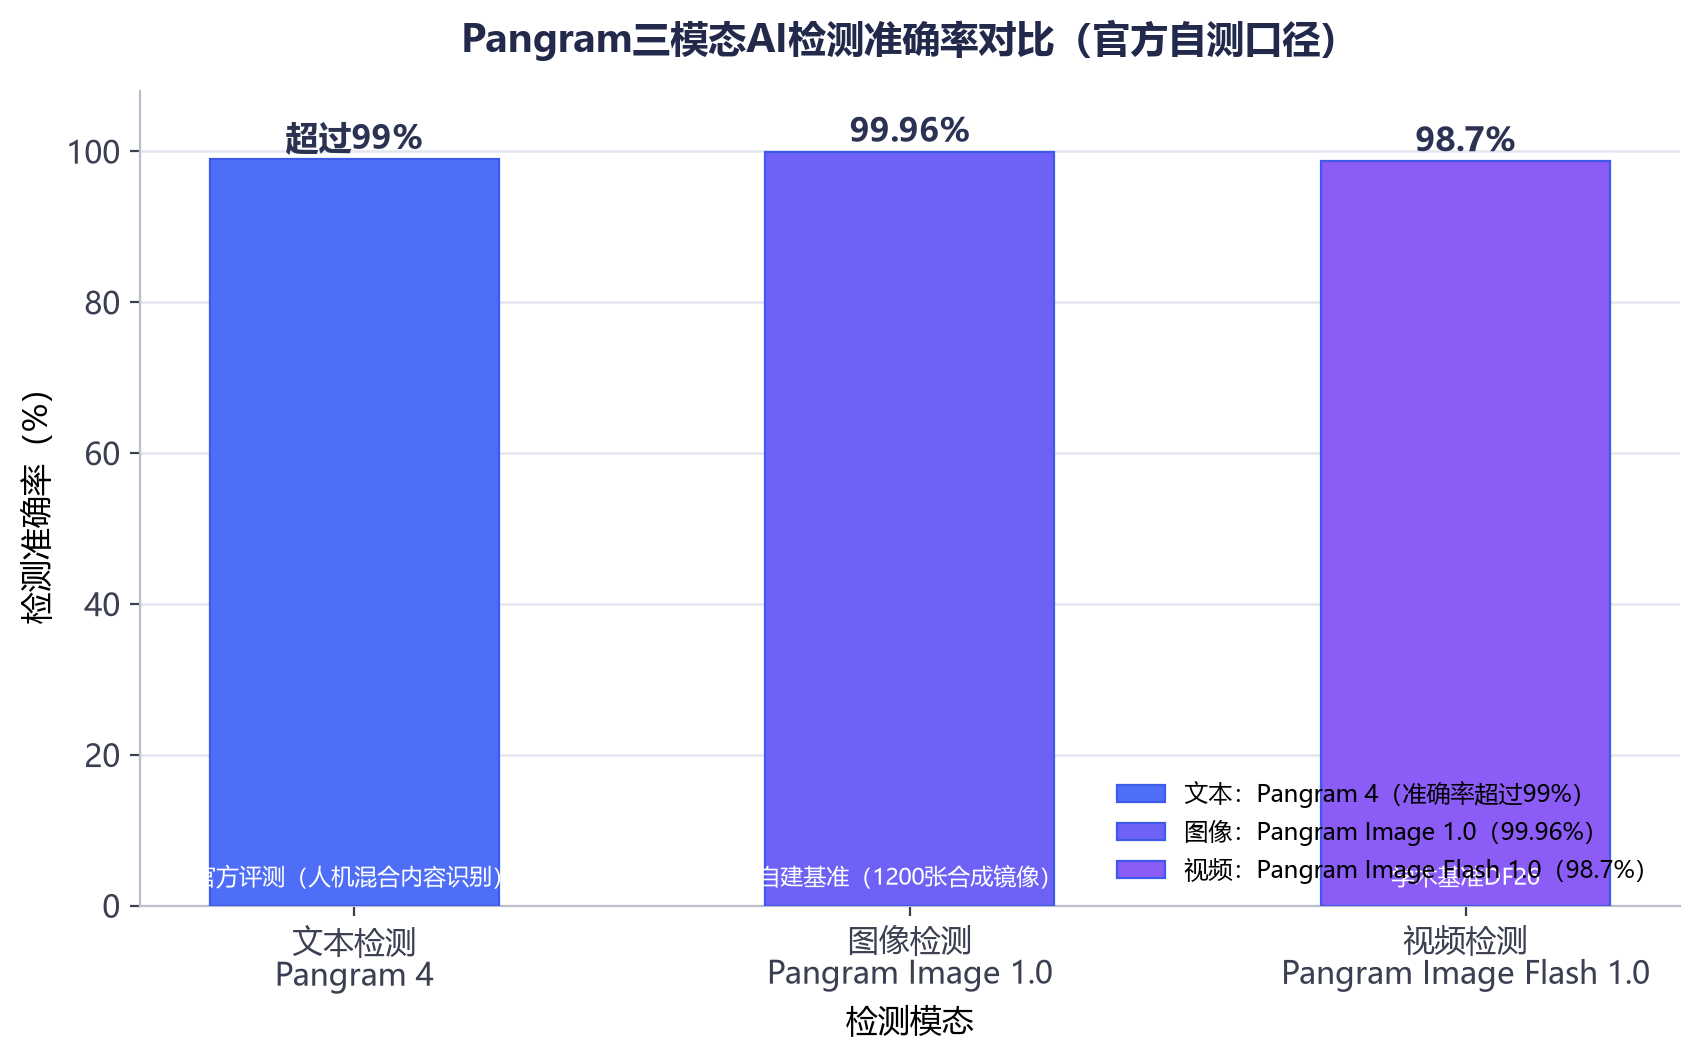
从上图可以看出,Pangram在文本、图像、视频三种模态上的自测准确率均超过98%,图像侧的99.96%为三者最高。但需要指出的是,三者的评测口径并不完全一致,第三方独立复测仍是检验这些数字成色的关键。
竞速者环伺:多模态检测是持久战,不是闪电战
押注AI检测市场的并非只有Pangram。Winston AI、Originality.ai、Copyleaks、GPTZero等竞争对手也在追逐同一需求,市场规模亦在快速放量:据Meticulous Research预测,全球深度伪造检测市场规模将从2026年的约9.9亿美元增至2036年的94.4亿美元,年复合增长率达25.3%。
【图表:全球深度伪造检测市场规模预测】
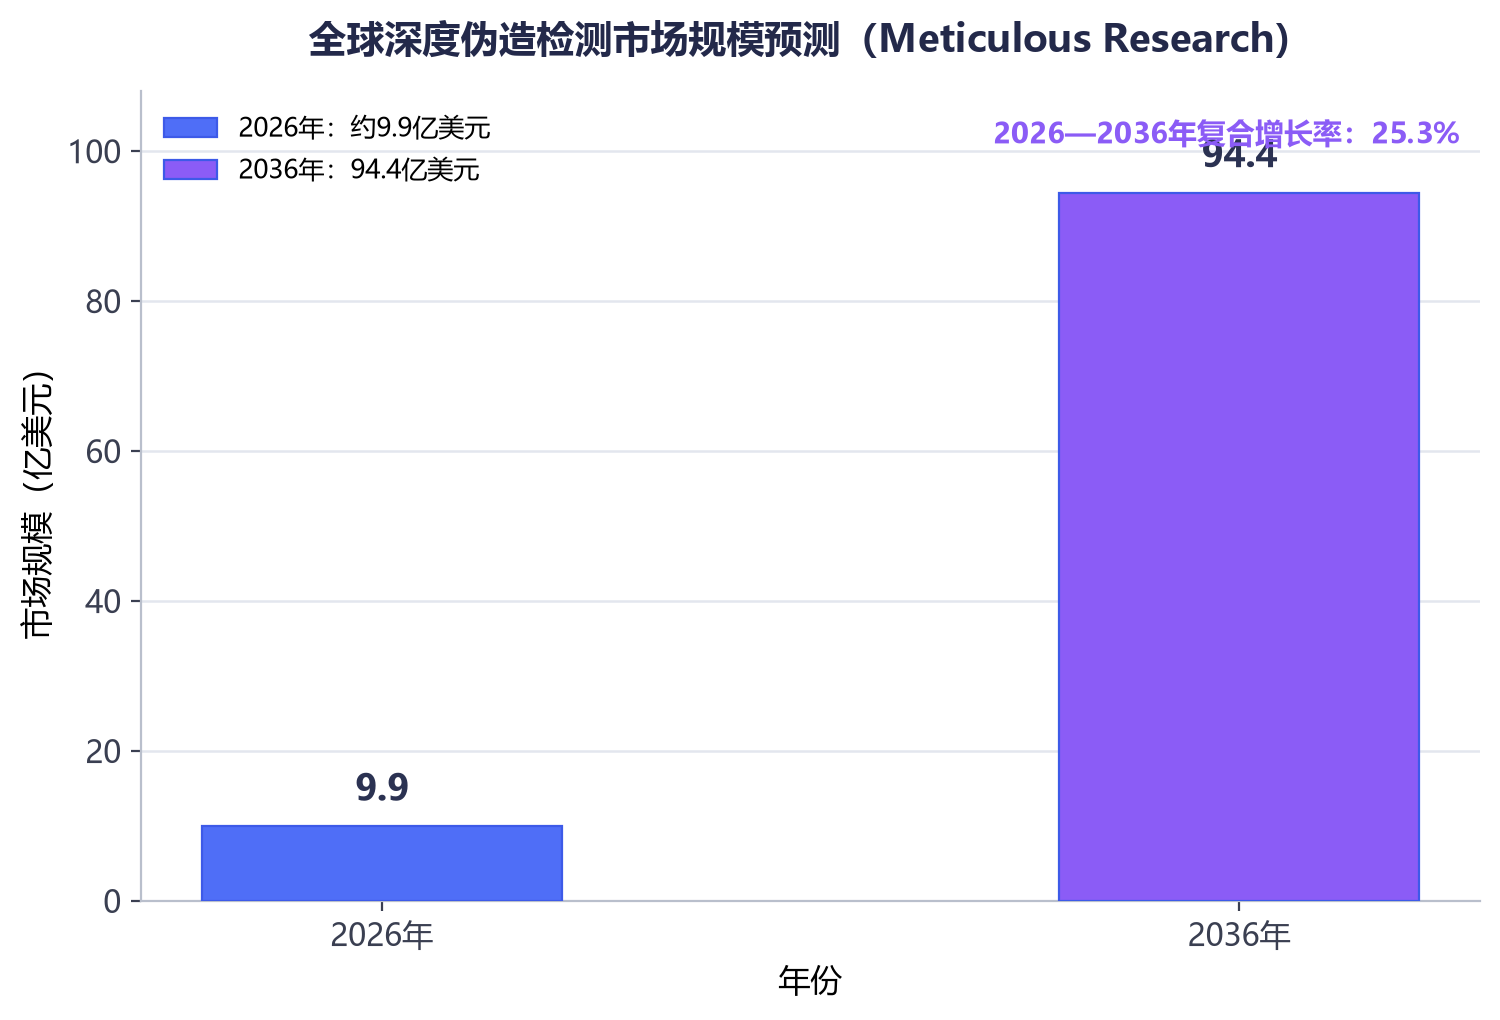
从上图可以看出,未来十年全球深度伪造检测市场有望保持25%以上的年复合增速,规模扩张近十倍,多模态鉴别正是这一市场的主要增长引擎之一。
平台与监管的动作同样密集。TikTok以C2PA内容凭证、创作者声明与隐形水印的组合,把AI标签总量推高至30亿条以上;谷歌研究人员则通过分析上传速度、重复模板等协同行为模式,识别并移除了5万个账户集群。在中国,由国家互联网信息办公室等四部门联合发布的《人工智能生成合成内容标识办法》已于2025年9月1日正式施行,要求服务提供者在内容页面添加显式标识,并在文件元数据中嵌入隐式标识,“该标必须标”已成刚性约束。行业研究亦指出,基于元信息的隐式标识制度在中国已先行落地,统计检测可作为技术光谱中的补充选项。
但攻防的天平远未稳定。检测能力升级的同时,“人性化改写”工具也在批量涌现——2026年的一项系统化网络搜索显示,至少有55个网站提供此类服务,并明示或暗示可以击败检测系统。换言之,AI内容鉴别的竞争不是一场能够毕其功于一役的闪电战,而是检测、溯源、标识与制度协同推进的持久战。
从文本到图像再到视频,Pangram把检测边界推进到生成内容最泛滥的地带,其“合成镜像”训练法与不依赖水印的第三方定位,为行业提供了一种与内容溯源互补的鉴别路径。正如Spero所言:“我预见的未来是,AI内容将持续激增。GPU的增速远超人口出生率。如果我们不主动对人类内容加以甄别保护,AI内容只会越来越多,最终淹没所有属于人类的声音。”生成与鉴别的攻防博弈将长期存在,检测精度、误报控制与全球制度协同的水平,将共同决定这条“真实性基础设施”能否跑赢内容生成的速度。