11月2日,OpenAI发布日常任务评测基准LifeVal,把『AI能不能把生活琐事办完』第一次变成一把可度量的尺子:基于美国与多国时间使用调查构建任务目录,过去一年间其模型的平均奖励从GPT-5.2的49.3%提升至GPT-6 Astra的80.6%。本文拆解这套评测的方法论、能力链条与解读边界。
一、事件全景:LifeVal的发布与核心口径
11月2日,OpenAI在其官网研究栏目正式发布LifeVal,定位为衡量AI在日常生活任务上进展的评测基准,标语直译即『度量AI在日常生活中真正重要任务上的进步』。这一发布与其产品叙事直接衔接:官方页面称,全球每周有超过10亿人在使用ChatGPT,人们需要的『不只是建议或一段聊天回复』,个人助手应当『能够采取真正把事情办完的行动』。
分数层面,OpenAI公布了过去一年五款自家模型在同口径下的LifeVal平均奖励(Average reward,未加权):GPT-5.2(2025年12月11日发布)为49.3%,GPT-5.4(2026年3月5日)为73.0%,GPT-5.5(2026年4月23日)为77.4%,GPT-5.6(2026年7月9日)为80.0%,GPT-6 Astra(2026年9月3日)为80.6%。不到九个月总分提升31.3个百分点,其中GPT-5.2到GPT-5.4一代就贡献了23.7个百分点;而最新一代GPT-6 Astra较GPT-5.6仅多0.6个百分点。
需要明确的口径是:上述分数全部来自OpenAI自己发布的评测材料,属于厂商自评;官方页面以动态图表呈现分数曲线,静态文本未附各模型的分项数据与置信区间。
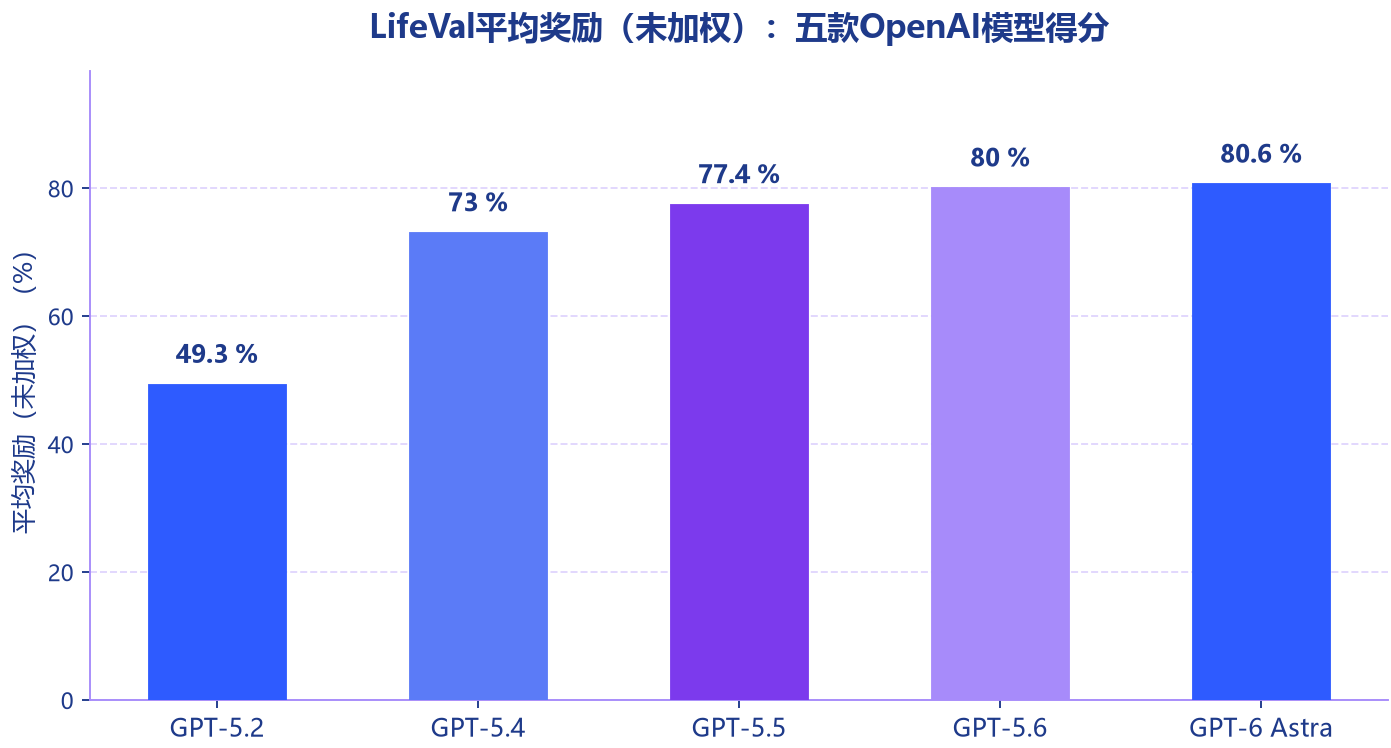
图1 LifeVal平均奖励(未加权):五款OpenAI模型得分
二、方法纵深:任务目录如何从时间使用调查长出来
LifeVal最值得注意的设计,是任务并非研究人员凭空拟出,而是先回答『人们的时间实际花在哪里』。OpenAI首先采用两项大型时间使用研究作为任务目录底座:一项是美国劳工统计局主持的『美国时间使用调查』(American Time Use Survey,ATUS),另一项是覆盖多国的『多国时间使用研究』(Multinational Time Use Study,MTUS)。官方表述称,这两套数据集提供了不同人口群体、不同时段与不同季节里人们日常生活任务的详细目录,覆盖美国及国际范围。
在既有调查之上,OpenAI补充了一项新的、具有人口代表性的调查,共3995人受访者,逐项询问人们最希望个人助手在哪些事情上帮忙,以此确定任务取舍。最终任务落在七大类别:照护、健康、教育、家庭行政、个人财务、购物,以及获取政府服务。官方页面列举的典型需求包括寻找托育服务、办理政务、编制预算、准备开学、调整菜谱、订购食材与制定健身计划等。
据媒体转述口径,LifeVal任务集共169道题,总分按每题同等权重平均得出(该总数为微信公众号『OpenAI出169道生活题』等转述口径,OpenAI官方静态页面未明确给出任务总数)。这一『先调查、再命题』的路径,与传统学术基准『从题库出发』的构建方式形成鲜明对照:前者锚定的是真实生活的时间分配与需求强度,后者锚定的是能力维度覆盖。
方法论层面,这一设计也有明确边界。时间使用调查能够刻画人们把时间花在哪里,但不能穷尽所有地区、制度与家庭情境;找幼儿园、办政务、住房交易等任务高度依赖本地规则与个人偏好,任务目录的地区代表性主要来自美国与MTUS覆盖国家。官方亦未公布任务筛选的完整流程与评分细则,外界目前无法独立审计任务集的构成。
三、能力纵深:从给建议到办成事的技术链条
LifeVal的分数涨幅并非只来自语言能力的提升。OpenAI明确说明,过去一年其模型在浏览器使用(browser use)、计算机使用(computer use)与连接器(connectors)三类任务上持续训练,变得更快、更强、更对齐,LifeVal本身就被用于追踪并推动这些能力的改进。换言之,这套评测度量的不是『会不会答』,而是『能不能穿过外部系统把流程走完』。
官方页面展示的单项示例直观呈现了这一能力形态:为家人找房(卢泽县,限定预算、独立居住单元、接送后通勤较短,并要求把契约加入政务记录购物车供审核)得分100%;洪水来临前组织社区志愿者排班得分98.0%;远程陪长辈一起看比赛得分96.3%;搬家后为孩子筛选幼儿园并整理报名信息得分93.1%;为新确诊糖尿病的家长制定照护与膳食计划得分90.4%。多个示例中,模型把比较、筛选、整理、填表等中间动作接了过去,而把付款、拍板、最终确认留给用户。
支撑这些流程的正是GPT-6 Astra的产品定位。Astra于2026年9月3日发布,OpenAI称其在计算机使用、浏览、软件工程、网络安全、科学和专业工作方面达到全球最先进水平,可承担报税准备、游戏开发、建筑效果图制作、法律备忘录排版与找房等任务。第三方评测口径下,Astra在OSWorld 2.0得72.6%,且较前代在每任务耗时上缩短约47%。
值得注意的是单项满分的口径限定:媒体转述口径提到,GPT-6 Astra在预约车辆年检、预算内订购杂货、取消邮件列表订阅等单项任务的最佳运行记录中取得100%。『最佳运行记录』意味着做成过,不等于每次都能做成;OpenAI也未公布任务级通过率、失败原因与重复运行的稳定性数据。
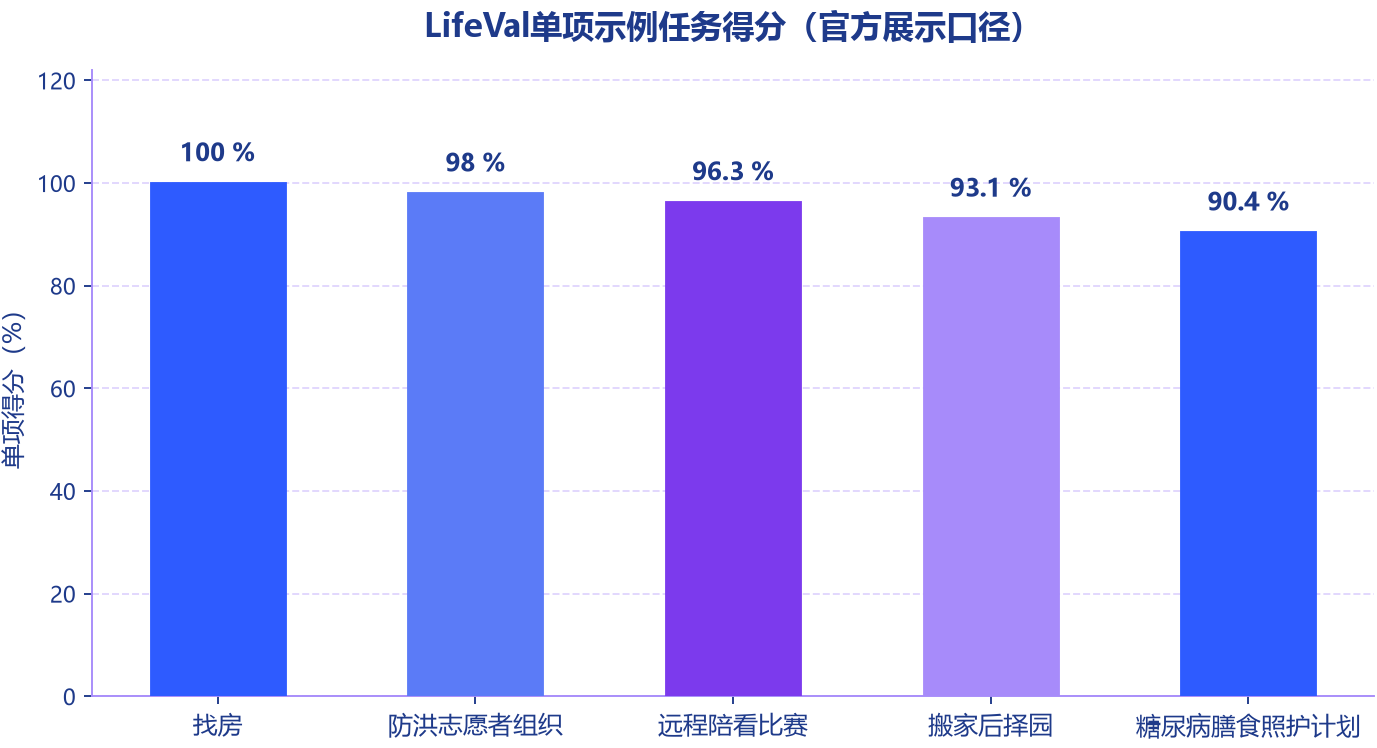
图2 LifeVal单项示例任务得分(官方展示口径)
四、曲线解读:跃升、放缓与基准饱和之问
把五模型分数序列分解为逐代增量,可以看到清晰的三段结构:GPT-5.2到GPT-5.4提升23.7个百分点,是绝对主升段;GPT-5.5、GPT-5.6分别再增4.4个百分点和2.6个百分点,进入渐进区间;GPT-6 Astra仅较GPT-5.6高出0.6个百分点,曲线明显趋平。
对趋平至少存在三种解释,证据强度各不相同。其一是剩余任务更难:早期跃升主要来自浏览器、计算机使用与连接器能力补齐『从说到做』的缺口,大量原本无法执行的任务被快速拿下;而剩余约两成得分空间可能集中在跨多个网站、需要等待他人回复、涉及不可逆决策等高难流程上。其二是任务集趋于饱和:已有社区观点提出,若新一代旗舰仅比上一代高出0.6个百分点,该基准可能已接近其分辨极限——这是合理的待检验假设,但OpenAI未给出官方回应。其三是评分口径因素:若评测主要记录最佳运行,现实使用考验的则是多次运行的稳定性,两者存在系统性差异。
这三种解释目前无法相互排除:官方未公布每道任务的通过率、失败类型与重复运行数据,外界无法判定0.6个百分点的具体成因。可以确认的只是结构本身——在LifeVal这把尺子下,能力补齐带来的红利期已经结束,下一阶段的分化将取决于剩余任务的攻坚,或者取决于这把尺子是否需要重构。
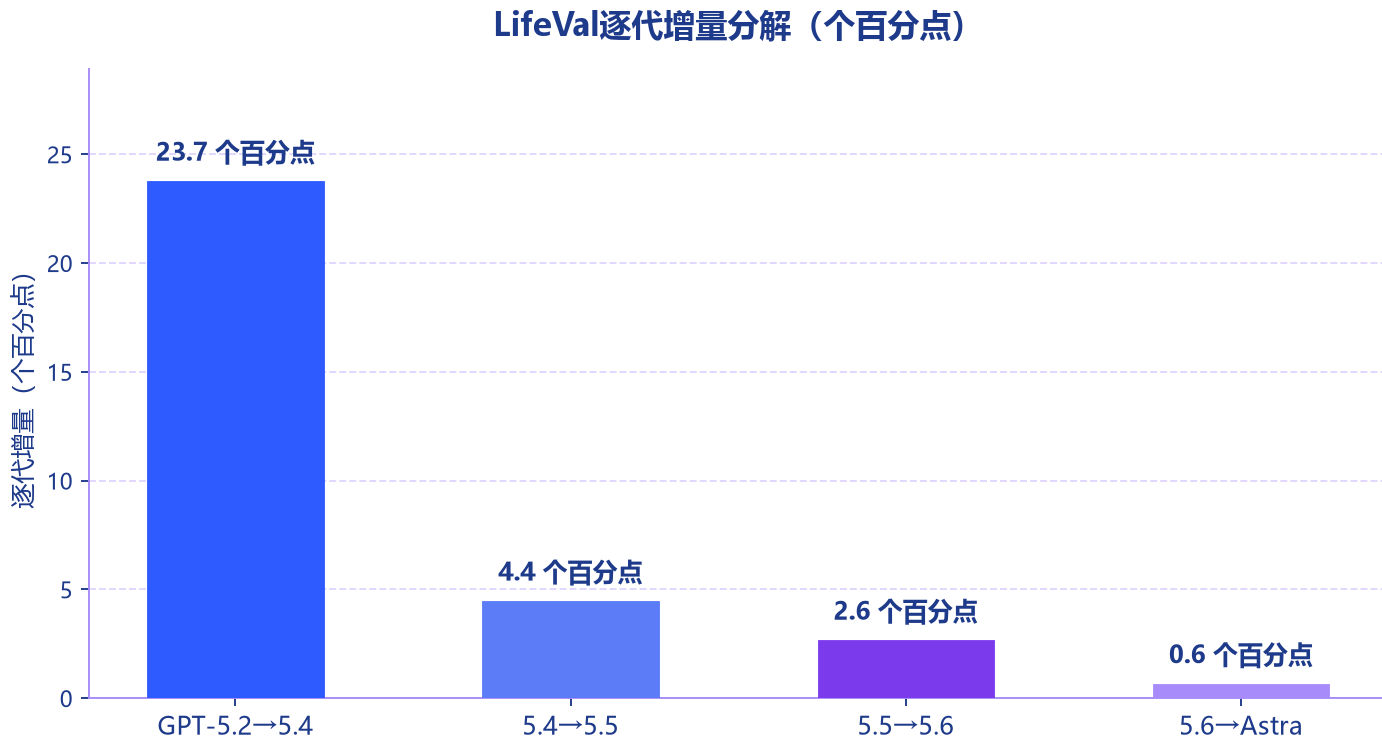
图3 LifeVal逐代增量分解(个百分点)
五、边界与研判:内部评测的可信度与行业坐标
对80.6%的解读必须放在三个口径限定之内。第一,这是内部评测:题由OpenAI出,分由OpenAI算;外界尚未获得完整任务集、评分代码、误差范围或可独立复现的排行榜。第二,只测了OpenAI自家模型,别家模型没有同题成绩,80.6%不是横评名次。第三,指标是未加权的平均奖励,任务难度差异未在总分中体现。因此,80.6%说明的是『在OpenAI自定义的日常任务上,新模型比一年前强了不少』,不等于『ChatGPT帮你办十件事能成八件』。
放在评测生态的坐标系里,LifeVal的差异点是选题逻辑与闭环要求。GAIA、BrowseComp等基准偏重信息检索与多步推理,AndroidWorld、OSWorld偏重操作系统图形界面操作,LifeVal则用时间使用调查锚定『人们真正花钱花时间的活动』,并要求模型通过浏览器、计算机操作与连接器把工作流推进到办成事。这一差异也呼应了行业竞争位置:OpenAI在企业市场持续追赶Anthropic,而个人助手赛道上Meta已发布可代办邮件、卖车、订旅行的Muse,国内厂商亦在推进手机端智能助手评测与个人智能体产品。
用户规模的量级让这套评测的行业影响被放大:官方口径显示ChatGPT每周触达用户已从超过10亿人(LifeVal页面)增至10月7日GPT-6全量开放时的超过12亿人,GPT-6同期成为全球所有ChatGPT用户的默认模型并搭载智能界面。评测结论由此直接作用于产品体验的定义权:当一家厂商同时是命题人、考生与阅卷人时,其发布的高分既是能力声明,也是竞争声明。
后续值得跟踪三个变量:任务集是否开放、是否引入第三方复测,以及评分口径是否从最佳运行转向重复运行成功率。若三者任一落地,80.6%这一数字的含义都可能被改写;在此之前,把LifeVal读作『OpenAI对个人助手路线的度量声明』,比读作『生活自动化程度已达八成』更接近事实。
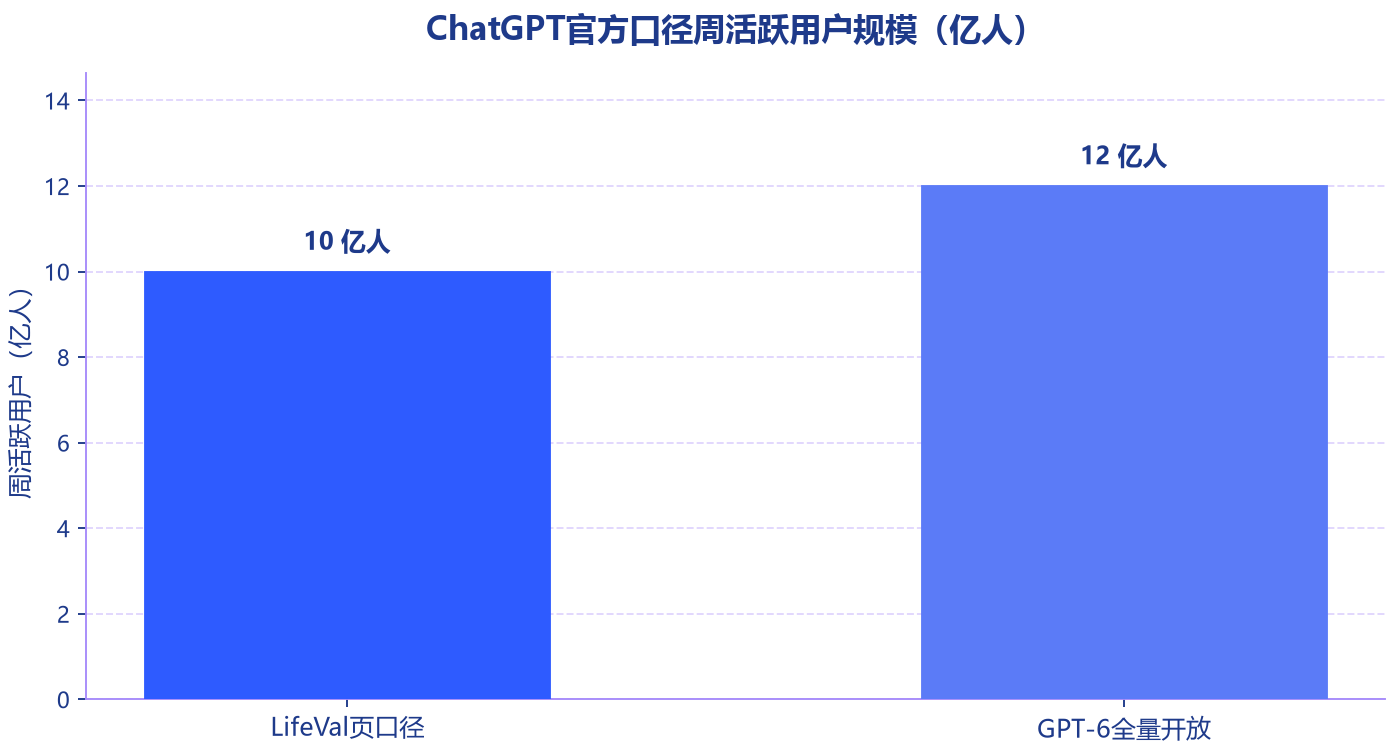
图4 ChatGPT官方口径周活跃用户规模(亿人)
结论
LifeVal把AI评测的提问方式从『知道什么』推进到『能不能办成』:任务来自美国与多国时间使用调查及3995人偏好调查,度量的是模型穿过浏览器、计算机操作与连接器完成真实工作流的能力。一年内平均奖励从49.3%升至80.6%的曲线,前半段是能力补齐的红利,后半段的放缓则把问题留给了任务难度、基准饱和与评分口径三种待检验解释。
在任务集、评分细则与第三方复测缺位之前,80.6%应当被读作OpenAI的路线声明而非行业终点:它证明了当任务清晰、工具可用、权限到位时,AI已经可以从出主意走到推进真实操作;它也提示,日常生活的最后一步——付钱、拍板、承担责任——仍然留在人的手里。评测标准的开放程度,将决定这把尺子最终是行业公共品,还是厂商的私人记分牌。