DeepSeek V4.1 Flash 1017蝉联榜首,全球前五中国占四席;MiniMax M3.1 Flash新进第八。
大模型API聚合平台OpenRouter的最新周度数据显示,2026年10月26日至11月1日,全球AI大模型总调用量达194万亿Token,环比增长3.19%;其中中国模型周调用量99.55万亿Token,环比增长6.43%,约占总量的51%,连续第27周超过美国模型,稳居全球首位。全球调用量前五名中,中国模型占据四席,DeepSeek V4.1 Flash 1017以48.1万亿Token蝉联第一,MiniMax M3.1 Flash则以环比690%的增速新进第八。调用量份额的持续领先,正在把“开发者用脚投票”的结果,转化为观察全球大模型竞争格局的一把新标尺。
一、事件概述:194万亿Token周榜的核心数据
根据OpenRouter最新周度数据,《每日经济新闻》测算,10月26日至11月1日当周,全球AI大模型总调用量为194万亿Token,环比增长3.19%。上榜模型中,中国AI大模型周调用量达99.55万亿Token,环比增长6.43%,按194万亿的大盘计算占比约51%;同期美国AI大模型周调用量为20.68万亿Token,环比下滑7.97%。中国大模型周调用量已连续27周超过美国,稳居全球首位。
需要说明的是,上述“总调用量”为媒体基于OpenRouter平台数据测算的口径,仅覆盖经由该平台路由的调用流量;模型厂商官方API、云平台托管、私有化部署及消费级应用的调用并不在统计范围内。本稿所述份额均指这一平台口径下的相对份额,后文将专门辨析其边界。
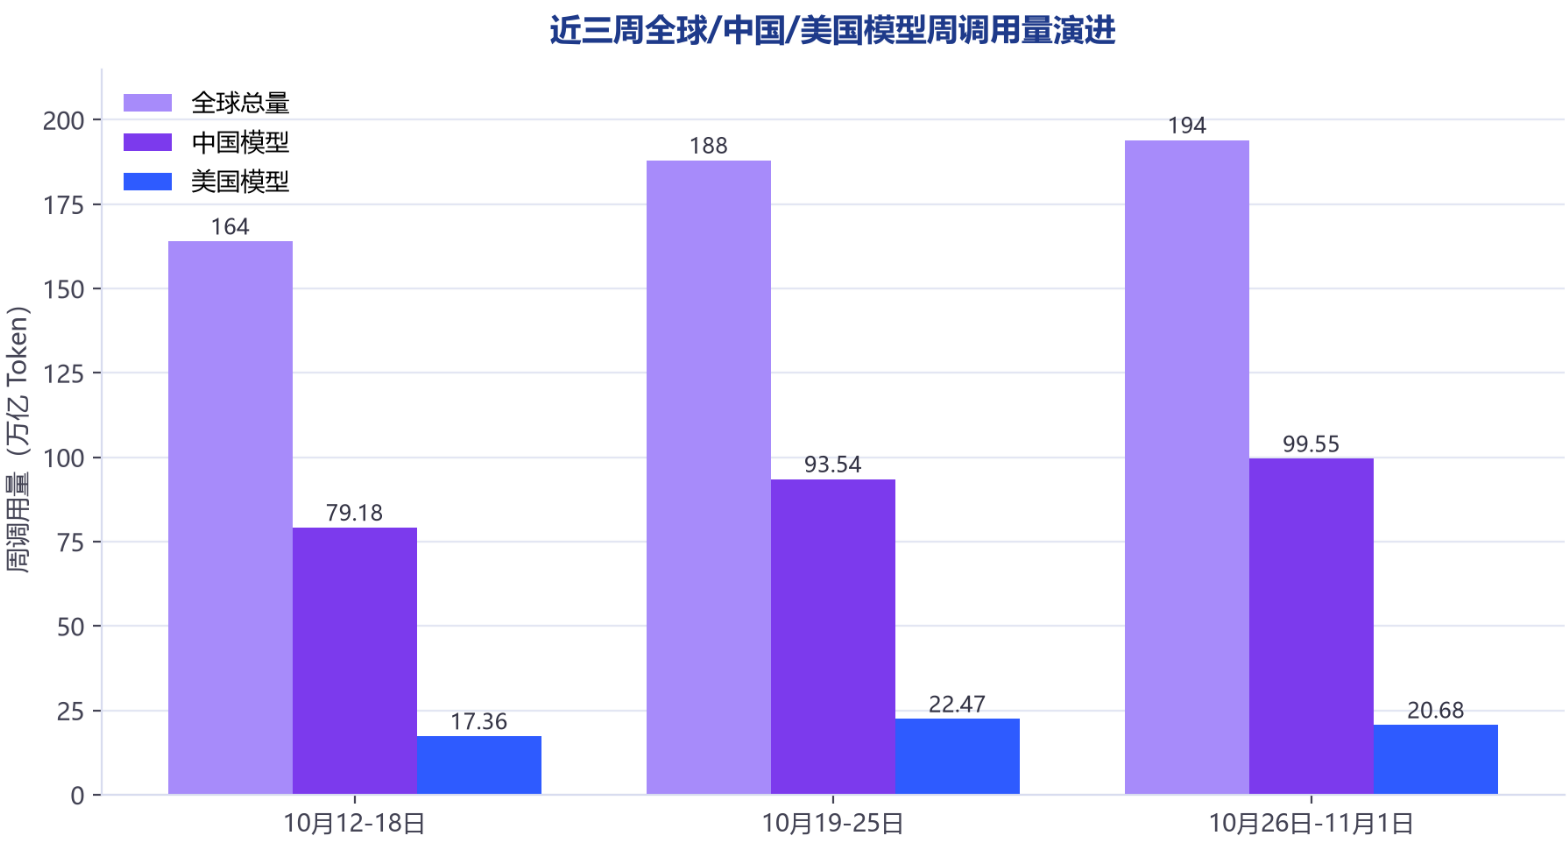
图1 近三周全球/中国/美国模型周调用量演进
二、榜单拆解:全球前五中国占四席,DeepSeek V4.1 Flash 1017蝉联第一
OpenRouter官方周榜显示,当周调用量前十位次为:DeepSeek V4.1 Flash 1017以48.1万亿Token居首,环比增长43%;智谱GLM 5.3 Flash以15万亿Token跃居第二,环比增长13%;DeepSeek V4.1 Flash(免费版条目)以14.9万亿Token位列第三,环比下滑17%;OpenAI的GPT-6 Luna以9.62万亿Token排名第四,环比增长15%,是前五名中唯一的非中国模型;腾讯Hy4 preview以9.07万亿Token位列第五,环比微增1%。
第六至第十位依次为:Anthropic的Claude Opus 5.5(6.73万亿Token,环比-19%)、阶跃星辰Step 5 Preview(6.25万亿Token,环比+72%)、MiniMax M3.1 Flash(6.23万亿Token,环比+690%)、OpenAI的GPT-5.6 Luna(4.33万亿Token,环比+155%)与智谱GLM 5.3(4.23万亿Token,环比-16%)。前十中中国模型占七席、美国模型占三席。
榜首模型的放量逻辑清晰可循。DeepSeek于10月17日官宣更新V4.1 Flash 1017,以9月10日发布的V4.1 Flash为基底,采用基于自反馈的强化学习训练技术,重点改善推理、编程、自动化与视觉任务表现;该模型延续552B总参数、输入激活8B、输出激活16B的非对称混合专家(MoE)架构,模型权重以MIT协议开源,API定价维持不变——闲时每百万Token输入0.15美元、输出0.60美元,高峰时段加倍。DeepSeek口径下,新版本在Terminal-Bench 4.0上得分从31.2提升至42.3,ProgramBench从20.3提升至29.1,Humanity's Last Exam从36.8提升至42.6,DeepSWE v1.1达到77.0。
与新版激增形成镜像的是旧版分流:上周(10月19日至25日)旧版V4.1 Flash周调用量环比下滑45%,本周继续下滑17%,开发者正快速向性能更优、价格不变的1017版本迁移。智谱GLM 5.3 Flash本周跃居第二,显示该版本在迭代优化中获得更多开发者认可;腾讯Hy4 preview则已连续多周稳居前五,体现出企业端场景的稳定调用黏性。
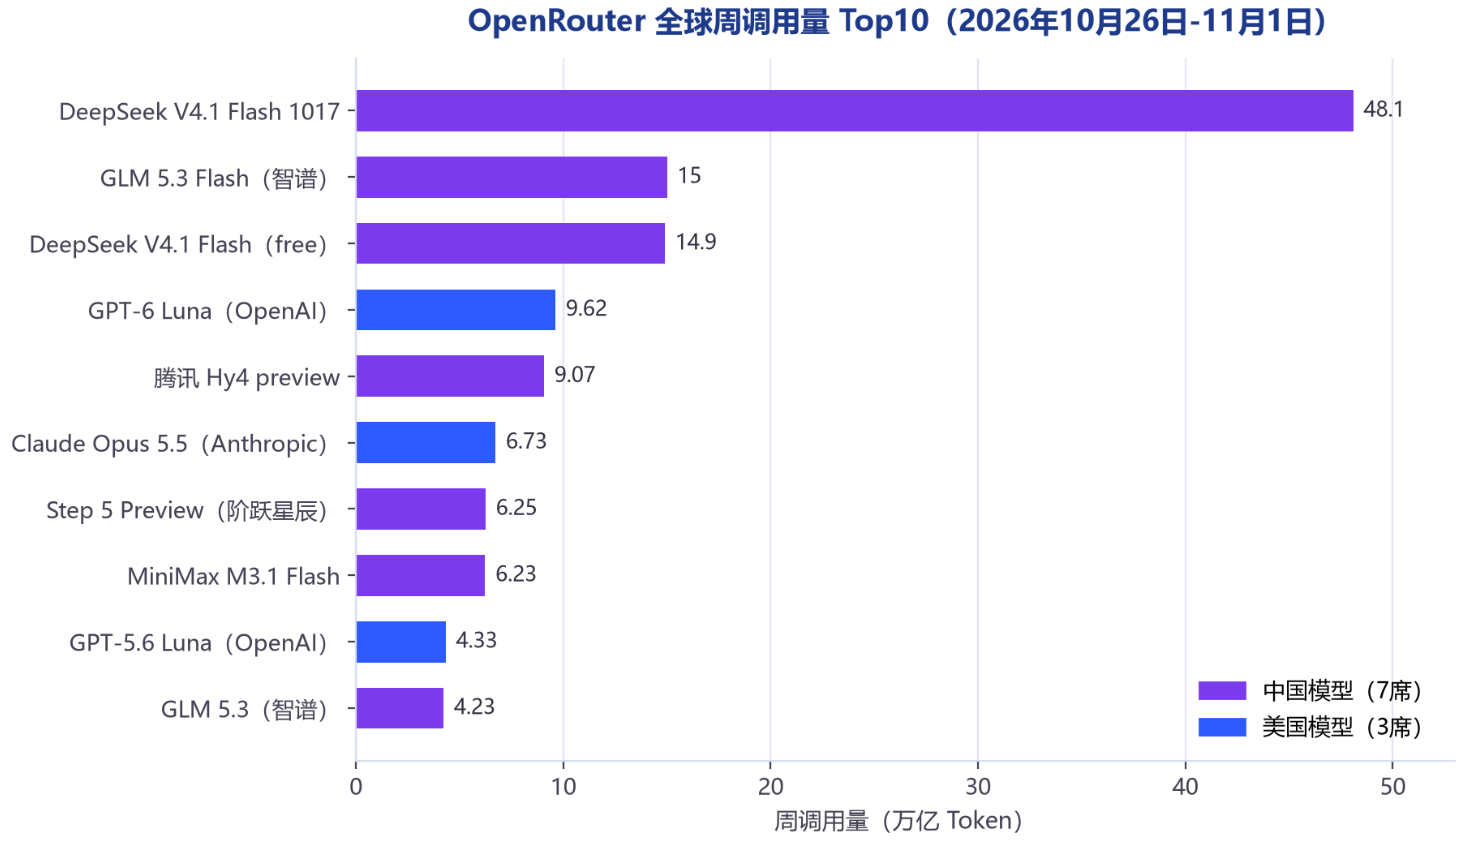
图2 OpenRouter全球周调用量Top10(2026年10月26日-11月1日)
三、连续27周:中美份额结构的数据纵深
把时间轴拉长,本周的领先并非孤立事件。此前两周的数据依次为:10月12日至18日当周,全球总量164万亿Token,中国模型79.18万亿、美国模型17.36万亿,中国连续第25周领先,前五均为中国模型;10月19日至25日当周,全球总量188万亿Token,中国模型93.54万亿(约49.8%)、美国模型22.47万亿(约11.9%),中国连续第26周领先,前五仍全部为中国模型。
增速层面曾出现错位信号:上周美国模型环比增速29.44%,一度高于中国模型的18.14%,但22.47万亿对93.54万亿的基数差距悬殊,增速追赶尚未改变总量格局;本周美国模型环比转跌7.97%,中国模型则续增6.43%,份额差距进一步拉开至约51%对约10.7%。周度起落频密,也说明调用侧竞争仍处于动态拉锯之中。
榜单座次的周度更替同样剧烈:本周MiniMax M3.1 Flash新进第八,此前一周排名第八的小米MiMo-V2.6-Flash(6.07万亿Token)与排名第九的英伟达Nemotron 3 Ultra(free)(5.85万亿Token)双双跌出榜单。榜首模型自身亦经历“版本交接”——10月12日至18日当周的榜首仍是旧版V4.1 Flash(32.8万亿Token),10月17日版本更新后,1017快照以33.6万亿、环比801%的增幅在次周登顶,本周续增至48.1万亿。
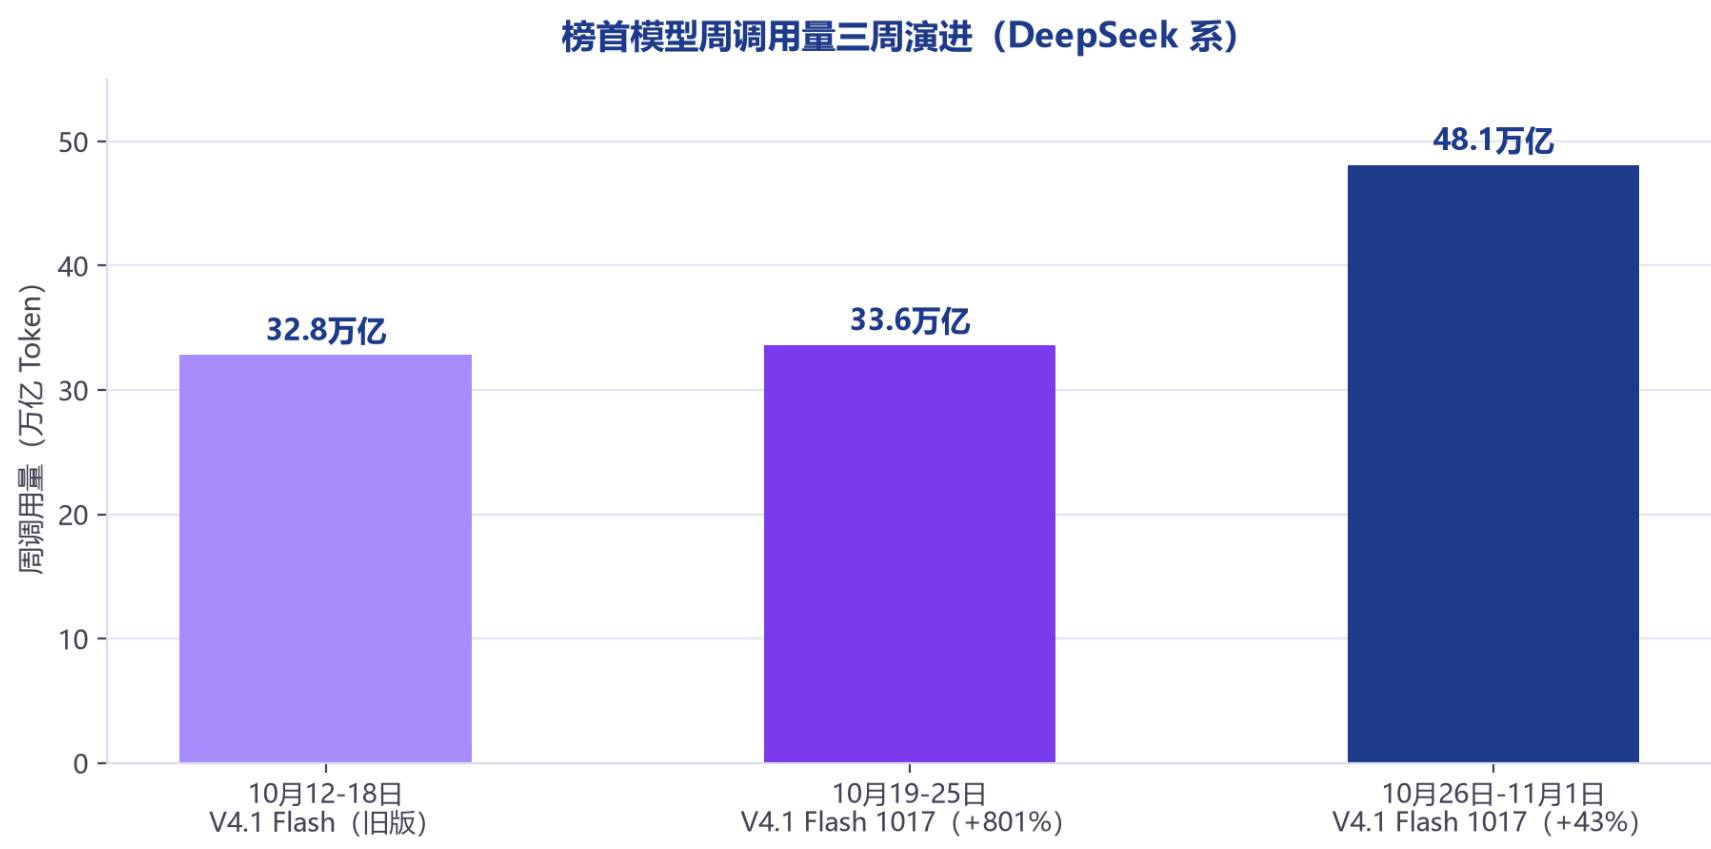
图3 榜首模型周调用量三周演进
四、新晋变量:MiniMax M3.1 Flash新进第八
本周榜单最大的增量变量来自MiniMax。10月19日晚,MiniMax(港股代码00100)正式发布新一代Flash模型M3.1 Flash,并对外认领:此前在OpenRouter与OpenCode上匿名运行、刷屏开发者社区的“太空兔”(Space Bunny),正是该模型的早期版本。据OpenRouter披露,太空兔在该平台连续10天位居模型使用量榜首、累计处理56.7万亿Token;OpenCode口径为其连续12天第一、服务106万亿Token;MiniMax官方称其匿名运行期间累计处理超过200万亿Token——三组数字分别对应不同平台与统计时段,不可直接相加。
技术规格上,M3.1 Flash为原生多模态混合专家模型,总参数428B、每个Token激活约23B,支持100万Token上下文与五档推理深度调节;官方披露其线上推理速度较前代提升近3倍、日常输出速度可达200+TPS,智能体类任务综合使用成本较前代降低70%。API定价为每百万Token输入1元、输出4元、缓存读取0.1元(官方美元口径为0.15/0.60/0.015美元),较上一代M3输入输出单价下调50%以上、缓存读取下调超70%。10月23日,MiniMax开放模型权重,官方称上线72小时内已为真实用户处理超过100万亿Token;华为昇腾、平头哥、昆仑芯、摩尔线程、英伟达、AMD等芯片厂商及Together AI、Fireworks、Nebius等平台宣布首日接入。
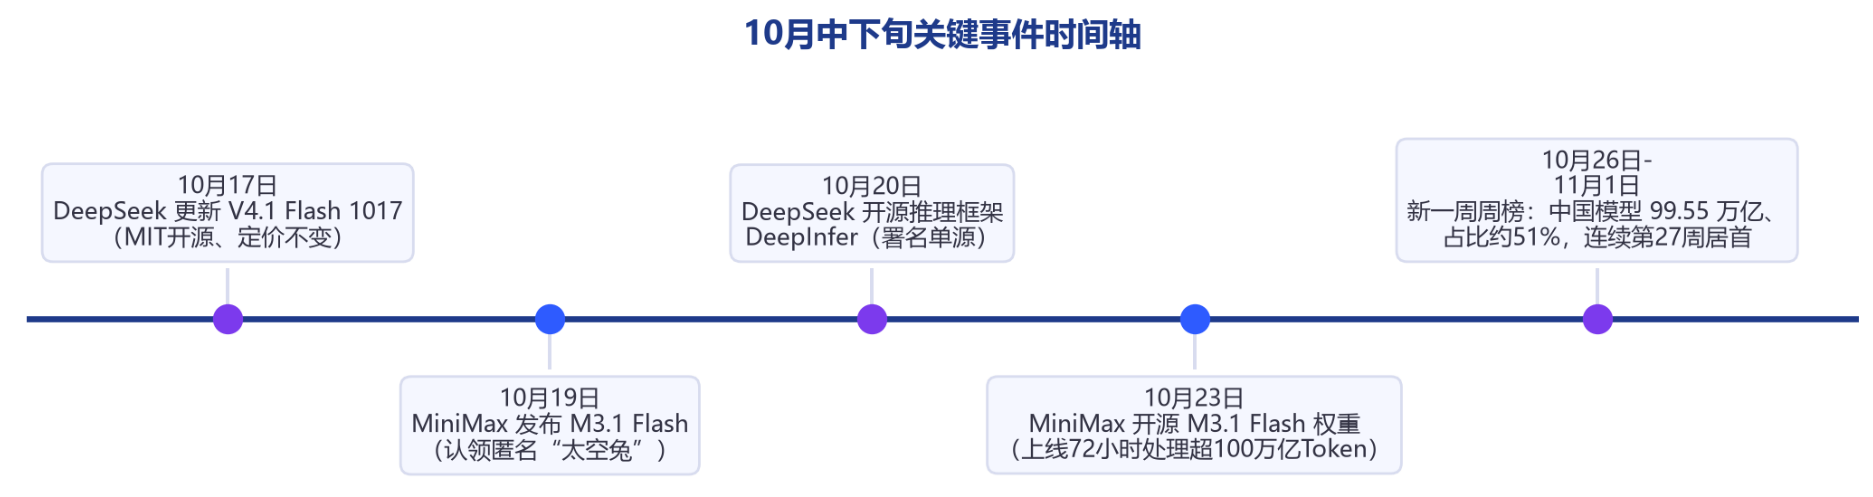
图4 10月中下旬关键事件时间轴
五、风向标与数据边界:OpenRouter榜单的参考价值
一个聚合渠道的周榜之所以被反复引用,源于OpenRouter在开发者生态中的枢纽地位。该平台创立于2023年初,创始人为OpenSea联合创始人、前CTO Alex Atallah,定位为统一API网关与模型市场:开发者通过单一接口即可调用400多个模型,平台接入60余家供应商,注册开发者超过800万。2026年5月,OpenRouter完成1.13亿美元B轮融资,由Alphabet旗下CapitalG领投,估值约13亿美元;8月17日,支付巨头Stripe宣布完成对其收购,据彭博社报道交易价格超过70亿美元。
但榜单口径的边界必须正视。OpenRouter仅统计经由其网关中转的Token量,OpenAI与Anthropic等厂商的调用主要经由自有渠道完成,云平台托管与私有化部署亦不计入,因此其数据不能直接等同于全球市场份额;有行业测算指出,该平台周调用量仅占全球总量的很小比例,且平台用户结构中美国用户占比近半、英语内容占绝对主导。官方亦在页面上提示数据的参考属性。
因此,对本周榜单的合理读法是:它度量的是全球开发者在可随时替换、价格透明的模型之间的真实选择,是“显示性偏好”的风向标,而非厂商收入或全球算力消耗的普查数据。单一一周的座次不宜过度引申,连续27周的趋势性与结构性变化才是更可靠的信号。
六、驱动因素:性价比与低价放量逻辑
中国模型在开放聚合渠道持续放量的第一重动因是价格杠杆。DeepSeek V4.1 Flash 1017在能力升级的同时维持闲时每百万Token输入0.15美元、输出0.60美元的定价,官方称其在多个控制框架下达到“性能-费用帕累托最优”;MiniMax M3.1 Flash将每百万Token输入压至1元、输出4元,较前代降价一半以上。对调用规模敏感的Agent与批量处理场景而言,单次调用成本的下降会直接放大调用量。
第二重动因是供给侧的架构降本。DeepSeek的552B总参数、8B/16B输入输出激活的非对称MoE设计,以小规模激活参数支撑大规模总参数,在保持能力上限的同时压低单次推理成本;MiniMax的全模型稀疏注意力架构则大幅削减长上下文场景的注意力计算开销。10月20日,DeepSeek还开源了内部推理框架DeepInfer及生产级词元编解码组件,进一步降低第三方渠道的部署门槛。
第三重动因是开源策略带来的渠道面扩大。开放权重使中国模型可被OpenRouter等第三方平台及各类云渠道自由分发,渠道触达显著大于闭源模型。据英国《金融时报》报道,为降低技术成本,DoorDash、爱彼迎、西门子等大型企业已转向中国AI模型;另有美国投资机构数据显示,多达80%的美国AI初创公司在融资路演时使用中国开源模型。
七、负载结构:Agent与高频场景主导的调用选择
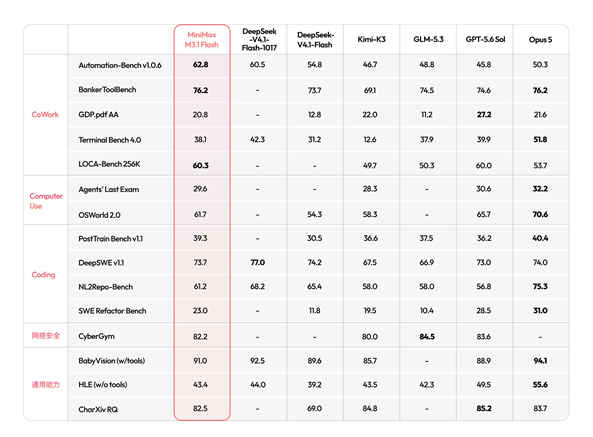
从负载结构看,本轮放量高度集中于Agent与编程场景。MiniMax将M3.1 Flash明确定位为面向工程级智能体与高频开发场景的模型,聚焦工具调用、多子智能体协同与跨软件操作;MiniMax官方口径下,其在Automation-Bench v1.0.6得分62.8、DeepSWE v1.1得分73.7,与DeepSeek V4.1 Flash 1017的77.0(DeepSeek口径)构成国产“Flash双子星”在任务级标尺上的贴身竞争。阶跃星辰Step 5 Preview本周环比增长72%升至第七,该模型于9月20日发布、10月8日上线OpenRouter,定位面向真实世界Agentic任务的旗舰基座。
竞争标尺亦随之迁移:从训练侧跑分转向调用侧的“单位Token成本下的有效产出”。在Agent工作流中,输出长度与任务运行时间直接影响账单,这也是DeepSeek 1017版本强调“更短输出、更快完成”、MiniMax强调“Agent任务综合成本降至前代三成”的原因。调用侧数据由此成为衡量模型实用性的实时投票,而不仅是能力上限的证明。
八、格局推演:从调用量份额到市场格局的距离
调用量份额的领先并不自动等于商业价值的领先。研究机构Epoch AI于10月6日发布的报告估算,阿里巴巴、字节跳动、智谱、月之暗面、DeepSeek与MiniMax六家中国头部公司年化AI相关收入合计约110亿美元,仅约为OpenAI与Anthropic合计1050亿美元的10%(该估算基于2026年6月至9月不同时点的年化口径,并非完整财年实际收入)。华尔街见闻的复盘亦指出,国内头部AI公司合计收入仅相当于硅谷两家头部公司的一成多。
开源权重模型还存在“采用扩张、收入不同步”的结构性问题。智谱2026年8月开放GLM-5.3 Flash权重后,20天内由智谱自身提供服务的Token占比从88%降至22%,模型总体使用量增长17%,但智谱自身的日Token调用量下降70%——模型被广泛采用,并不必然带来开发商收入的同步增长,相当部分流量价值流向了分发渠道。
综合来看,本周榜单确认了三个事实:其一,中国模型在开放调用侧的领先已由偶发转为周期性常态,连续27周的记录意味着其已进入全球开发者的日常工具箱;其二,领先的主要支点是“够用能力+低价+开源+周级迭代”的组合,而非单一能力代差——Artificial Analysis于10月28日发布的Intelligence Index v5中,DeepSeek-V4.1-Flash-1017综合得分为32分,低于Claude Opus 5.5的58分,调用第一不等于技术全面领先;其三,流量优势向收入优势的转化,是下一阶段中国模型厂商的核心命题,花旗关于“中国AI竞争焦点正加速转向端到端智能体工作流与推理成本效率”的判断,指向的正是这一转换机制。
后续观察窗口有三:DeepSeek V4.1 Flash 1017调用量激增的留存情况、MiniMax M3.1 Flash在高位放量后的座次稳定性,以及各厂商Flash级新品的下一轮排位更替。对产业观察者而言,OpenRouter周榜及其口径边界,仍将是跟踪全球调用侧竞争的基础坐标。