一句文字提示生成可实时“导演”的虚拟世界,一致场景时长翻倍至约两分钟——谷歌世界模型路线的当前最高点与未解边界。
美东时间2026年10月27日(周二),谷歌DeepMind发布新一代通用世界模型Genie 4研究预览版:用户以一句自然语言提示即可创建可实时操控探索的虚拟世界,并可在外观运行过程中继续用文本指令改变天气、移动镜头、添加人物或物体;该模型还是DeepMind首个原生同步生成音频的实时世界模型,环境音、音乐与交互式对话随画面同时产生。谷歌首席执行官皮查伊称其为谷歌迄今最逼真、最具互动性的世界模型。目前该模型已向小范围受信测试者开放,未来几周将登陆AI Ultra订阅用户的Project Genie及Gemini API与Google AI Studio早期访问合作伙伴。
一、发布事件:一句提示生成一个可操控的世界
根据谷歌官方博客与DeepMind官方博客(作者Raia Hadsell、Diego Rivas、Hang Qi)发布的公告,Genie 4定位于“为实时交互式模拟带来前所未有的真实感与原生音频”的世界模型。用户可以使用标准键盘控制进行导航与相机操作,同时用自然语言提示设定并引导场景演进;更重要的是,模拟不需要“生成完再重看”——用户可以在场景运行过程中持续输入指令,实时改变天气、移动镜头、引入新的人物或物体,模型会结合当前场景上下文适配指令,使变化自然融入世界,而无需从头重新生成。
与只能生成固定视频内容的传统文本生成视频模型不同,世界模型(World Model)能够根据用户的实时操作持续生成和调整虚拟场景。这一能力分野也被资本市场高度关注:据智通财经、新浪财经等多家媒体报道,今年1月谷歌首次推出由Genie 3驱动的Project Genie原型产品时,投资者担忧AI生成式虚拟世界可能颠覆传统游戏开发流程,多家游戏相关企业股价当时出现大幅下跌。此次Genie 4进一步提升实时交互与多模态生成能力后,市场对游戏内容生产方式变革的关注再度升温。
在官方演示中,Genie 4生成了薄雾湖面的萨克斯演奏者、20世纪80年代的日本火车站、彩绘玻璃景观等场景;测试者可以用键盘在其中游历,并随时“介入导演”。谷歌同时强调,该模型仍是实验阶段的早期研究产品:随着模拟运行时间延长,画面细节和物体可能出现偏移或漂移。
二、Genie系列沿革:世界模型路线的三级台阶
从系列沿革看,Genie 4的发布是谷歌世界模型路线的第三级台阶。第一级是今年1月:谷歌推出由Genie 3驱动的Project Genie原型产品,首次把世界模型能力以可体验产品的形态推向受信用户,也首次引发产业界对其颠覆游戏开发方式的大范围讨论。第二级是Genie 3本体能力:据谷歌向媒体披露的信息,Genie 3的一致场景时长约为1分钟,且仅生成画面。第三级即Genie 4:一致场景最长可持续运行约两分钟,约为上一代的两倍,并首次实现声音与画面的原生同步生成。
底座模型侧的铺垫同样构成时间线的重要节点:据至顶智库《2026全球人工智能展望报告》及Google AI开发者平台版本说明,谷歌于5月19日推出多模态模型Gemini Omni(支持以自然语言编辑视频、每条指令以前一条为基础,其衍生产品Gemini Omni Flash于8月27日转正);9月2日正式发布轻量级主力模型Gemini 3.8 Flash,定位长周期软件工程、自主智能体与复杂企业工作流。10月27日,Genie 4正式亮相,直接集成Gemini家族的多模态推理能力。
表1:Genie 3与Genie 4关键能力对照
对比维度 | Genie 3(上一代) | Genie 4(研究预览) |
一致场景时长 | 约1分钟 | 约2分钟(约为上一代两倍) |
音频生成 | 无原生音频 | 首次原生同步生成:环境音、音乐、交互式对话 |
实时编辑 | 有限 | 运行中实时改变天气、移动镜头、添加人物或物体 |
物理与角色 | 基础物理模拟 | 空气动力学、碰撞等更真实物理;角色动作更自然、可实时引导 |
架构协同 | 单一模型生成 | Gemini Omni锚定外观与行为;Gemini 3.8 Flash在环引导 |
三、核心能力拆解:实时编辑、声画同步与物理逼真度
实时编辑是Genie 4最直观的能力跃迁。据DeepMind官方博客,用户可以用自然语言在模拟运行中修改世界——改变天气、移动相机、引入新的人物或物体;Gemini会将用户提示结合上下文适配到周围场景,并在多次输入之间持续监控和引导场景,以保持世界连贯推进。Digital Trends的报道将其概括为:AI在不重启世界的前提下“中途”完成编辑。
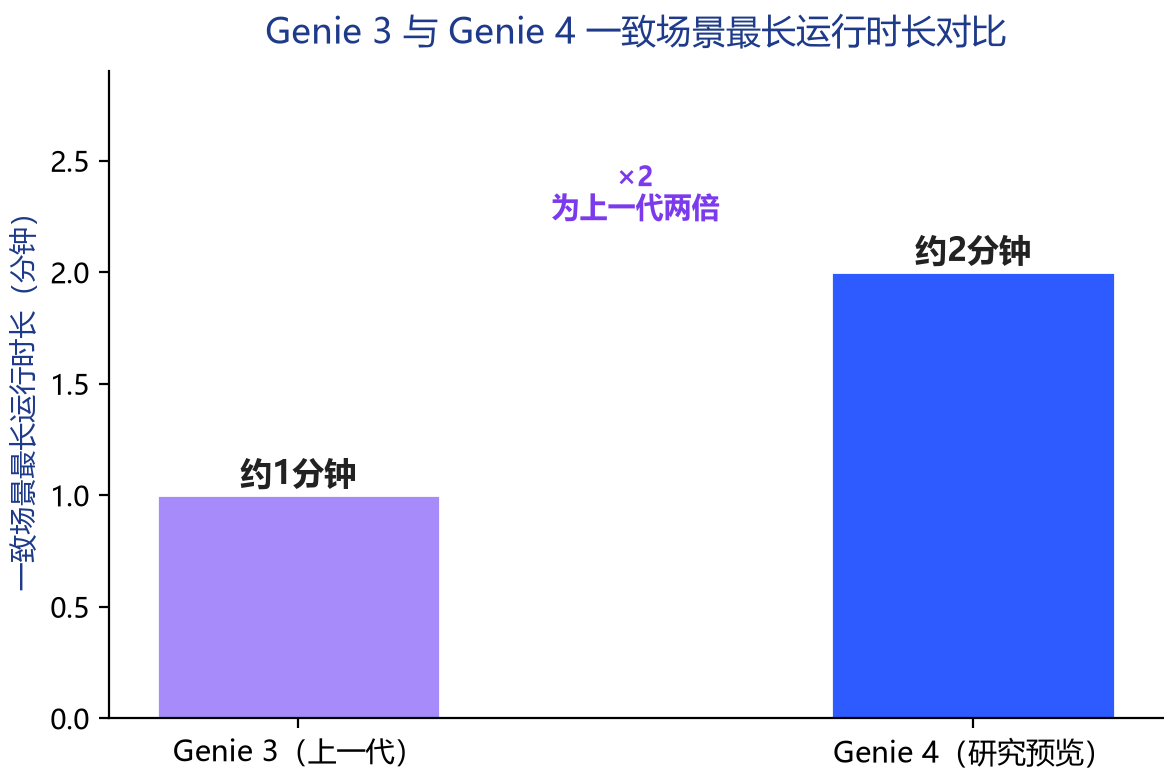
图2:Genie 3与Genie 4一致场景最长运行时长对比(约1分钟→约2分钟)
声画同步是本代产品的“首次”。Genie 4是DeepMind首个在实时世界模拟中原生生成音频的模型:音乐、环境音(如风声、海浪)与画面在同一过程中同时产生,且支持能够对用户行为和场景事件实时作出反应的交互式对话。官方将实时场景导演、先进物理与运动、原生音频生成、复杂多步模拟并列为四大技术突破。Times of India的报道评价称,正如真实感对话曾是AI视频的转折点,交互式世界的原生对话可能正在开启类似的拐点。
物理与角色逼真度方面,官方称Genie 4基于对世界的先进物理理解,可模拟空气动力学、碰撞、环境阻力等真实世界物理场景;人物角色移动更自然、能对环境作出有机反应,并可被实时交互引导。受信测试者的实际用途也印证了能力边界:影视从业者将其作为预可视化阶段的快速“草稿模式”,实时多次“开拍”并即时调整机位、灯光、对话与动作;新闻摄影师将单张2D档案照片在数秒内变为该环境的可探索实景模拟,用于体验历史空间或可视化山洪、野火等短期环境事件;游戏开发者则在不编写引擎代码的情况下,数秒内将想法转化为可探索原型。
四、双引擎架构:Gemini Omni的世界先验与Gemini 3.8 Flash的实时引导
Genie 4并非独立的图形引擎,而是直接集成了谷歌Gemini家族的多模态推理能力,形成“生成+推理”的双引擎结构。第一个引擎是Gemini Omni:按官方表述,它将每个模拟“锚定在真实世界的外观与行为上”(anchors simulations in real-world appearance and behavior),为虚拟世界提供现实世界外观、物理动态与视觉连续性的基础先验。
第二个引擎是Gemini 3.8 Flash:它在生成回路中充当“实时引导智能体”(guiding agent in the loop)。当Genie 4逐帧渲染世界时,Gemini 3.8 Flash持续观察新生成的画面,理解用户希望完成的目标,将其分解为一系列具体步骤,逐帧检查相关操作是否已经实现,并随场景变化或用户干预即时调整计划——由此实现官方所称的“可靠因果性、程序化行为与多步推理”。Digital Trends将其概括为“把你的目标拆成步骤、并在生成时逐帧检查”。
架构细节中还有一个值得注意的信息点:谷歌研发团队曾尝试使用能力更强的Gemini 4 Argon承担引导角色,但当前Genie 4的实时交互体验由计算效率更高的Gemini 3.8 Flash驱动——实时性优先于模型上限,是这一产品形态的明确工程取舍。在机器人研究实验中,两个模型形成分工示范:Gemini 4 Argon将任务分解为多个步骤,再由Genie 4进行实时模拟,实验中模拟了Apptronik的Apollo人形机器人下跳棋的场景。谷歌研究总监Tejas Kulkarni在媒体吹风会上表示,未来将越来越多地看到这种“混合式世界模型”——把Gemini编写代码和文本的能力,与Genie实时接收这些内容并在不同抽象层次上模拟现实的能力结合起来。
五、发布节奏与商业路径:从受信测试者到订阅与API生态
Genie 4采用分级开放路径:当前以研究预览形式向一小批受信测试者开放(包括影视预可视化创作者、游戏开发者与机器人训练团队);未来几周,将通过Project Genie向Google AI Ultra订阅用户开放,并向Gemini API与Google AI Studio的早期访问合作伙伴开放,候补名单已经开放。皮查伊于10月27日在其个人账号发布推文:“Excited to share Genie 4 today—our most realistic and interactive world model”,并列举实时操控动态环境、生成与世界匹配的原生音频、模拟照片级场景与真实物理、经Gemini推理创建更连贯多步事件四大要点。NDTV Profit与Times of India均全文引述了该推文。
商业细节上,据Digital Trends报道,消费者访问将从每月100美元的AI Ultra最高档订阅开始,AI Pro与AI Plus档位可能随后跟进;开发者渠道经Gemini API与AI Studio接入,但定价尚未确认。这一节奏延续了谷歌近年“研究预览→受信测试者→订阅分层→开发者生态”的产品化打法:先以小范围验证打磨体验与安全护栏,再借订阅体系与API将能力转化为生态入口。
官方口径的定位亦值得记录:谷歌在官方博客中称,理解与模拟世界是构建AGI的关键方面,Genie 4可为机器人和智能体提供安全的训练环境,并“放大影视、新闻、游戏和制造等行业的创作工具”。
六、行业应用与谷歌的战略纵深
官方点名的四大行业各有清晰的切入逻辑。影视:世界模型充当“零成本试拍”的预可视化工具,把构思与分镜阶段的试错成本从摄制环节前移到提示词环节,DeepMind工程师Diego Rivas在媒体吹风会上表示,“实时功能最大的价值在于让创作者保持流畅的创作状态,例如构思和分镜阶段”。新闻:档案照片的场景化重建为历史报道与灾害事件可视化提供新形态,但同时也对新闻真实性与内容标识提出更高要求。游戏:从今年1月Project Genie引发游戏股下跌的市场反应看,该行业受到的预期冲击最直接——原型设计与概念验证环节可能被显著压缩。制造:与机器人训练、仿真测试同源,世界模型可为工业场景提供“零到一”的快速场景生成。
从谷歌自身战略看,Genie 4的纵深价值有三层。其一,模型矩阵协同:Genie 4复用Gemini Omni与Gemini 3.8 Flash,使世界模型成为Gemini生态的“能力出口”而非孤立产品——世界模型与多模态能力长期被视为谷歌相对OpenAI、Anthropic的技术长板。其二,订阅拉动:作为AI Ultra最高档订阅(每月100美元)的专属能力之一,Genie 4为高阶订阅提供了具象的价值锚点。其三,开发者生态:经Gemini API与AI Studio开放后,世界模型被放入谷歌现有开发者工具链,与Veo(AI视频生成模型)形成“视频生成—交互世界”的产品谱系。
市场层面的竞争背景是:谷歌在AI前沿领域面临OpenAI与Anthropic的激烈竞争,其近期发布的Gemini 4 Argon被认为有助于缩小差距;而Genie 4接连亮相,被多家媒体解读为谷歌在前沿竞争中“重新提速”的信号。
七、竞争坐标与风险变量
世界模型赛道已从单一玩家进入多路线竞逐。最直接的对手是NVIDIA:今年6月1日,NVIDIA在GTC台北大会上发布Cosmos 3——基于Mixture-of-Transformers(混合Transformer)架构的物理AI开放世界基础模型,原生支持文本、图像、视频、环境声音与动作的全模态理解与生成,并联合Agile Robots、Black Forest Labs、Runway、Skild AI等组建Cosmos联盟(黄仁勋称“物理AI的‘大爆炸’时代即将来临”)。国元证券10月21日发布的行业专题研究将世界模型视为“重塑智能底层范式”的赛道,指出具身智能算法架构正经历从VLA(视觉-语言-动作)模型向世界-动作模型(WAM)的范式跃迁。与Cosmos 3聚焦物理AI训练数据与策略模型不同,Genie 4的差异化重心在“实时可交互+声画同步”的体验侧。
风险变量同样清晰。第一是技术边界:官方明确承认,模拟时间延长或多次编辑后,视觉细节与物体恒存性可能漂移;复杂物理交互、实时音频准确性、画面内文字清晰可读、空间准确性与长期一致性仍是“活跃的持续研究领域”——这决定了短期内世界模型难以真正取代成熟游戏引擎。第二是算力成本:实时逐帧生成声画意味着持续的高强度推理,Gemini 3.8 Flash替代Gemini 4 Argon承担引导角色的取舍已说明实时性对算力效率的敏感;API定价未确认,也反映成本模型尚未定型。第三是治理约束:可实时生成并编辑的逼真世界天然放大深度伪造风险,谷歌的应对是内置安全护栏并让所有生成的视频与音频内容携带SynthID数字水印(覆盖视觉与音频模态),监管层面的内容标识要求(如中国《人工智能生成合成内容标识办法》所代表的合规方向)将成为此类产品的通用约束。第四是商业不确定性:Diego Rivas在媒体吹风会上反复强调,Genie 4仍处早期阶段,最终端到端的产品体验尚不清楚。
八、结语:世界模型竞赛进入声画时代
Genie 4的发布把世界模型的竞争标尺从“画得像”推进到“听得见、改得动”:原生声画同步与运行中实时编辑首次合流,一致场景时长翻倍,双引擎架构把推理模型嵌入生成回路。但官方同步展示的能力边界——两分钟时长、细节漂移、音频与文字准确性待解——同样清晰地划定了从演示到可用产品之间的工程距离。
对本稿观察主线的最终归结是克制的:Genie 4的实际表现有待受信测试者与AI Ultra订阅用户开放后的验证,API定价、更广泛的开放时间表均未落定;世界模型的产业影响最终取决于开发者与行业用户的实际采用,以及NVIDIA Cosmos等竞品路线的演进速度。可以确定的是,随着谷歌、英伟达等玩家在同一赛道的密集出手,世界模型竞赛已经进入声画同步、实时可编辑的新阶段。