未启动租约承诺总额 | 2032年容量目标 | 商业RPO同比 | 2026自然年资本开支 |
3291亿美元(环比+67.4%) | 约12GW → 38GW以上 | +84%(至6780亿美元) | 1900亿美元(账面约1750亿) |
导语:微软最近一个财季披露的单季新增数据中心租约承诺超过1300亿美元,尚未启动的租约总额一口气冲到3291亿美元。叠加“2032年前数据中心容量从约12吉瓦扩至38吉瓦以上”的扩容路线图,外界最关心的问题依然是那个朴素追问:微软到底要买多少GPU?但从微软业绩电话会与产业链披露的信号看,这道题已不能再用“每吉瓦配多少卡”的简单乘法作答——任务量增长、效率提升与自研芯片分流三重变量,正在把一道加法题改写为需要逐项求解的多元方程。
一、数字迷雾:两倍扩容与1300亿美元租约
先看规模之巨。微软在2026财年第四季度(截至2026年6月30日)披露,单季新增尚未开始执行的数据中心租约承诺超过1300亿美元(单季净增约1325亿美元);截至季度末,尚未启动的租约承诺总额达3291亿美元,较上一季度的1966亿美元环比增长67.4%,创公司史上最大单季租约承诺增幅。微软投资人关系负责人Jonathan Neilson表示:“这些承诺反映客户需求持续强劲,相关设施将在未来多年支援客户需求。”值得注意的是,部分合约须满足特定条件方可生效——承诺与落地之间,仍隔着一道执行闸门。
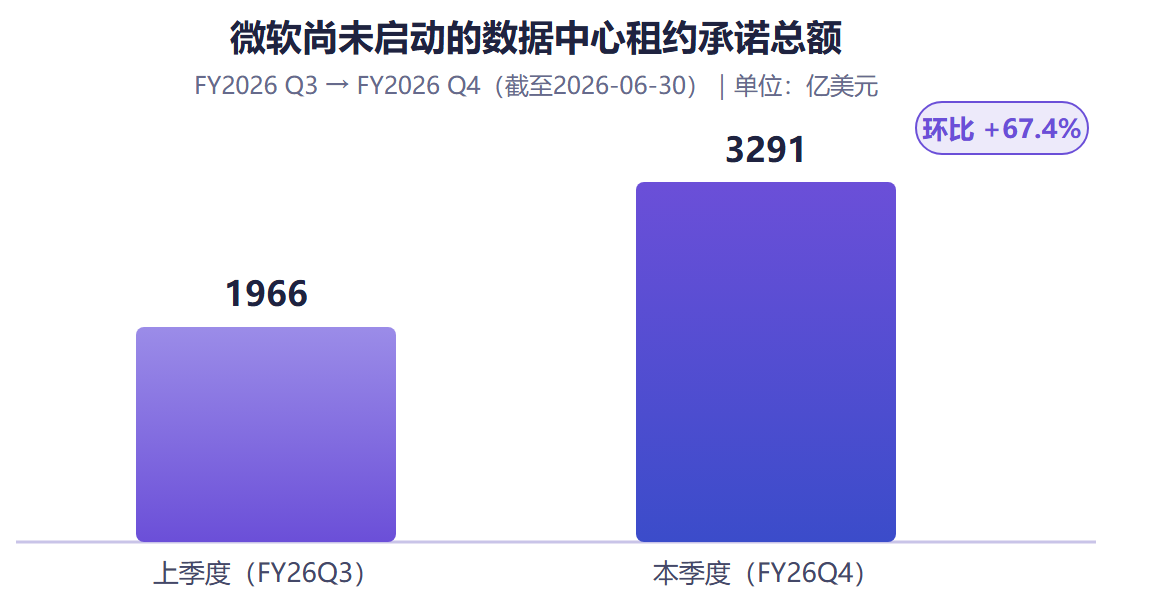
图1 微软尚未启动的数据中心租约承诺总额:1966亿 → 3291亿美元,环比+67.4%
再看容量目标。据彭博社2026年9月报道,并经微软10月监管文件相关报道(观点网、财联社等)印证,微软计划在2032年前将全球数据中心容量从目前约12吉瓦提高至38吉瓦以上(扩容逾两倍),以缓解迫使其拒绝部分AI与云业务的算力短缺;路线图涵盖自建与租赁设施,但不包括从CoreWeave等“新云”厂商租用的算力。微软发言人弗兰克·肖曾称9月报道中的规划数字“不准确”,但拒绝提供财报披露之外的数据。另据彭博报道,当前约12吉瓦容量中仅约2吉瓦用于AI专用芯片——这一口径微软方面未予确认,仅供参考。
资金端同样在加码。微软2026财年(截至2026年6月30日)资本开支高达1450亿美元;在2026财年第四季度业绩电话会上,CFO艾米·胡德维持2026自然年1900亿美元的资本开支投资预期,但因数据中心和办公楼使用寿命从15年延长至25年、更多租赁由融资租赁转为经营租赁(经营租赁不计入资本开支),账面指引调整至约1750亿美元,并明确表示“在此使用寿命影响之外,我们对2026自然年资本开支的投资预期保持不变”(微软FY26Q4业绩电话会,2026年7月29日)。两个口径需区分表述:1900亿为实际投入预期,1750亿为会计调整后账面值。
扩容的紧迫性来自缺口本身。由于算力供应吃紧,微软已在美国、欧洲等主要市场限制部分新云服务订阅;据知情人士,部分客户因无法在所需地区取得额外容量转而与竞争对手签约。微软在2025年大部分时间曾暂停部分数据中心开发与租赁活动,如今重新启动并扩大租赁规模。一边是限制订阅、客户流出的现实压力,一边是创纪录的租约承诺——扩容竞赛,已从“要不要买”进入“买多少、怎么买”的精细化阶段。
二、换算链条:从任务量到GPU小时
回到“要买多少GPU”的算术本身。一个可用的分析框架是把需求拆解为四个变量:GPU小时需求 = 任务数量 × 单项任务有效计算量 × GPU承担份额 ÷ 单位设备处理能力。这一链条的意义在于,GPU采购量不是由任何单一变量决定,而是四个变量相乘相除的结果——分子端任何一项高增,都可能被分母端的效率跃升大幅抵消。
变量间的敏感性不容小觑。以一组演示为例(假设示例,非微软实际数据):若任务数量增长80%、单项任务计算量增长40%、设备效率翻倍、GPU承担份额下降20%,四项相乘相除后GPU小时需求仅增长约0.8%。数字未必精确对应现实,但它揭示了关键一点:即便AI任务量成倍增长,若软件优化与硬件效率同步跃升,GPU小时需求也可能近乎持平;反之,只要GPU承担份额上升,需求曲线就会陡然抬升。
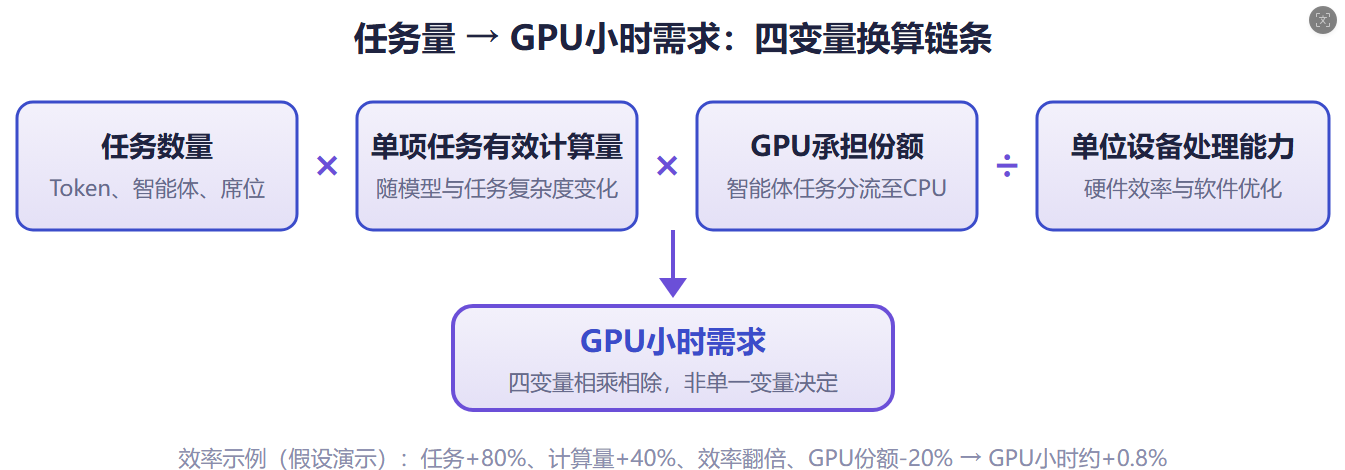
图2 任务量 → GPU小时需求:四变量换算链条(效率示例为假设演示,非微软实际数据)
微软自己披露的数据,恰好为这条链条的两端提供了注脚。分子端的“任务量”在放量:年化Token运行率达到1万亿Token的Foundry客户数量同比增长四倍;模型目录超11000个;Agent 365上线2个月注册近4000万个智能体;M365 Copilot付费席位超3000万(净增环比翻倍);GitHub Copilot用户达5000万,按用量计费后收入环比加速增长超60%。
分母端的“效率”同样在飙升。纳德拉表示,自年初以来Copilot工作负载吞吐量提升4倍,单次对话延迟降低25%,每位用户对话数量同比几乎翻倍。成本侧的优化更为激进:Maia 200与基础设施中最新一代硬件相比每美元性能高出30%;在Maia 200上运行MAI模型实现每瓦性能提升40%;Dynamics 365采用MAI Voice 2 Flash后GPU成本降低89%,PowerPoint采用MAI Image 25后GPU成本最高降低84%;GitHub Copilot使用MAI Code One Flash后中位Token使用量降低10%;多模型安全架构下90%的常规任务由轻量模型处理,同等防护效果成本降低50%。任务在涨、效率也在涨,这正是“GPU小时”这道题的麻烦之处——答案无法只看分子。
三、智能体改写分工:算力结构迁移
第二重变量藏在算力结构的迁移之中。AI智能体工作流下,GPU/TPU等AI计算芯片承接模型计算,高性能数据中心CPU承接工具执行与任务编排,HBM、服务器DRAM、存储、高性能网络与光互连共同支撑数据运输与状态管理。智能体一次请求可能触发多轮模型推理与程序执行——规划、检索、读文档、调用工具、执行代码、检查修正——形成间歇性与突发性并存的负载。英特尔将未来数据中心概括为三类集群:CPU集群负责智能体执行与编排,GPU服务器承担模型推理(“Token工厂”),存储集群承载数据。
这种分工不是理论推演,而是已现端倪的真实需求。英特尔数据中心集团相关负责人披露:“有客户要求10分钟之内做1万个沙箱,问我们怎么去做软件优化。”沙箱是供智能体执行代码和操作文件的隔离环境,其启动速度、运行效率和部署密度直接影响智能体服务表现。为此,英特尔至强6+最高提供288个能效核,单颗处理器最高支持超1000个智能体;在满足200毫秒沙箱启动时延条件下最多支持350个沙箱并发。
产品侧同样印证了“智能体跑在CPU上”的趋势。根据Meta公布的技术说明,每位Muse用户拥有专属云端虚拟机(Muse Secure VM),配备浏览器以及CPU、内存和存储资源,用于执行代码、运行工具并协调多个子智能体;实测配置约为2 vCPU、8GB内存及持久化存储,基于AMD EPYC平台,无本地GPU——推理在虚拟机之外完成(Meta技术说明及Meta超级智能实验室工程副总裁David Singleton确认)。换句话说,智能体工作负载正在大规模“吃”CPU与存储资源,而非直接堆GPU。
由此,英特尔CEO陈立武给出方向性判断:AI工作重心由训练转向推理,CPU与GPU配比正从1:8向1:1演进。另有研报转引称,微软Fairwater下一代数据中心已采用GPU与CPU集群分离设计。若配比演进成立,“微软要买多少GPU”的另一半答案其实在CPU与基础设施侧——GPU预算的增速,可能远低于总算力预算的增速。
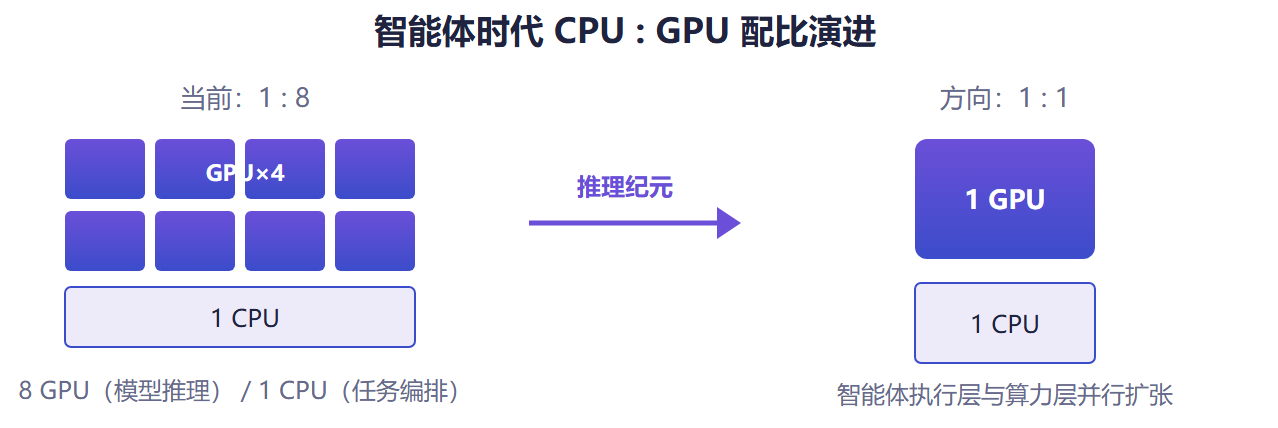
图3 智能体时代 CPU : GPU 配比演进(示意性演进方向,非精确比例)
四、自研分流:Maia 300与替代规模的验证缺口
第三重变量是自研芯片对英伟达GPU采购的分流。2026年10月12日,微软在OCP全球峰会期间发布第三代自研AI芯片Azure Maia 300,纳德拉称这是公司“迄今为止在自研芯片上最大的一笔押注”;微软计划从2027年起将Maia系列扩展至数吉瓦级部署规模,使其成为微软产品和服务的主要AI推理系统,2027年部署数量可能超过100万颗。消息公布当日,微软市值重返4万亿美元上方。
效率宣称是自研分流的核心论据。微软宣称Maia 300每兆瓦电力可处理的Token数量比“领先的GPU系统”高出约40%——但微软未披露用于比较的具体GPU系统型号,外媒普遍解读为对标英伟达。
机柜级参数提供了更硬的对照:每个Maia 300机柜计划容纳96颗芯片(为上一代Maia 200机柜的两倍),功耗约167千瓦,满配96加速器的机柜级Token吞吐量最高达Maia 200机柜的7倍;作为对比,英伟达最新GB300 AI服务器机架配备72颗GPU、功率约142千瓦。技术路线上,Maia 300采用多芯粒架构——关键计算芯粒采用台积电2纳米工艺与先进封装,数据搬移芯粒采用台积电3纳米工艺,搭载8组HBM4显存,单颗加速器峰值内存带宽18TB/s,热设计功耗950W,与英伟达“单颗巨型计算芯片环绕HBM”路线形成差异。
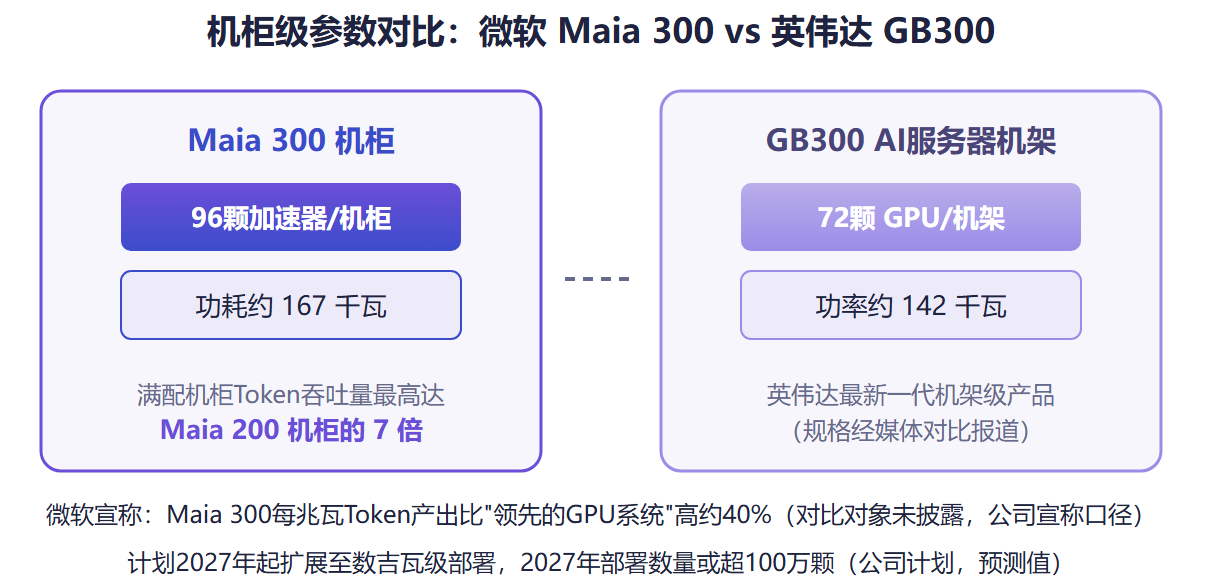
图4 机柜级参数对比:微软 Maia 300 vs 英伟达 GB300
落地上,前代产品已经跑通:Azure Maia 200已投入生产环境,承担包括Microsoft Copilot在内的生产工作负载,运行OpenAI模型、微软自研MAI模型及领先开源模型系列,已部署于美国、欧洲和澳大利亚数据中心;GitHub Copilot和Microsoft Foundry预计2026年底前跟进运行。微软Azure硬件系统与基础设施总裁拉妮·博卡尔同时明确:目前没有计划直接向云客户出租Maia芯片背后的计算能力——“我们自身的人工智能服务业务规模已经足够大,因此希望优先满足自己的需求”。自研算力优先内用,意味着分流的每一瓦都直接对应外采GPU的减少。
放到产业背景中看,这并非微软的孤例。谷歌、亚马逊、Meta、OpenAI、阿里等均在推出定制AI芯片,试图削弱英伟达对AI算力市场的掌控;亚马逊和谷歌自研项目早于微软、被认为领先;微软在训练侧仍与英伟达和AMD保持合作,Maia主要面向推理。行业普遍预期ASIC与GPU将形成异构算力分工:前沿模型预训练、强化学习与快速变化算子仍依赖GPU可编程性与CUDA生态,成熟模型、开源模型与智能体大规模推理则越来越适合专用芯片。
不过,分流规模仍存验证缺口:微软发言人曾称9月报道中的规划数字不准确,未提供官方口径,38吉瓦目标仍以媒体报道的监管文件披露为准,官方未直接确认;“每兆瓦Token产出+40%”的比较基准未公开;2027年“百万颗、多吉瓦”为公司计划而非已兑现事实。分流效应有多大,仍有待后续财报与部署数据验证。
五、产业启示:从“堆卡”到“算账”的五组跟踪信号
商业兑现侧的数据,为这道算术题提供了“验算纸”。微软FY26Q4商业剩余履约义务(RPO)同比增长84%至6780亿美元,约为微软FY2026全年营收(超3310亿美元,电话会口径)的两倍;计入OpenAI后RPO加权平均期限2.3年,其中约30%将在未来12个月内确认收入(同比+37%),未来12个月之后确认部分同比+112%;剔除OpenAI后RPO增长25%;本季RPO所有环比新增均来自前沿模型公司以外客户。需求扩张的广度与期限结构,比单一的资本开支数字更能说明问题。
供给节奏同样有了量化刻度:纳德拉表示,本季度新增1吉瓦容量,并有望在两年内将总容量大致翻倍;本季在五大洲新增31个数据中心,全年新增总数达88个;上一财年将大型区域新GPU从到货到上线的时间缩短近50%。而供需失衡短期难解:胡德称“过去多个季度我们一直强调客户需求持续超过现有算力供给,目前现状没有任何改变,现货算力市场的定价情况也能印证”;约三分之二的资本开支投向CPU和GPU等短寿命资产,需求变化时可灵活缩减。
综合三重变量,对“微软要买多少GPU”的审慎回答是条件式的:若任务量(Token、智能体、席位)延续当前增速、效率优化不出现平台期、自研芯片按计划于2027年上量,则外采GPU的增速将被效率与分流显著稀释,算力预算将更多流向CPU、存储与网络侧的智能体基础设施;反之,若智能体负载的间歇性突发特征推高GPU承担份额,或自研部署不及计划,外采规模仍将被动放大。建议跟踪五组信号:其一,租约与RPO的金额、期限与确认节奏(3291亿美元承诺、2.3年加权期限、未来12个月+37%);其二,换算链条变量的官方披露——吞吐量、延迟、单位成本降幅;其三,CPU:GPU配比与智能体基础设施(沙箱、虚拟机、能效核)订单动向;其四,Maia系列部署兑现度——2027年多吉瓦、超百万颗目标 vs 实际上线规模;其五,供需缺口信号——订阅限制是否解除、现货算力定价走势。
从“堆卡”到“算账”,变的不是投入的决心(1900亿美元资本开支指引、3291亿美元租约承诺俱在),而是投入的算法:GPU数量不再是唯一的答案,利用率与兑现正在成为新的竞争维度。这道被三重变量改写的算术题,答案将在未来几个季度的财报电话会与部署数据中逐项揭晓。