导语 10月12日,智谱(Z.ai)通过官方博客发布法律垂类模型GLM-Legal。在评测机构Vals AI随后公布的法律测评中,该模型以19.2%的任务全通过率与86.23%的准确率,位居Harvey's Legal Agent Benchmark与LegalBench两项基准的开放权重模型榜第一。
一、事件聚焦:智谱发布并开源法律垂类模型GLM-Legal
官方渠道信息显示,GLM-Legal发布于2026年10月12日:Z.ai官方博客页面元数据明确标注发布日期为该日,公告标题为"GLM-Legal: Advancing Agentic Legal Intelligence"。10月13日,智谱官方X账号与Vals AI官方X账号先后发布成绩帖。
表1 GLM-Legal发布与传播时间线
时间 | 事件 |
2026-10-12 | Z.ai官方博客发布GLM-Legal公告 |
2026-10-13 | 智谱官方X帖与Vals AI官方X帖公布测评成绩 |
2026-10-17 | 量子位等中文科技媒体集中报道 |
2026-10-18 | A5站长网等媒体跟进解读 |
值得注意的是,部分媒体与传播稿件将发布时间表述为10月17日,或将获取方式表述为"权重开放下载"。对一手信源的核验结果显示,10月17日为中文媒体集中报道的传播节点而非发布日;获取方式方面,官方公告全文未出现"开源""开放权重""权重下载"等表述,公告以"Join the GLM-Legal Beta"为题邀请律所、法律科技公司、企业法务团队与独立执业律师申请试用,并给出商务咨询入口。核验期间,公开模型聚合平台未检索到GLM-Legal权重页;第三方观察亦指出该模型无公开API、需经申请获取。与之相对,评测方Vals AI的榜单将GLM-Legal归类为"开放权重(open-weight)模型",其官方X帖原文称其为两项基准的"the new #1 open-weight model"。本文对上述差异如实呈现:双榜"开放权重第一"为评测方官方定性,权重是否公开可下载未获官方渠道证实。
底座方面,GLM-Legal基于GLM-5.3-Flash构建,官方公告称其"Built on the lightweight GLM-5.3-Flash foundation"。智谱AI开放平台文档显示,GLM-5.3-Flash为GLM-5系列首个开源前沿模型,支持1M上下文。该底座此前的开源与高调用量构成本次垂类发布的基础设施背景。
二、测评解读:Vals AI法律基准双榜成绩与指标含义
Vals AI公布的数据显示,GLM-Legal在Harvey's Legal Agent Benchmark(下称Harvey LAB)的任务全通过率(all-pass rate)为19.2%,在LegalBench的准确率为86.23%。评测方与被评测方两侧的一手信息一致:智谱官方博客同步给出19.2%的成绩并称其在LegalBench与PLawBench上"对齐前沿闭源模型"。
图1与图2给出两项基准开放权重模型前五名的完整对比。Harvey LAB榜单上,GLM-Legal以19.2%领先第二名Mistral Large 4(15.8%)3.4个百分点;LegalBench榜单上,GLM-Legal(86.23%)与第二名Kimi K3(86.21%)仅相差0.02个百分点,前五名模型全部集中在84.74%至86.23%的窄幅区间。
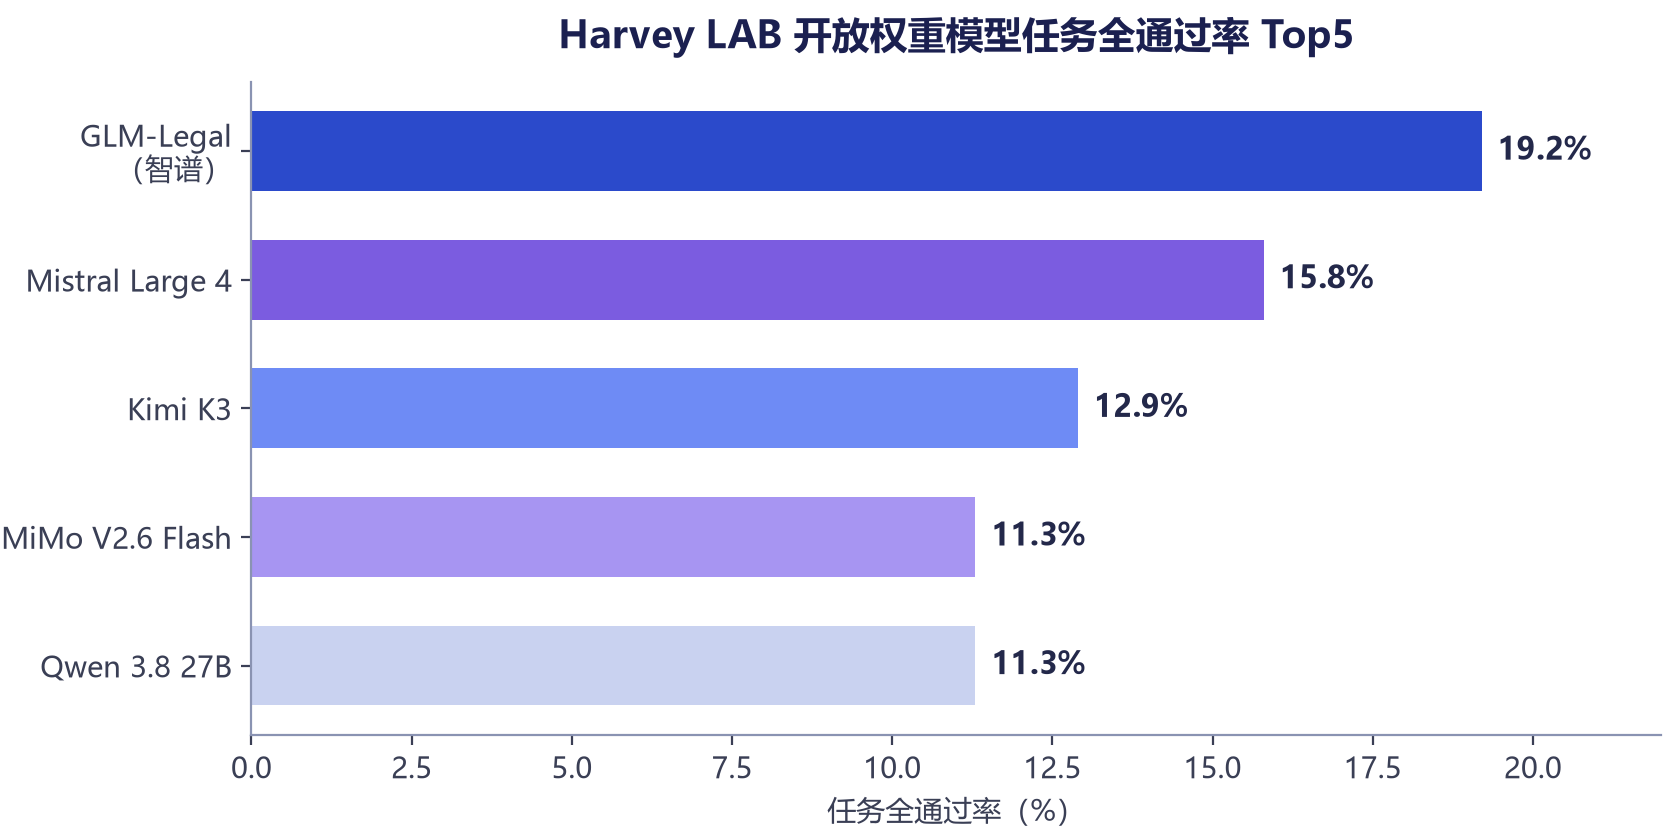
图1 Harvey LAB开放权重模型任务全通过率Top5
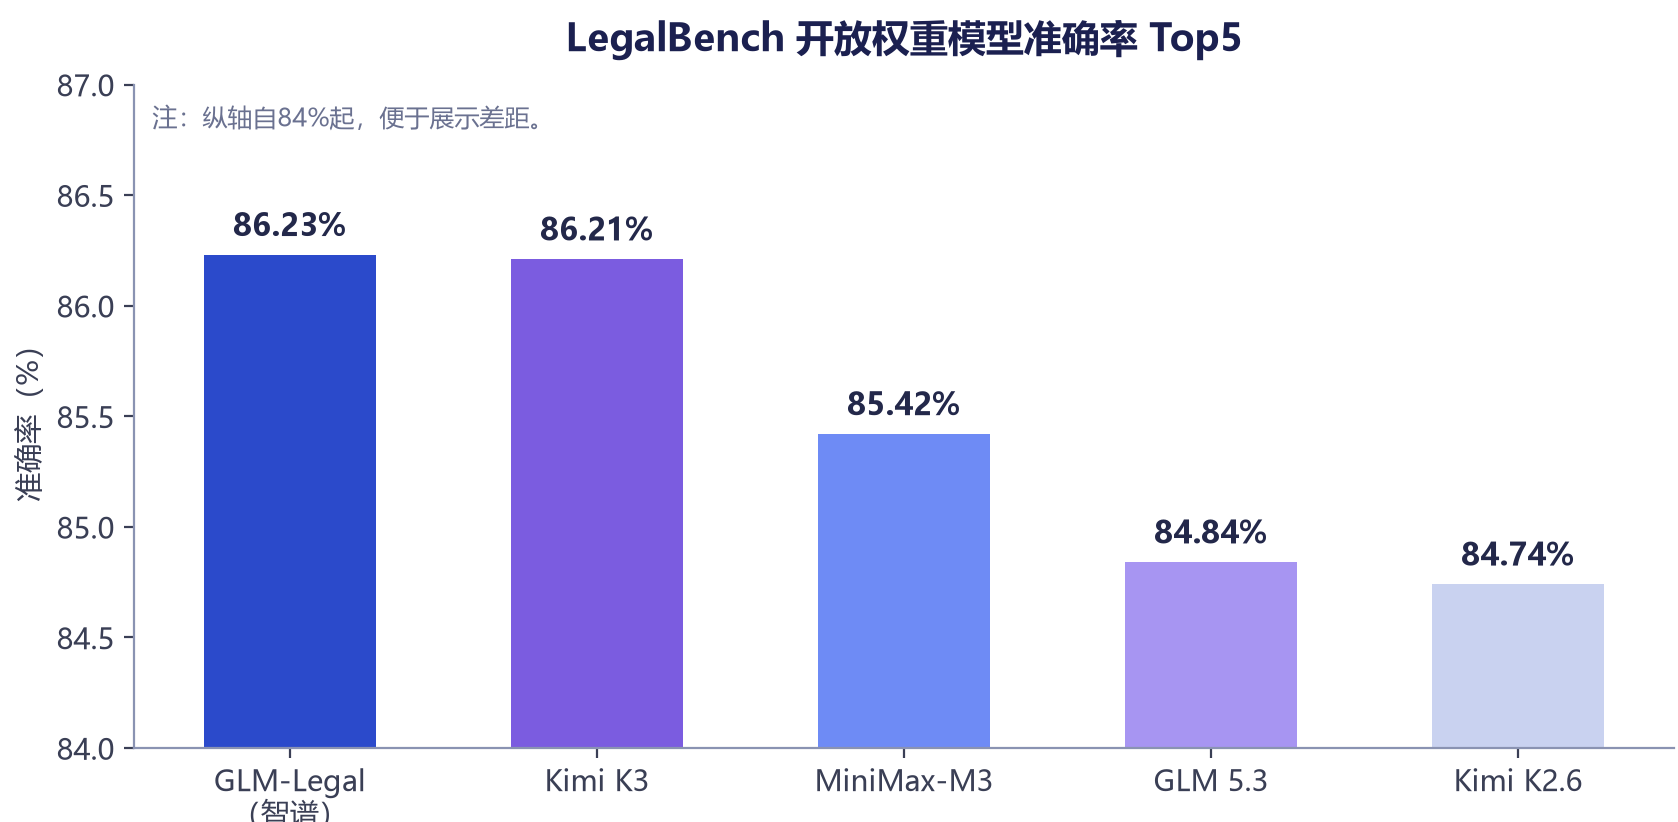
图2 LegalBench开放权重模型准确率Top5
两项成绩的口径需要分别理解。Harvey LAB采用严苛的"全条件通过"评分机制:一项任务中的所有评分条件全部满足才算通过,缺少任何一条即不通过;媒体转述Harvey官方介绍称,首版题库设置超过1200项模拟律所工作任务,覆盖并购、知识产权、银行金融等24个法律业务领域。在此机制下,19.2%意味着多数任务尚未实现全部条件达标;量子位在报道中同样提示,该成绩表明模型距离独立交付仍存在差距。LegalBench则衡量法律领域推理准确率,GLM-Legal的成绩与闭源前沿模型的差距较小:智谱官方对比图显示,LegalBench上Claude Fable 5为88.6%、GPT-6 Astra为87.1%,高于GLM-Legal的86.2%(展示精度一位小数)。
与底座对比看,官方公告称GLM-Legal在Harvey LAB上较底座模型提升12.5个百分点;官方对比图中底座GLM-5.3-Flash的全通过率为6.7%。智谱官方"Legal Benchmark Evaluation"三榜对比的完整数值如下表所示。
表2 智谱官方三榜对比图读数(一位小数)
模型 | Harvey LAB | LegalBench | PLawBench |
GLM-Legal | 19.2 | 86.2 | 77.3 |
Kimi K3 | 12.9 | 86.2 | 76.2 |
Claude Fable 5 | 11.3 | 88.6 | 77.7 |
GPT-6 Astra | 5.4 | 87.1 | 69.1 |
GLM-5.3-Flash(底座) | 6.7 | 83.9 | 73.8 |
表注:数值为智谱官方公告所载三榜对比图读数(一位小数展示口径);LegalBench榜单精确值为86.23%。三榜中Harvey LAB衡量智能体任务完成度,LegalBench衡量法律领域推理准确率,PLawBench为中文本地化法律实务基准。
三、技术拆解:法律语料中期训练与法律任务环境强化学习
官方公告将GLM-Legal的能力来源归结为两步走路径。第一步是法律语料中期训练(mid-training):在底座模型之上灌入法律概念、法条与分析方法,夯实领域基础;第二步是强化学习(post-training):在数万个现实法律任务环境中开展强化学习,使模型练习阅读材料、执行分析、推进任务、交付成果的完整流程。
这一路径的特别之处在于模型与智能体框架(Agent Harness)的协同进化。官方公告以"Post-training: Co-evolving the Model and Agent Harness"为小节标题,说明强化学习阶段并非孤立优化模型参数,而是让模型与调用它的智能体框架相互适配。多家媒体将此解读为:垂类模型的竞争已从单一权重质量扩展到"模型+执行框架"的整体交付能力。
四、能力落地:从法条问答到合同审查、证据梳理与跨境合规
官方博客通过三类演示呈现GLM-Legal的任务完成方式,其共同特征是直接输出可执行的交付物,而非仅给出法条问答。
合同审查场景中,针对更换软件供应商的审查需求,模型建议将终止通知期由60天缩短至30天,增加最长90天的过渡支持,并要求对方交回全部工作成果(包括尚未完成或尚未付款部分),同时给出交接时间与范围安排。
口径矛盾核查场景中,面对"对外报告称项目完成60%、内部记录约41%"的冲突,模型将矛盾事实与更早的风险提示、内部沟通记录串联,把证据、成因与后续动作落到同一链条上,并输出具体处理步骤。
跨境合规场景中,针对新加坡、马来西亚、印尼三地上线网站的需求,模型将用户追踪、邮件营销、海外云存储等合规事项拆解为可执行步骤,例如发布具体隐私声明、将退订请求录入抑制列表。
成本与效率方面,公开报道的对比口径一致:在成绩相近的对标任务中,GLM-Legal单任务成本约为某前沿闭源模型(AI Market Watch点名对比对象)的七十分之一,单任务耗时则长约30分钟。第三方观察同时提示,上述能力均属官方演示口径,模型的普遍可用性需待更大范围试用验证。
五、行业观察:开源垂类模型与法律AI竞争格局走向
GLM-Legal的发布并非孤立事件,其底座模型的商业化基础已先行铺开。OpenRouter日榜数据显示,2026年9月22日GLM-5.3-Flash当日调用量达4.36万亿Token,较上一统计周期增长73%,位列该平台模型调用量第一。10月6日,亚马逊云科技Amazon Bedrock宣布接入GLM-5.3,并采用按调用量收入分成的合作模式;媒体报道称智谱近期已与多家海外云厂商落地类似安排。
法律AI赛道的资本热度亦在抬升。公开报道称,法律AI公司Harvey拟以155亿美元估值进行融资,其年经常性收入超过3.5亿美元。垂类模型的竞争者既有Harvey这类垂直应用公司,也有推出Kimi K3等模型的通用大模型厂商,榜单上的正面对比已经直接化。
券商研报对事件的定性侧重趋势判断。中信建投证券研究认为,GLM-Legal的发布体现了大模型落地从通用走向更专精的垂类行业,有望助推智谱拓展律所及企业法务客户;华泰证券研究所则关注其中期训练与强化学习结合、通过Agent Harness协同优化的技术路线。综合来看,法律AI的竞争焦点正从法条问答转向任务交付,从通用能力转向领域纵深;GLM-Legal在严格评分机制下19.2%的全通过率也同时说明,垂类模型距离规模化独立交付仍有明确的提升空间。这一格局的下一步变量,在于模型权重的最终开放范围与AutoClaw等产品化的落地进度——官方公告预告其计划将GLM-Legal能力接入AutoClaw。