一、赛道全景:从“百模大战”到双线竞争
通用大模型是指具有广泛适用性、可跨行业跨场景完成多种任务的大型人工智能模型。2022年末ChatGPT问世引爆全球生成式AI浪潮之后,这条赛道一度呈现“百模大战”的繁荣景象;而到2026年,全球大模型竞争已从“单模型能力排名”进入“模型能力、算力供给、产品入口、企业客户、监管安全与资本效率”的综合竞争阶段,并呈现“中美双极分化、开源逼近闭源”的总体态势。国内观察亦指出,中国通用大模型厂商正沿差异化路径寻找各自的突围之路,底层模型能力决定生死、应用生态决定成败的产业四层推演正在成为共识。
竞争烈度最直观的刻度是Token调用量。据国家数据局数据,我国日均Token调用量已从2024年初的0.1万亿(1000亿)飙升至2026年3月的140万亿,两年增长超1000倍,行业竞争的核心已从大模型研发转向Token产能比拼。放眼全球,据OpenRouter统计,2026年8月第三周全球AI大模型总调用量达到93.4万亿,约为2025年末的16.8倍,其中中国AI大模型周调用量已连续17周超过美国,稳居全球首位。
【图表:中国日均Token调用量爆发式增长】
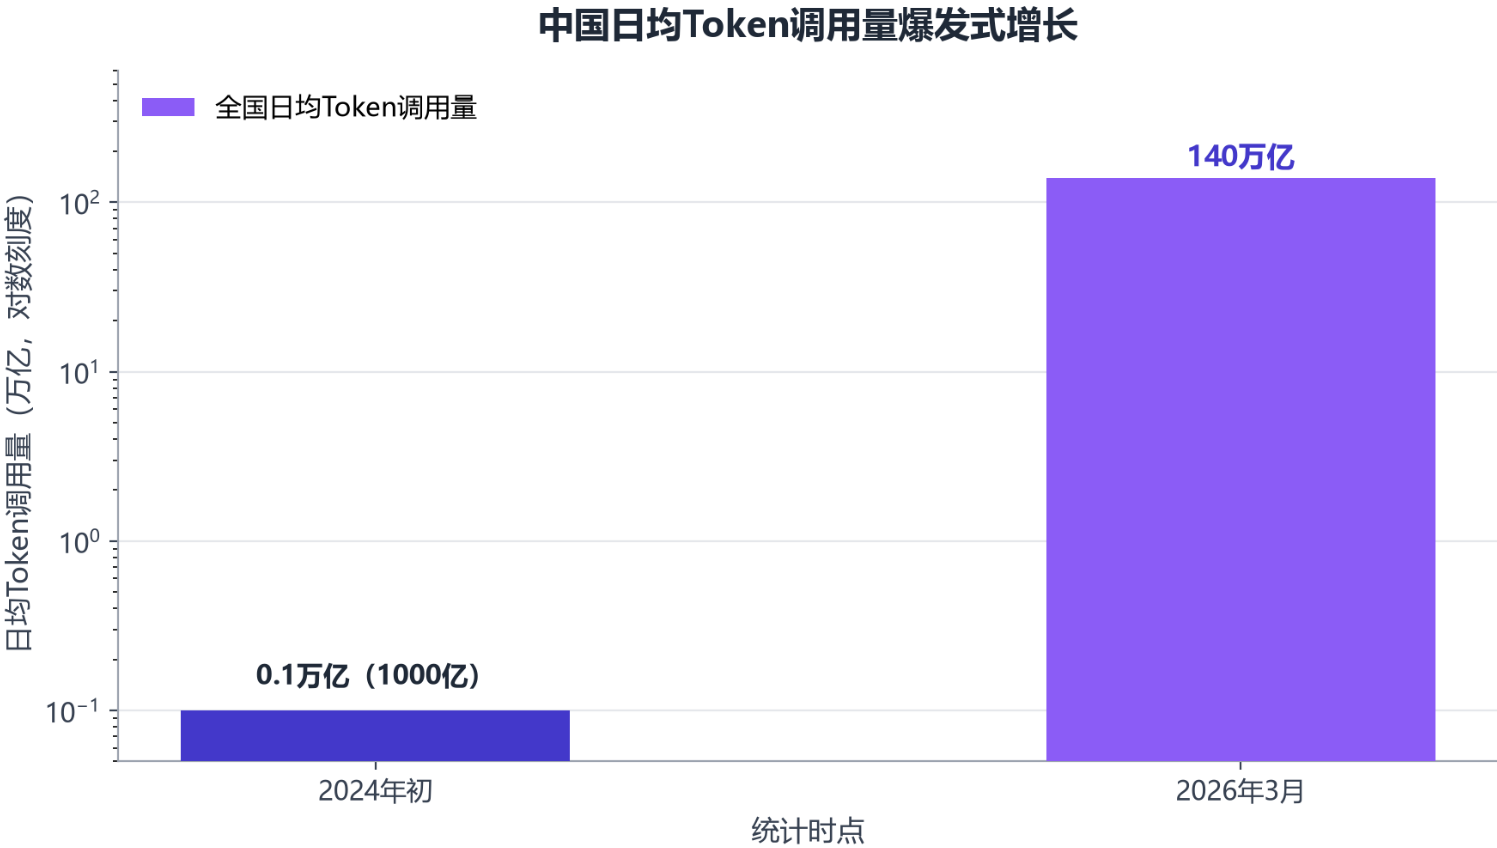
从0.1万亿到140万亿,两年超千倍的调用量扩张,意味着大模型竞争的计量单位已从“参数规模”切换为“Token产能”,算力供给与推理成本成为所有玩家的共同约束。
在爆发式增长的赛道上,参与者分化为两条截然不同的战线。一条是巨头主线:百度、阿里、腾讯、谷歌、Meta等科技巨头依托算力储备、云业务与客户资源推进全栈布局;另一条是初创主线:DeepSeek、月之暗面(Kimi)、智谱、MiniMax、Mistral、Anthropic等初创企业以单点能力实现突围。智源研究院理事长黄铁军判断,大模型能否留在牌桌取决于“三要素”——数据来源实时性、知识面全量性和基础设施可靠性,终极玩家数量“基本屈指可数”;零一万物董事长李开复亦预测,中国大模型市场最终将收敛至少数几家。
二、巨头主线:算力、云与客户资源驱动的全栈竞争
2.1 全栈能力:难以复制的系统性优势
国内大模型市场已从“单点能力比拼”进入“体系化竞争”的新阶段,竞争重心转向算力储备、数据资产、场景生态与商业化落地能力的全方位综合较量,梯队分化正在加速。头部互联网公司(阿里、字节、腾讯、百度)凭借云业务支撑的全栈能力——从算力资源到推理平台再到用户触达——以及自有超大规模用户场景提供的海量真实数据与正向反馈飞轮,具备其他参与者难以复制的系统性优势。这类企业可以实现“两手抓”:一方面用大模型赋能自身业务提升效率,另一方面以API与平台形式对外商业化,形成投入与收益的正向闭环,战略地位最为稳固。
以阿里为例,其依托Qwen模型构建了涵盖云基础设施、AI芯片、自研模型以及广泛企业客户的全栈平台,核心优势在于稳定、可扩展的云业务能够持续带来长期收入和生态协同,使模型能力稳步提升,而不主要依赖消费端流量。2026年6月,阿里宣布对大模型及AI业务组织架构进行新一轮升级,成立Token Foundry事业部,由集团CEO吴泳铭直接负责,原通义大模型团队负责人周靖人出任阿里巴巴首席科学家。腾讯虽手握微信这一最具影响力的社交平台,但在模型研发和应用落地上采取相对保守策略,以场景为导向积极接入多方模型;字节跳动则以产品化为导向,豆包依托抖音、今日头条的流量与广告变现体系,靠C端免费成长为国内用户规模最大的AI原生应用,截至2026年6月底其日均Token调用量已突破180万亿,较上线初期增长超1500倍。百度凭借文心系列在中文理解上的领先优势以及金融、政务行业积累,定位行业大模型领导者,深耕政企市场。
巨头的全栈竞争还延伸到了芯片层。百度昆仑芯P800“已在百度内部得到全面验证”,承担百度绝大部分推理任务后才推向外部行业,在中国移动十亿级推理型集采的三个标包中分别拿下70%、70%和100%的份额;腾讯7月推出自研推理芯片紫霄2.0,主要供自家业务使用,计划年底推进十万卡部署;字节的芯片研发团队已超过千人。全栈未必能让大厂在每一层都领先,但模型、云和高频应用积累的真实需求,正在帮它们把芯片卖出去。
海外巨头的路径同样清晰。谷歌坚守闭源高端路线,Gemini系列主打多模态与搜索场景;Meta则在不具备云服务等直接变现渠道的背景下,将开源Llama作为打破OpenAI等闭源模型主导格局的“破局”策略,通过开放顶级模型激发全球开发者生态、降低AI应用门槛。
2.2 生态天平:开源正在重塑巨头的竞争位次
巨头竞争的胜负手正从模型榜单转向生态数据。Hugging Face统计显示,阿里通义千问系列过去半年在该平台累计下载量超20亿次(约20.45亿次),登顶全球第一,远超谷歌的4.18亿次与Meta的2.27亿次;千问衍生模型超15.1万个,约为Meta整体的2.6倍。据Hugging Face 2026年春季报告,中国开源模型已占该平台月度及总体下载量的41%,而2024年底这一比例仅为1.2%。2025年7月,中国7款开源模型(智谱GLM-4.5系列、Kimi K2、阿里Wan-2.2及Qwen3系列等)一度包揽Hugging Face趋势榜前十中的九席,被英国《自然》杂志称为“又一个DeepSeek时刻”。
【图表:2025年Hugging Face平台主要开源模型累计下载量对比】
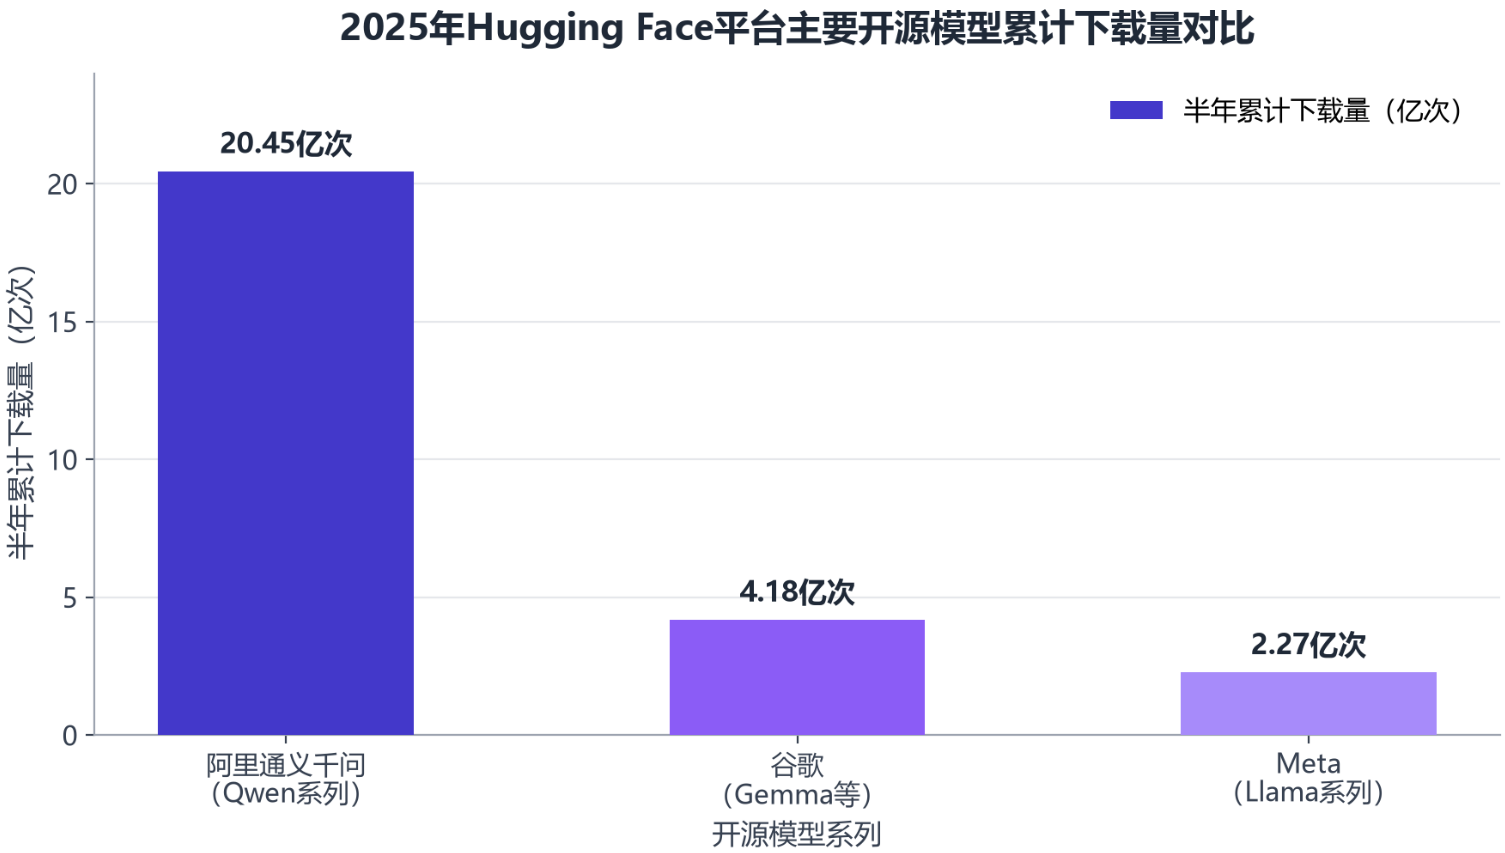
通义千问半年累计下载量约为谷歌的4.9倍、Meta的9.0倍,全球开源生态重心已明显向中国模型倾斜,开源正成为巨头争夺开发者生态位的核心手段。
开源生态直接转化为商业回报。Qwen系列开源带动阿里云AI相关收入连续多个季度实现三位数增长;另有报告按全球口径统计,Qwen系列模型下载量突破6亿次、衍生模型超17万个。两组数据口径与统计时点不同(前者为Hugging Face平台半年数据,后者为全球累计口径),存在差异但结论一致:开源生态已成为阿里云业务增长的引擎。
【图表:中国开源模型占Hugging Face下载量比例变化】
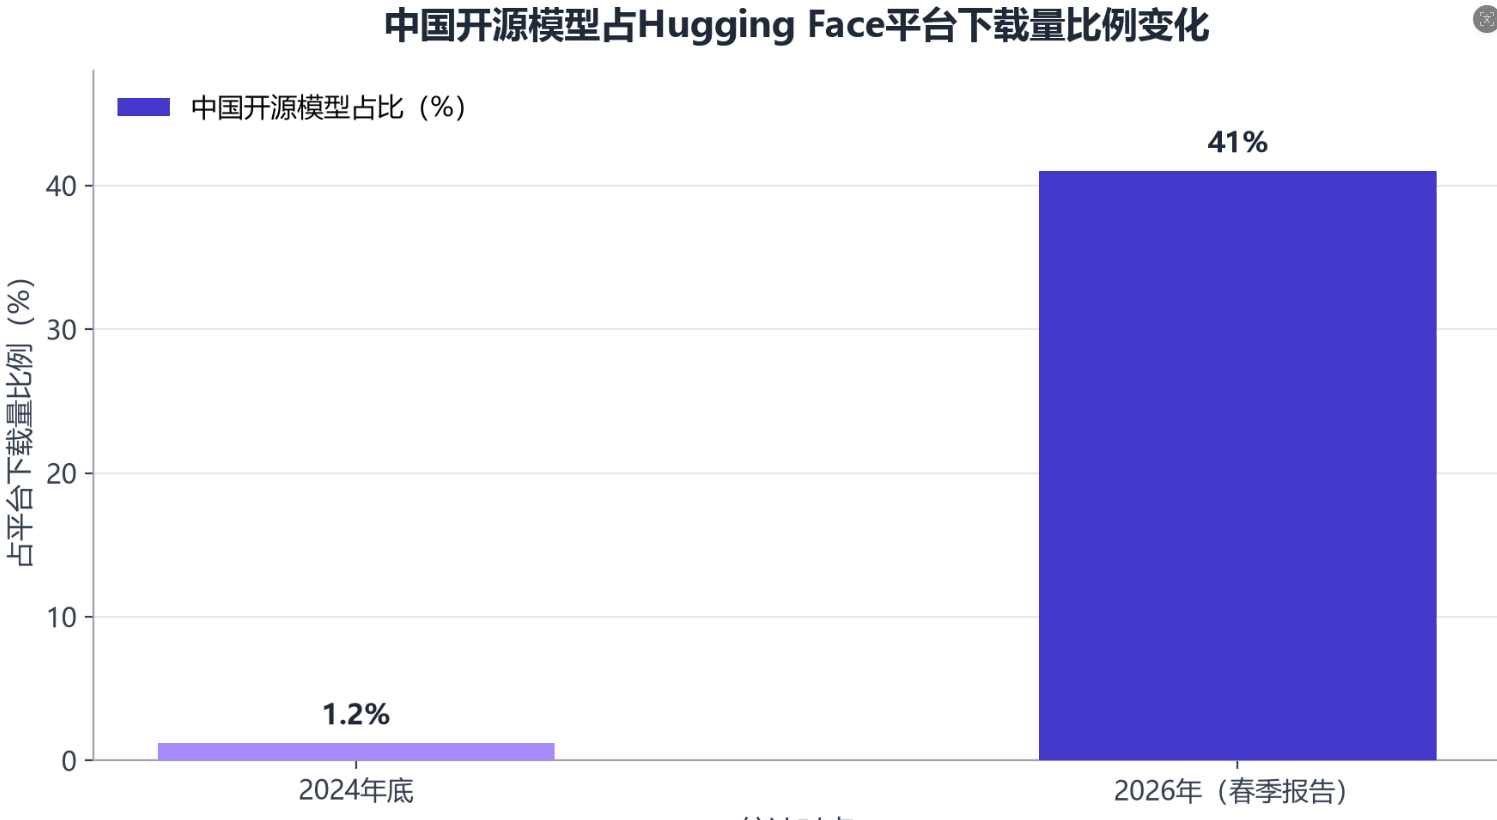
一年多时间里,中国开源模型占比从1.2%跃升至41%,近40个百分点的跃迁说明全球开发者正在“用脚投票”。
2.3 阵营图谱:开源与闭源的边界
表1:全球大模型开源/闭源阵营图谱
阵营 | 区域 | 代表机构 | 代表模型 | 核心策略 |
开源 | 国内 | 阿里巴巴 | Qwen(通义千问) | 全尺寸开源、云生态协同 |
开源 | 国内 | 深度求索 | DeepSeek V3/R1/V4 | 极致性价比、全面开源 |
开源 | 国内 | 智谱 | GLM系列 | 开源生态、政企交付 |
开源 | 海外 | Meta | Llama 4 | 开源生态、规模优势 |
开源 | 海外 | Mistral AI | Mistral Large 3 | 欧洲主权、效率路线 |
闭源 | 海外 | OpenAI | GPT系列 | 能力独占、C端订阅 |
闭源 | 海外 | Anthropic | Claude系列 | 安全优先、企业级与编程 |
闭源 | 海外 | 谷歌 | Gemini系列 | 多模态、搜索场景 |
闭源 | 国内 | 字节跳动 | 豆包 | C端免费、流量变现 |
动态调整 | 国内 | 百度 | 文心 | 2025年宣布由闭源转向开源 |
动态调整 | 国内 | 月之暗面 | Kimi K2/K3 | 开放权重叠加商业分成条款 |
值得注意的是,阵营边界并非静止:百度于2025年2月宣布将于6月30日正式开源文心大模型;腾讯混元Hy3于2026年7月以Apache 2.0协议开源;OpenAI则发布了自2019年以来的首批开源大语言模型。两大路线正在彼此渗透。
三、初创主线:单点能力的极限突围
初创公司没有云业务兜底,开源对它们而言是更残酷的生存计算。它们的共同策略是:避开与巨头的体系化消耗战,将全部资源压强到一个单点上,以极致能力换取生态位或定价权。
3.1 DeepSeek:极致性价比的算法革命
深度求索成立于2023年7月17日,由量化资管巨头幻方量化创立,创业初期便立下“开源、降本与AI普惠”的路线。2024年12月26日,DeepSeek-V3正式上线并同步开源,该模型拥有6710亿参数、激活参数370亿,在14.8万亿Token语料上完成预训练;官方技术论文披露,其预训练阶段仅使用2048块GPU训练2个月、花费557.6万美元,而GPT-4o训练成本约1亿美元;以达成与OpenAI o1相当性能为例,耗费资金仅为其3%-5%。2025年1月发布的DeepSeek-R1性能对标OpenAI o1正式版,并以MIT许可证允许全行业蒸馏。
斯坦福大学《AI Index Report 2025》显示,顶级闭源模型与最佳开源模型的性能差距已缩窄至1.7%。DeepSeek-V4-Pro在SWE-Bench Verified上得分91.2%,接近Claude Opus 4.7的93.9%,而成本仅为后者的约六分之一;Meta首席AI科学家杨立昆(Yann LeCun)由此评价:“与其说中国公司在超越美国公司,不如说开源大模型正在超越闭源。”
资本层面,DeepSeek于2026年6月完成首轮外部融资超70亿美元(约合超500亿元人民币),创下国内AI单轮融资纪录,投后估值近3500亿元,国家人工智能产业投资基金、腾讯及宁德时代等为主要出资方。耐人寻味的是,其年收入估算仅约1.3亿元至5亿元区间,年度亏损却接近零——背后是幻方量化的算力补贴,梁文锋在本轮融资中个人出资200亿元、约占40%,以维持绝对控制权。这家“暂时不想赚钱的公司”正把资源全部押向技术:组建AI代理(Harness)团队正面挑战Claude Code,旗舰模型V4 Pro大幅增强AI代理能力。
3.2 月之暗面Kimi:从长文本心智到编程与Agent
月之暗面成立于2023年3月,同年10月以中文200万字长文本能力被市场关注,Kimi智能助手逐步在C端破圈,2024年月活跃用户一度高达3600万,成为第一批国产Chatbot中的顶流。创始人杨植麟师承顶级AI学者,其早年参与发布的Transformer XL与XLNet论文被引用超1万次,被视为其坚持长上下文技术路线的来源。
2025年7月,公司推出国内首个万亿参数开源MoE模型Kimi K2,深耕Coding与Agentic场景。2026年7月发布的Kimi K3拥有2.8万亿参数,原生支持视觉理解,具备100万词元上下文窗口,是全球首个3万亿级开源大模型;其采用MXFP4四比特浮点格式将2.8万亿参数压缩进约1.4TB的物理文件。在Frontend Code Arena编程榜单上,Kimi K3以1679分登顶,这是开源模型第一次在同一榜单上超过Claude和GPT系列闭源模型;在ProgramBench测试中,K3以77.8分比GPT-5.6 Sol的77.6分高出0.2分。该模型定价远低于其所挑战的高端模型,Mozilla首席技术官拉菲·克里科里安评价:“这已经成为一个美国与中国之间的竞争问题。”有硅谷观察认为,K3的出现证明开源模型与全球最强闭源模型的差距已从代际差距缩短至1-3个月,甚至在部分任务上出现反超。
商业化方面,公司ARR(年度经常性收入)从2026年3月初的1亿美元增长至4月的超2亿美元;估值从2025年底的43亿美元,经2026年初的180亿美元、5月的超200亿美元、7月F轮的350亿美元,升至最新一轮的约500亿美元,不到一年增长超10倍,并已开始为港股IPO做投资者意向准备。
3.3 智谱、MiniMax:开源生态与调用量的竞争
智谱以“开源吸引开发者生态、B端G端定制付费”的组合拳推进,政企客户与私有化交付构成其基本盘。2026年4月,智谱发布744B开源旗舰GLM-5.1,在SWE-bench Pro评测中位居全球第一;6月发布的GLM-5.2实现1M无损上下文、Code Arena开源第一,并在海外第三方平台的使用率榜单中快速攀升、排名超越Anthropic系列模型,被美国政界人士评价为“仅比Anthropic的Opus 4.8略逊一筹,与OpenAI的GPT-5.5不相上下”。
MiniMax M2.5位居2026年2月OpenRouter模型调用量榜单第一(Kimi K2.5第二、DeepSeek V3.2第四、GLM-5第八)。财务数据上,MiniMax 2026年上半年实现营收约1.17亿美元,同比增长283.1%,毛利率17.9%,经调整净亏损约2.93亿美元,开放平台及其他AI企业服务收入占比升至63.4%,8月ARR超过8亿美元。2026年1月,智谱与MiniMax相继在港交所挂牌上市,标志着国产大模型产业进入商业化与资本化并轨推进的新阶段。
3.4 海外初创:Anthropic死磕代码,Mistral押注欧洲主权
Anthropic是“单点突围”最成功的海外样本:在OpenAI被ChatGPT的现象级繁荣牵制时,Anthropic将重兵压在“代码”这一个战场上,用绝对的专注在巨头的盲区里筑起护城河。其活跃用户只有OpenAI的七分之一,却拿下了全球LLM市场31.4%的收入份额——用更少的用户赚更多的钱,靠的是用户为生产力付费。财务上,Anthropic 2025年实现约46亿美元收入,但算力及基础设施相关支出约73亿美元,经营亏损约80.6亿美元,印证了闭源路线“以巨额资本筑壁垒”的高消耗特征。
法国的Mistral AI则代表“欧洲主权+效率路线”:它是欧洲最知名的AI大模型初创公司,估值约60亿美元。DeepSeek走红后,其CEO Arthur Mensch表示“DeepSeek是我们一直在等待的”,每当有新的开源技术出现,Mistral也会从中受益。
3.5 初创商业化的共同现实:收入高增与亏损并存
月之暗面等头部大模型企业单月收入已突破10亿元。但整体看,国内头部大模型公司正同时经历API收入扩张、研发投入高企与利润兑现滞后的经营阶段。性价比差距直观体现在价格表上:按Artificial Analysis“每美元可获得的模型智能”测算,MiniMax M2.5与智谱GLM-5的输入价格仅0.3美元/百万Token,而对标的美系顶尖模型高达5美元,近20倍的成本差异,对每天消耗数十亿Token的开发者而言“不是优惠,而是生死线”。
【图表:国产开源与美系闭源模型百万Token输入价格对比】
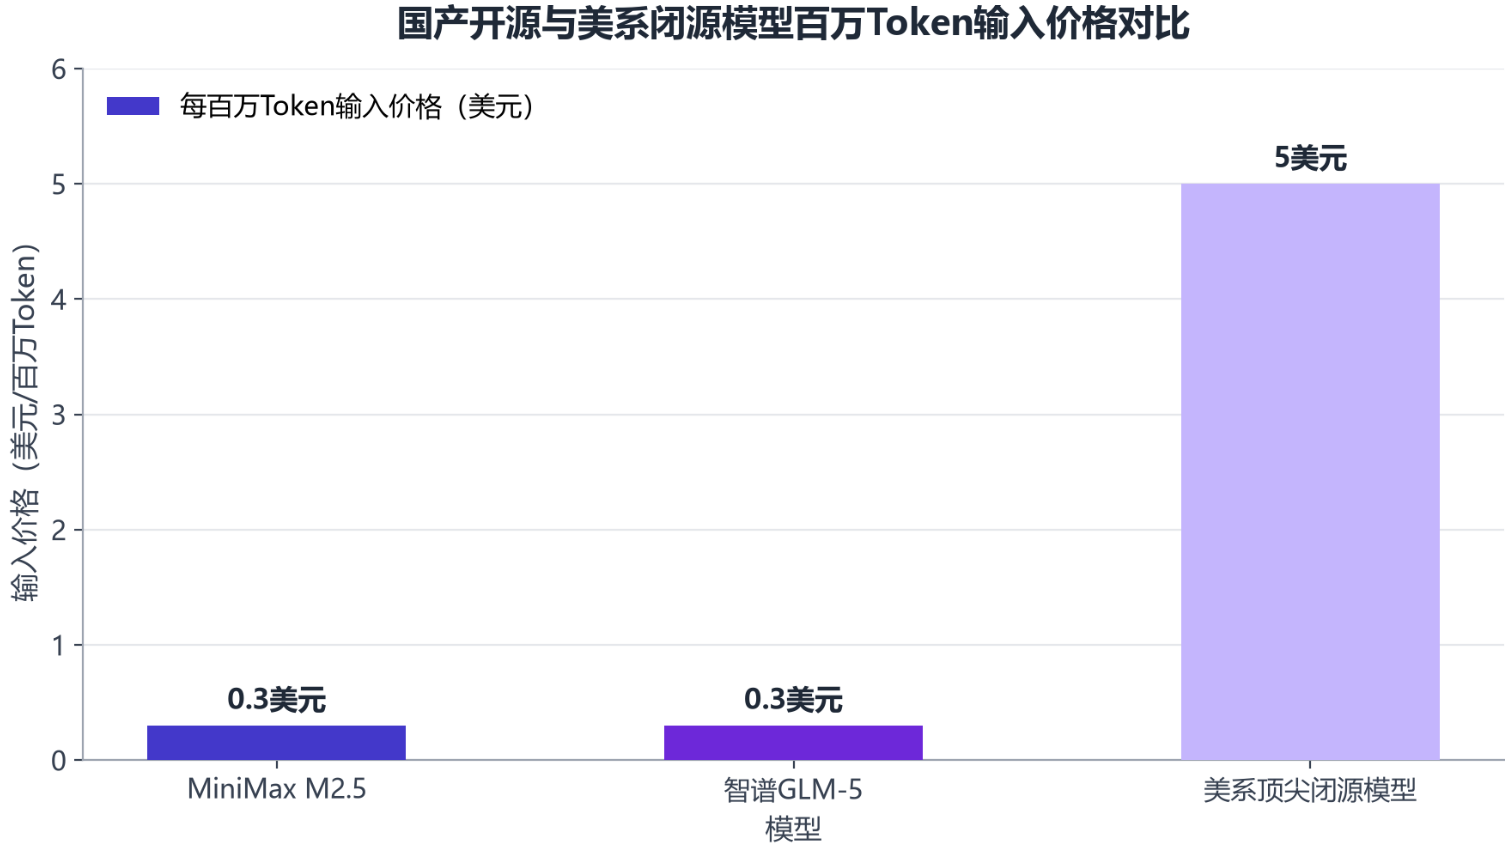
0.3美元对5美元的价差接近20倍,国产开源模型正以极致性价比改写全球模型服务市场的价格预期。
表2:头部大模型初创企业商业化进展速览
企业 | 路线 | 单点能力 | 关键进展 |
DeepSeek | 全面开源 | 极致性价比、代码与Agent | V3预训练成本557.6万美元;投后估值近3500亿元 |
月之暗面(Kimi) | 开放权重+商业分成 | 长文本、编程、Agent | K3达2.8万亿参数;估值约500亿美元 |
智谱 | 开源生态+政企付费 | 编程、智能体 | GLM-5.1获SWE-bench Pro全球第一;2026年1月港股上市 |
MiniMax | 开源+企业服务 | 多模态、轻量化 | 2026年上半年营收约1.17亿美元,同比增长283.1% |
Anthropic | 闭源 | 代码与Claude订阅 | 2025年收入约46亿美元,占全球LLM市场31.4%份额 |
Mistral AI | 开源 | 轻量高效、欧洲主权 | 估值约60亿美元 |
四、路线分野:开源与闭源的商业模式博弈
4.1 两种商业逻辑的本质差异
两条路线的分野,根源在于商业模式与资本结构的差异。开源的本质是“以放弃模型独占权换取生态位”——它对资本消耗更低,特别适合无法持续私募输血、或需要借开源建立生态话语权的玩家;闭源的本质则是“以巨额资本筑起模型能力的独占壁垒”,依靠API订阅与企业合同变现,天然是巨头的副业和资本巨兽的主业。
闭源路线的代价是惊人的资金消耗:OpenAI一年运营亏损高达209.2亿美元,2023年至2028年预计累计亏损440亿美元,2026年支出可能攀升至95亿美元。开源路线则以生态换收入:阿里、百度通过API降价50%并提供免费额度吸引开发者,DeepSeek利用MoE架构将推理成本降至国际同类产品的10%。
4.2 Meta与阿里:为什么选择开源
Meta开源Llama的核心原因,在于其收入来自社交平台和广告,并不需要直接依靠出售模型调用获得回报;其思路是通过降低基础模型的稀缺性,推动Llama成为行业公共底座,让竞争优势更多回到应用、用户入口、数据和产品分发等自己最熟悉的环节。这与“以放弃模型独占权换取生态位”的开源逻辑完全一致。
阿里的开源则是云生态的引流入口。Qwen全尺寸开源直接带动阿里云AI相关收入连续多个季度实现三位数增长,本质上是互联网“引流+变现”商业模式在AI时代的延续。更重要的是,开源承接了闭源API进不来的市场——私有化部署与微调定制:私有化部署/一体机模式采取“一次性许可+年维护服务费(百万级起)”定价,主要客户为政府、金融、医疗、军工机构,毛利高、迁移成本大、黏性强。落地案例已密集出现:DeepSeek大火之后一体机大行其道;光环新网完成DeepSeek本地私有化部署适配;开普云在智能体中台中无缝集成DeepSeek本地化部署,服务北京国资公司等多个客户;金融领域已有超数十家头部企业完成开源模型部署。对跨国经营场景而言,开源模型“数据不出境”的方案,比使用海外闭源云服务更让企业安心。
4.3 OpenAI与Kimi:闭源与半闭源的变现逻辑
OpenAI坚守闭源路线,主要收入来源包括订阅和API服务。其商业闭环建立在两个前提上:技术绝对领先,且市面上找不到同等质量的免费替代品。随着开源模型逼近闭源,这两个前提同时松动,OpenAI也开始调整:发布自2019年以来的首批开源模型GPT-oss-120b与GPT-oss-20b,CEO奥尔特曼承认在开源问题上“站在了历史错误的一边”;与此同时,在软银领投的400亿美元融资协议要求下,OpenAI正推进从非营利架构向营利性实体的转型。试水开源,是其在资本压力、行业竞争与商业变现之间寻找的折中方案。
月之暗面Kimi长期以闭源模式运营,“能读长文档”的超长上下文心智在国内一度独树一帜,但如何把这份心智变成收入,曾是它自己的待解题。2026年,Kimi K3以“开放权重+收入分成”条款向海外服务商开放——既是生态武器,也是IPO前商业可持续性的证明。这种“半开放”策略,折射出初创企业在扩大模型生态影响力与保留商业定价权之间的现实平衡。
4.4 边界消融:路线之争没有终结
在企业落地场景,两条路线各有软肋:开源模型免费、可私有化,但没有原厂支持,单行业经验迭代速度慢,不少企业自部署进度到六七成时便发现难以真正落地;闭源模型迭代快、有原厂支持,但难以满足数据保护与私有化需求。业内人士指出,当一个优秀的开源模型被推出时,它实际上提升了整个行业的基础标准。厂商们的共识是:拼价格意义不大,更重要的是补结构——建立“旗舰+小模型+免费端”三层结构,让旗舰敢于定价、小模型走量、免费端做渗透,同时放大开源生态、私有化部署与定制化服务这些不依赖裸价的能力。2026年的行业分析普遍认为,开源与闭源将长期并存、分别向成本敏感市场与能力前沿市场纵深演进,二者的竞争关系并非零和替代,而是在不同生态位上相互渗透。
表3:巨头与初创双线竞争对比
维度 | 巨头阵营 | 初创阵营 |
代表企业 | 阿里、腾讯、百度、字节、谷歌、Meta | DeepSeek、月之暗面、智谱、MiniMax、Anthropic、Mistral |
核心资源 | 算力储备、云业务、超大规模用户场景与客户资源 | 顶尖技术团队、单点技术压强、私募融资 |
竞争策略 | 全栈布局:模型+芯片+云+应用“两手抓” | 单点突围:长文本、代码、轻量化、极致性价比 |
变现路径 | 自身业务提效+API与平台商业化闭环 | API调用量、开放权重分成、IPO资本化 |
典型路线 | Meta/阿里开源换生态,谷歌闭源坚守高端,百度由闭源转开源 | DeepSeek全面开源,Anthropic闭源死磕代码,Kimi开放权重+分成 |
五、格局走向:收敛、融合与资本市场重估
第一,梯队收敛加速。中国大语言模型行业正从数十个模型竞争向三大主导玩家整合的方向演进,DeepSeek、阿里、字节被普遍视为当前领先者。曾经的“大模型六小虎”走上不同道路:百川、零一万物等已基本放弃耗资巨大的通用大模型路线,零一万物部分团队并入阿里并转向中小模型与商业应用探索。
第二,开源逼近闭源。性能差距已缩窄至1.7%;2026年4月,DeepSeek V4预览版全系标配100万Token上下文、首次深度适配华为昇腾并以MIT协议开源,与GPT-5.5几乎同日发布。Kimi K3、DeepSeek V4、智谱GLM-5.2等中国开源模型开始主动把规模推向新上限,直接参与下一代模型能力边界的竞争。
第三,资本市场重估。2026年1月智谱、MiniMax相继港股上市;DeepSeek完成超70亿美元融资、月之暗面估值约500亿美元。有测算指出,中国开源模型消化了2000亿至3000亿元人民币的ARR空间,按20倍ARR估值对应4万亿至6万亿元的市值转移,而当前DeepSeek、Kimi、智谱、MiniMax等只承接了五分之一到三分之一的估值空间——被开源模式推迟的变现,可能沉淀为中国开源模型公司的潜在收益。
风险提示:行业竞争加剧、技术研发进度不及预期、下游资本开支周期性波动等因素,可能改变上述格局的演进节奏。
六、结论与建议
其一,对巨头而言,全栈是护城河,但“体系化竞争”的每一层都需要持续投入。算力、云与场景的闭环优势难以复制,而竞争的计量单位已从模型榜单转向Token产能与生态数据(下载量、调用量、衍生模型数),巨头应将开源作为生态入口而非成本项。
其二,对初创而言,单点是生存策略,商业化闭环决定生死。DeepSeek证明了极致性价比与全栈开源可以撬动全球生态,Anthropic证明了“死磕代码”的专注可以换来全球LLM市场31.4%的收入份额,但两者的共同前提是技术标杆必须转化为可持续收入。编程与办公是已被验证的付费赛道。
其三,对企业用户而言,开源承接私有化部署与数据不出境需求,闭源提供前沿能力与原厂支持,“开源+闭源”混合策略将成主流,选型时在价格之外更应关注分层产品结构与生态成熟度。
其四,对产业观察者而言,判断赛道走向的指标正在切换:从参数规模与跑分榜单,转向Token调用量、API收入、ARR与开发者生态数据;开源与闭源的边界将持续消融,“收敛与共生”将是未来两年最确定的趋势。