【导语】北京时间 10 月 7 日凌晨(美国当地时间 10 月 6 日),OpenAI 发布《Sharing AI progress in mathematics》,并以其 Apache-2.0 许可开源 GitHub 仓库 openai/math,一次性公开其尚未发布的内部前沿模型产出的 722 份数学手稿,归为 372 组结果族,覆盖准黎曼猜想、霍奇猜想、BSD 猜想、π 无理性指数等长期悬而未决的数学问题。官方披露,这批成果源自对约 4000 个开放问题的评估,平均每项结果消耗约相当于 ChatGPT Pro 思考 3 小时的算力,并附节选推理摘要与部分 Lean 形式化证明;OpenAI 同时坦承,未形式化的结果可能存在问题,将持续修正。
一、事件速览:一次没有先例的"交卷"
这不是一场发布会,而是一次"交卷"。OpenAI 在官方博客中写道:"我们正在发布由一个内部前沿模型产出的大量新数学结果。"仓库 openai/math 中的 Readme 与《OpenAI Research Catalog》总览文档显示:目录包含 722 份手稿、372 组结果族;一组结果族聚集主结果、伴随论证、推论或替代证明,并按数学学科分类。
三个背景细节值得注意:
第一,发布依据了一套外部规范。OpenAI 在博客中明确表示,其与普林斯顿高等研究院(IAS)托管的"数学与人工智能顾问组"(AGMAI)合作制定最佳实践,并依据该组的公开建议设计本次发布。
第二,评估动机是"旧题不够用了"。README 写道:随着模型在既有数学评测上饱和,OpenAI 将评估扩展到开放研究问题——评估中共向模型提出约 4000 个问题,经结果族聚类并设置显著性门槛后,形成 722 份手稿的目录。
第三,产出主体始终未露面。全部成果出自一个未发布的内部前沿模型,OpenAI 表示"正在负责任地推进该模型的发布";据多家媒体报道,Sam Altman 随后在社交平台表态"我们正在进入一个大发现的新时代"。
二、核心数据面板:4000、722、372、162 与 3 小时
这次发布的信息结构可以概括为一条"漏斗":约 4000 个开放问题进入评估 → 产出 722 份手稿、归为 372 组结果族 → 其中 162 篇论文的主结果已获 Lean 形式化 → 另附 10 份节选推理摘要与算力账本。
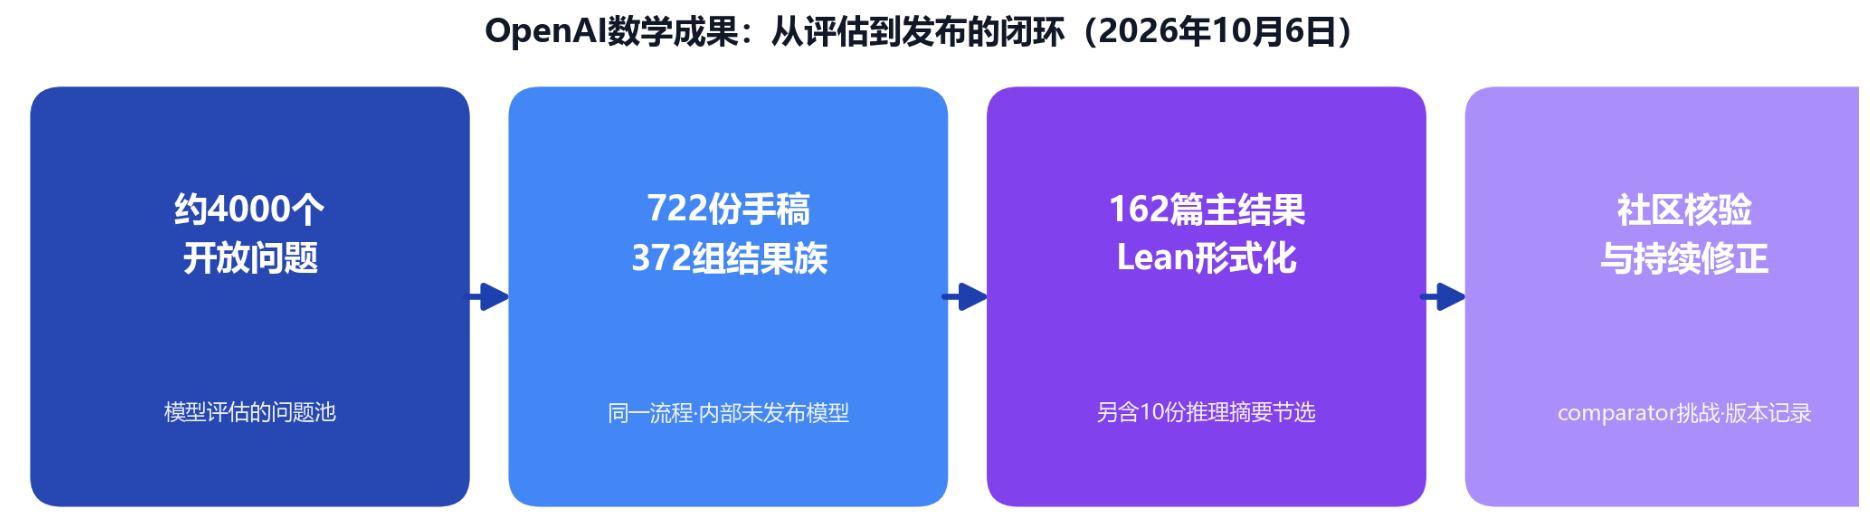
图1 OpenAI 数学成果:从评估到发布的闭环
几个关键数字均经双源核验:
其一,约 4000 个问题。README 原文为"评估期间共向模型提出约 4000 个问题",与官方博客"公布尝试问题数量的统计"对应,量子位、AICoder 等报道口径一致。
其二,平均算力约 3 小时。官方博客与 README 均写明:平均每项结果消耗约相当于"ChatGPT Pro 思考 3 小时"的算力,且绝大多数结果出自同一未发布模型的同一套固定流程。
其三,形式化覆盖。仓库的 formalization.yaml(v0.4)目录列出 162 篇"主结果已形式化"的论文——本刊下载该文件逐条清点,恰为 162 条;AICoder 报道亦给出相同数字。就结果族维度而言,AICoder 统计 372 族中约 235 族链接 Lean,机器之心则以"约六成成果族附有 Lean 形式化"表述,两者口径吻合。
其四,10 份推理摘要覆盖的结果族为:007 乘性函数的普通两点相关、017 π 的无理性指数、087 对称与一般 Mahler 猜想、102 基本半定阈值下的普通 NP 难度、159 算术级数的拟多项式界、197 特征 2 上的 Kaplansky 直有限猜想、221 稀释自旋玻璃的 Mézard–Parisi 公式、271 量子海森堡铁磁体的自发磁化、287 自由群因子的同构、362 三维相对论性 Vlasov–Maxwell 系统。
三、难题覆盖图谱:从 7/8 线到千禧难题的"外围突破"
翻开目录,名气最大的问题几乎全部到场。overview.pdf 将 372 组结果族划入 17 个学科:理论计算机科学 40 族、组合数学 37 族、代数与复几何 36 族、数论 31 族、概率与统计力学 29 族、微分几何 29 族、数学物理 25 族、算子代数 19 族、代数 18 族、拓扑 18 族、实与复分析 16 族、偏微分方程 16 族、凸与度量几何 15 族、群论 14 族、动力系统与遍历论 12 族、泛函分析 11 族、数理逻辑 6 族。
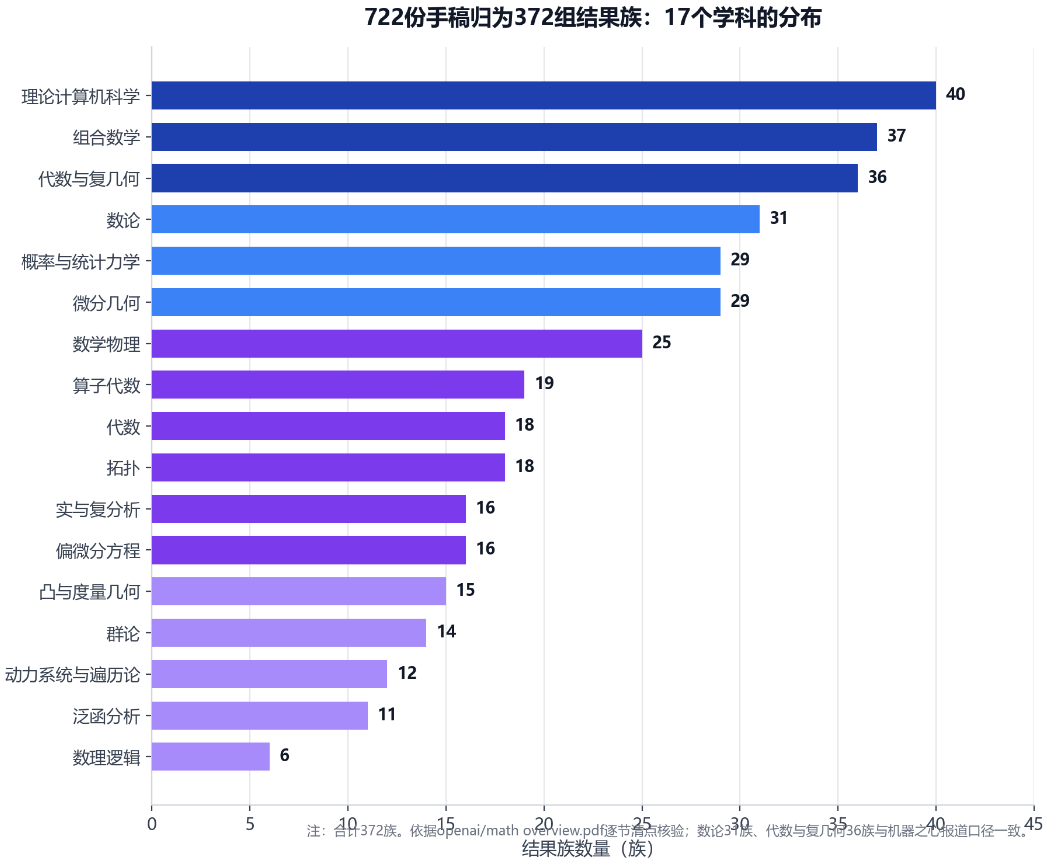
图2 722 份手稿归为 372 组结果族的学科分布
数论是话题中心。编号 003 的"准黎曼猜想"声称:包括 ζ 函数在内的所有狄利克雷 L 函数在实部大于 7/8 的半平面内无零点,并附 Lean 形式化链接;同族还有一份"实部大于 11/12"的替代证明。量子位解读称,此前数学家连"实部大于 0.99 的竖带无零点"都未能整体证得,已知无零区域只是贴着实轴 Re(s)=1 的边缘逐步收窄;11/12 版本还附带一致排除"西格尔零点"——一类可能藏在实轴 1 附近、困扰数论界近百年的异常零点。
千禧年大奖难题在这个目录里"沾上了三道"。除黎曼猜想外围的 003 族外:002 族声称对 Selmer 余秩为 0 或 1 的全部有理椭圆曲线证明完整 BSD 首项公式(含 Tate–Shafarevich 群有限),与 006 族(另证 Goldfeld 猜想)合并后,给出每条有理椭圆曲线"密度为一的二次扭曲集"上的完整 BSD;032 族声称对全部复 CM 阿贝尔簇证明有理霍奇猜想——README 特意注明,这项与 ζ 无零区域一样未走模型的标准流程,且目前没有形式化;机器之心梳理称,OpenAI 表示借助 Milne 此前定理,该结果还可推出有限域上所有阿贝尔簇的 Tate 猜想。004 族则指向希尔伯特第十问题的有理数域版本,声称答案同样是否定的:不存在判定整系数多项式方程有理解的通用算法。
更"亲民"的两项结论同样醒目:017 族声称 π 的无理性指数恰为 2——即 π 在"被分数逼近的难度"上与绝大多数无理数无异,此前已知上界约 7.1——并顺带证明流传已久的 Flint–Hills 级数收敛,该项附 Lean 形式化;005 族声称卡塔兰常数为无理数。
值得注意的是,这批成果并不全是"证明"。054 族构造反例,推翻了关于三次四维簇有理性的 Kuznetsov 猜想;机器之心粗略统计,摘要中出现"证伪/反例"字样的成果族约有 50 个——一些流传半个多世纪的猜想是被推翻而非被证明。此外,目录中还有 074 族对三维与四维 Kakeya 问题的推进、069 族对无理水平全局量子几何朗兰兹等价的证明等条目。
四、产出与验证体系:同一流程、两类例外、三级可信度
生产方式上,README 交代得相当坦率:绝大多数结果由"同一未发布内部模型 + 同一套固定流程"获得;例外只有两项——ζ 函数无零区域与 CM 阿贝尔簇霍奇猜想;此外 Re(s)>11/12 那份写作为可读性做过人工润色。
验证体系则呈现清晰的三级可信度:第一级是 Lean 形式化——162 篇论文主结果由计算机逐行检查,并配有 comparator 挑战文件与 formalization.yaml 目录,可供外部复验;第二级是未经形式化但已公开的论文与源码,目前只能算"声称";第三级是模型推理摘要,仅用于展示科学过程而非证明本身。
这套结构直接对应 AGMAI 9 月 29 日建议书的技术规范:要求披露模型名称、提示词、(摘要)思维链、耗时与算力成本;要求形式化产物含版权头、comparator 挑战文件与 formalization.yaml;要求存储库不应由 AI 实验室控制;并明确"不应把数学成果发布用作模型营销工具"。OpenAI 的本次发布——10 份推理摘要、以 Pro 用量计的算力估计、尝试题数统计、版本化修正记录——几乎逐条"照单执行"。AGMAI 调查收到超过 600 份回复,其三项总原则为:重要成果应尽快负责任地发布;实验室必须为"人类理解随之跟上"提供包括资助在内的实质支持;人类理解的培育须保持社区主导、不由实验室导演。
不过,可信度的边界同样被官方写明:"部分未形式化的结果可能存在问题,我们将尽快修正。""并非所有成果都附带 Lean 形式化,我们将持续更新。"机器之心提醒读者:清单中所有"证明了""解决了"都是 OpenAI 自己的表述,绝大多数尚未经过同行评审。
五、代际对比与竞争格局:从奥赛奖牌到开放研究问题
把这次发布放进近两年 AI 数学的坐标系,其位置一目了然。
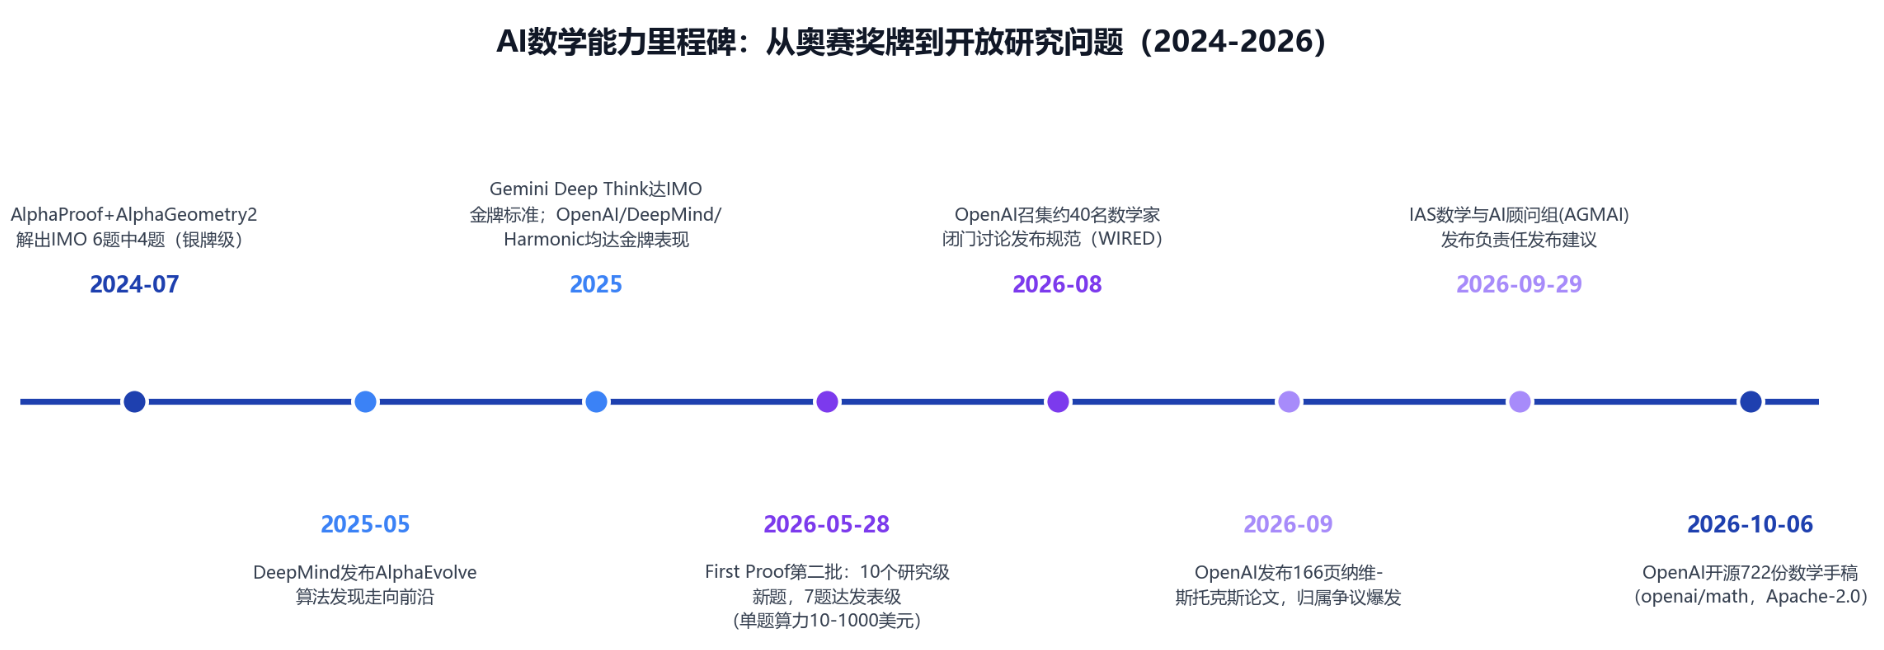
图3 AI 数学能力里程碑 2024-2026
2024-07,Google DeepMind 的 AlphaProof 与 AlphaGeometry 2 解出国际数学奥赛(IMO)6 题中的 4 题,达银牌水平;进入 2025,搭载 Deep Think 的 Gemini 达 IMO 金牌标准,stateof.ai 年度报告(2025)称 OpenAI、DeepMind 与 Harmonic 等均已达到 IMO 金牌表现;2025-05,DeepMind 发布结合进化搜索的 AlphaEvolve,把"算法发现"推向前沿。
来到 2026,两组事件划出了新的刻度。其一是外部独立评测 First Proof:据陶哲轩 7 月 24 日国际数学家大会(ICM)演讲《数学in the age of AI》披露,第二批 10 个"贡献者知道答案、但从未上网公开"的研究级新题于 5 月 28 日在受控条件下对 4 个 AI 系统测试,由专家对正确性与表述双维度评审,结果 7 题达到"发表级质量",单题算力成本约合十美元到一千美元。其二便是 OpenAI 本次发布:相比奥赛题与评测集,它直接把战场移到了开放研究问题,规模为"数百份手稿"量级,平均算力约 3 小时 Pro 思考/结果——若结论经得起检验,这是 AI 数学从"应试"到"科研"的量级跃迁;但与 First Proof 的"外部命题、独立评审"不同,OpenAI 的成果由自家发布、主要依赖 Lean 与社区后续核验,公信力建构路径截然不同。
竞争叙事背后还有一段前史:据 WIRED 报道,今年 8 月 OpenAI 曾召集约 40 名顶尖数学家闭门讨论"当 AI 在纯数学上全面超越人类该怎么办";9 月 OpenAI 发布 166 页论文《Finite Time Blowup for Navier–Stokes》,几乎同一时间,纽约大学数学家 Tristan Buckmaster 与 Anthropic 研究员 Levent Alpüge 公开三篇流体方程爆破证明并配 Lean 形式化,双方围绕进度与归属爆发公开争执。
六、产业纵深:AI for Math 的三层结构与算力账本
以产业视角拆解,这次发布勾勒出 AI for Math 的三层结构。
上游是前沿模型层。OpenAI 选择"成果先公开、模型后发布"的节奏:内部模型既不开放权重也不开放服务,仅公开产出物。AGMAI 对此有直接批评——用专有内部模型做数学研究可能造成"双层体系",使实验室甩开整个领域;其建议书甚至声明"我们不背书在专有模型上测试高等数学问题的做法,并呼吁停止"。但另一面,顾问组也要求实验室为人类理解提供资金支持——OpenAI 宣布将出资资助系列研讨会、会议与特别项目,恰是这一原则的落地。
中游是形式化验证层。Lean 生态(mathlib 数学库、comparator 挑战机制、formalization.yaml 目录)正在成为 AI 数学的"公证人"基础设施:AGMAI 把"形式化产物含挑战文件与机读元数据"写进规范,OpenAI 仓库则把它变成现实。微软研究院提出的科学发现"第五范式"概念(2022),在这条链路上得到了最严格的注脚——当 AI 产出科学结论时,可机器验证的形式化系统是公信力的底座。
下游是学术消费层。722 份手稿的最终归宿是数学界:引用走 BibTeX、修正走版本记录、理解靠研讨会与工作坊。算力账本则给出了一个罕见的量化锚点——平均每项开放问题结果约 3 小时 ChatGPT Pro 思考当量。无论这一成本未来如何变化,"以订阅产品算力为单位披露成本"本身就是行业首次规模化实践,它让"AI 科研产出的性价比"第一次可以被外部估算。
七、业界回响:兴奋、恐惧与"阅卷难题"
数学界的即时反应呈两极。量子位标题里,"三位菲尔兹奖得主:不代表认可"直接点出保留态度;得克萨斯大学奥斯汀分校数学家 Francesco Maggi 在发布前发问:9 月那篇流体力学证明专家们至今仍在研究其原理,"一下再来数百篇,谁有精力读?"菲尔兹奖得主 Cédric Villani 谈及纳维-斯托克斯证明时直呼"大受震撼……简直跟世界末日一样";纽约大学访问教授 Nestor Guillen 则用"强盗"形容 AI 巨头的行为方式。西北大学数学家 Bryna Kra 回忆 8 月闭门会的气氛是"极度兴奋与极度恐惧的混合";与会学者当时恳请 OpenAI 按学术规范发布严谨论文、给人类学者留出消化时间,部分与会者以为不会一次全部放出,而 OpenAI 发言人表示公司不了解存在此类承诺。
也有温和的声音。OpenAI 研究员、统计学家苏炜杰称这是"人类对智能认知的哥白尼式范式转变的开端"。就连一贯对 AI 工具不吝安利的陶哲轩,也在 9 月加州理工的一场演讲中踩了刹车:AI 发展的速度"太疯狂了",没有理由这么快。
争议的焦点并非"AI 能否做数学",而是"谁来为正确性负责"。AGMAI 顾问组在发布后的表态颇具代表性:材料已经公开,接下来应由数学家检查、讲解,再决定哪些结果真正进入数学研究。换言之,OpenAI 交卷了,但数学界的阅卷才刚开始——162 篇 Lean 形式化的结果可信度最高,其余 500 余份手稿仍停留在"声称"状态,等待形式化或同行审读。
八、趋势研判:AI 科研产出的规模化临界点
综合本次事件与近半年信息,可以给出四个趋势判断。
判断一:验证基础设施正在标准化。formalization.yaml、comparator 挑战文件、机读元数据——这套由 AGMAI 写入建议书、由 OpenAI 仓库落地的"组合件",大概率成为 AI 实验室发布数学成果的行业标配;形式化不再是加分项,而是公信力门槛。
判断二:发布规范正在制度化。"披露模型名/提示词/思维链/耗时/算力成本""成果发布不得作为营销工具""人类理解社区主导"三项原则,加上 600 余份社区反馈的背书,意味着后续任何一家实验室的"AI 重大科学成果发布"都将被置于这套模板下审视。
判断三:算力账本将常态化。从 First Proof 的"单题十美元到一千美元量级成本"到 OpenAI 的"每结果约 3 小时 Pro 思考",两套独立口径共同指向同一件事:AI 科研产出的成本透明化时代已经开始。
判断四:瓶颈从"证明"转向"理解"。陶哲轩在 ICM 演讲中警告,过度的 AI 优化可能使数学的诸多目标彼此分叉;Maggi 的"谁读得完"之问则是同一焦虑的日常版本。当产出的速度远超人类消化的速度,资金与制度如何流向"理解侧"——工作坊、博士生、阐释性专著——将决定这批成果的价值兑现周期。
保持谨慎的理由同样充分:OpenAI 承认未形式化结果可能有问题,本次没有任何结果经过同行评审,产出模型仍未发布、第三方无法复现其过程——数学史上,从"声称"到"定理"的距离从来以年计。
对产业而言,真正值得记录的不是某个具体猜想的成败,而是一个先例的确立:前沿实验室第一次以"可核验、可引用、可修正"的工程化方式,向科学共同体批量交付 AI 科研产出。至于这 722 份手稿中有多少能穿越审读与形式化的窄门,时间会给出答案——而数学界已经开始阅卷。