作者:老王
AI芯片自研正在从少数科技企业的技术选择,演变为大型计算需求方参与半导体产品定义的一种常态。推动这一变化的力量,来自业务规模、工作负载差异和持续计算成本之间的共同作用。企业一旦同时掌握用户需求、模型与软件路线,并承担长期算力支出,就有动力把芯片架构纳入经营决策。然而,这并不意味着每一家平台、模型公司或车企都应建设完整芯片公司。更具普遍性的变化,是需求方更深地参与系统和芯片定义,并与专业ASIC企业及制造供应商重新划分责任。
这一趋势会同时改变企业内部能力结构与产业链外部分工。自研企业必须从算力采购者成长为计算平台的定义者、验证者和运营者;专业ASIC企业则有机会从承接设计任务,延伸到可复用技术平台、联合开发和跨代供货。晶圆制造、存储、封装测试及装备企业面对的要求,也从单环节性能和产能,扩展到整个系统的成本、良率、进度与持续可获得性。地缘政治进一步使供应安全与市场准入进入技术路线的选择过程。
本文沿着市场机制、企业能力、产业链协同及商业回报展开分析。量化证据采用企业财务披露、官方技术资料与监管公告;收入数据采用已完成财年的可比口径,产品路线以公告时点为准。企业规划、参数声明与实际部署严格区分,图表用于支撑具体机制,不据此推算缺乏统一统计口径的全球自研芯片市场份额。
AI市场的结构如何推动客户参与芯片定义
消费电子时代已经存在软硬件垂直整合,自研芯片并不是AI创造的新事物。AI带来的变化,是芯片逐渐成为持续提供服务的生产资料。终端企业通常围绕整机出货、体验和物料成本配置芯片;云端AI企业则需要在设备生命周期内,不断把计算能力转化为训练成果、推理服务和业务收益。只要负载足够大、持续时间足够长,单位计算效率的改善就可能反复作用于经营结果。
AI计算需求也具有不同于换机周期的增长方式。用户数、调用频率、上下文长度、推理过程和工具调用次数,都可能改变每项任务的计算消耗。与此同时,模型压缩、量化、缓存和小模型路由又可能降低消耗。因此,计算需求具有较高增长弹性,却并不适合按照用户数作机械外推。自研立项需要判断哪些需求会长期存在,以及软件优化将怎样改变未来硬件的负载结构。
台积电的收入结构提供了观察这一转变的背景。其高性能计算平台收入占比由2022年的41%升至2025年的58%,增加17个百分点;同期智能手机占比由39%降至29%。这显示制造收入重心正在向计算基础设施移动,但HPC同时包含多类处理器与应用,不能等同于AI,更不能等同于客户自研。智能手机占比下降也不直接意味着其绝对收入下降。图1呈现的是平台结构变化,而非自研的因果估计。[1—3]
图1 台积电HPC与智能手机收入占比变化
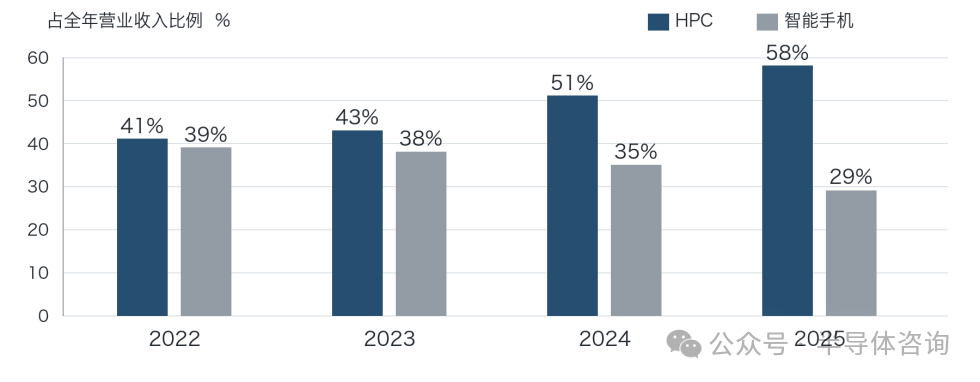
来源:[1—3],HPC为公司平台分类,不等于AI或客户自研芯片;占比变化不直接代表绝对收入变化。
自研最关键的信息优势,是需求方能够直接观察自己的工作负载。推荐平台知道哪些模型覆盖最多流量,云公司知道哪些资源长期形成瓶颈,模型公司能够较早判断下一代模型的计算和内存需求。专业芯片供应商面向多客户优化,而大型需求方可以围绕较窄的负载集合,在计算单元、内存、互联和可编程性之间选择更适合自身的资源配比。
推理进一步强化了这种经济联系。训练效率影响模型研发的成本和速度,推理效率则随用户使用持续影响服务成本。不过,推理也不是统一负载:输入处理与逐步生成对计算和内存的需求不同,实际瓶颈还随模型、并发、上下文和调度方式变化。NVIDIA的推理系统文档就强调,应根据具体运行条件决定输入处理与生成是否分离部署。[4]自研的合理起点因此应是真实瓶颈,而不是对峰值算力的追逐。
这种机制解释了为什么自研具有结构性动力,也说明其边界。需求尚小或变化过快时,通用平台的灵活性和生态价值可能更高;当负载可预测、内部可控制且规模足够大时,专用化更容易回本。行业更可能出现商用GPU、客户定制加速器和其他处理器共同部署的格局,同一企业也会按负载选择不同平台。
四类企业的自研动机与经济边界
互联网平台首先可以从已有的高频业务中兑现收益。广告、推荐和内容理解具有大量重复运行的生产负载,企业既可以用更低成本保持原有服务,也可以在相同成本下使用更复杂模型。如果模型效果改善能够增加业务收入,自研收益就不只表现为采购节省。相应地,验收需要同时观察计算成本和业务结果,不能用硬件效率替代模型效果。
云公司的优势在于部署、调度和服务交付。客户使用托管模型API时,底层芯片迁移主要由云平台消化;客户直接租用算力时,软件适配成本更容易暴露给客户。因此,自研能否规模使用,与服务交付形态密切相关。云公司还必须保留客户需要的商用硬件,使内部效率优化与外部生态需求相容。其自研决策应按服务组合评估,不能只计算内部芯片的制造成本。
模型公司最了解算法路线,却未必拥有同等成熟的半导体工业化与基础设施能力。联合开发、供应商协同优化和独立自研,因而是不同程度的选择。Anthropic披露与AWS合作优化后续Trainium,同时采用TPU、Trainium和NVIDIA GPU的多平台策略。[5—6]这一案例说明,获取模型与硬件协同收益,并不要求独立承担所有芯片研发、供应链及运行风险。
车企的逻辑则更接近整车系统优化。车载推理需要在确定的功耗、温度和实时性条件下,与传感器、控制器和软件共同工作。自研收益应按整套控制器甚至整车核算,包括芯片、内存、电源、散热、线束和软件维护。蔚来ET9的官方配置同时使用自研NX9031与外部供应商芯片,体现了按系统功能分工的实践。[7]车载自研也不自动延伸为云端训练芯片自研,两者的规模与技术约束并不相同。
汽车尤其需要审慎评估摊销基础。能够摊销固定投入的是芯片有效产品周期内、实际搭载该平台的车型累计交付量。公司总销量、远期销量目标及尚未落地的对外销售,不能直接视作已经获得的规模。跨车型复用有助于降低成本,但长期供货、质量追溯、多硬件代际维护和区域市场适配,也会增加固定投入。
四类企业都必须采用可比的全生命周期成本。研发、IP、EDA、流片、软件、制造、封装、网络、运营、迁移和备件应纳入统一边界,资本开支与折旧不可重复计算;分母则应是满足相同质量、延迟和可靠性条件的有效任务量。云端还要控制模型、输入输出长度和缓存等比较条件,车端则要在相同功能与可靠性要求下比较整套系统。
因此,制造成本下降并不保证单位服务成本下降。如果新平台利用率不足、算子覆盖不完整,或者迁移延误导致有效使用寿命缩短,硬件节省可能被抵消。立项还应与预计投产时的外购替代方案比较,而非永久使用立项时的外购价格。供应商的降价和技术进步,是自研投资必须面对的动态竞争条件。
Google TPU从内部需求走向云计算平台
Google TPU的起点早于本轮生成式AI热潮。Google在2017年论文中披露,第一代TPU自2015年进入数据中心,用于神经网络推理;论文选取的生产应用覆盖当时约95%的内部神经网络推理需求,并把第99百分位响应时间作为重要约束。[29]这里最有启发性的并非某一项峰值性能,而是需求方能够用真实业务确定设计边界:哪些计算反复发生、哪些延迟必须保证、哪些通用处理器功能可以舍弃。自研由此建立在可观测且集中的需求上,较容易把硬件取舍与实际收益连接起来。
这一案例也校正了对“AI周期必然带来自研”的理解。自研的经济机制长期存在,生成式AI扩大了能够兑现收益的计算规模,但规模本身不能替代需求控制力。Google拥有内部生产负载、模型研究、基础设施和云服务等相邻能力,能够将一代产品的运行结果反馈给下一代设计。其他企业复制TPU时,更应比较这些条件是否成立,而不是只比较可以投入多少芯片工程师。
TPU的演进进一步显示,自研对象会由加速器扩展为计算系统。2023年发表的TPU v4论文披露,其系统规模达到4096颗芯片,并引入光路交换和面向嵌入计算的SparseCore。[30]前者涉及集群拓扑与可用性,后者回应模型中特定的数据处理需求。这意味着架构团队必须同时理解矩阵计算、数据访问和分布式通信;编译、调度与运维也要参与产品定义。单颗芯片更快,如果不能降低通信等待和故障造成的损失,未必能缩短完整训练任务的时间。
以第七代Ironwood为例,Google Cloud的TPU7x规格表列出每颗192 GiB HBM和7380 GB/s带宽,系统可扩展至9216颗芯片;文档同时说明其双芯粒架构及相应编程方式。[31]这些是特定产品的配置参数,不是实际客户利用率或应用性能。其产业含义在于,HBM、芯粒互联、封装、供电和系统验证已经共同限制产品交付。供应商如果只在芯片设计完成后被动接单,就难以及时处理容量、接口和散热之间的约束。
Google在2025年11月的Ironwood公告中,把TPU放在模型训练、推理和云服务的统一系统中,并列举了Google及外部客户的模型使用。[32]从内部使用扩大到对外服务,可以增加需求来源,但也带来模型适配、租户隔离、可观测性、服务支持和容量管理的责任。因此,TPU商业化的评价单位应是客户能够持续购买和使用的计算服务,而非只看芯片数量。公开资料不足以推算Google的完整自研成本及净节省,不能用某项规格提升直接替代投资回报结论。
TPU对传统ASIC企业的启示,是需求方越深入参与架构,越需要能够把需求转成可靠工程的伙伴。机会可能来自高速接口、物理实现、封装协同、测试和制造管理,也可能来自跨代平台合作。不过,公开技术规格并不能确定某家供应商承担的具体设计范围、价格或利润分成。判断机会时,应区分可验证的技术需求与尚未披露的商业关系,避免把客户“自研”或供应商“参与”简单理解为某一方包办整个项目。
苹果从产品自研积累走向端云AI协同
苹果提供了一个与Google互补的参照。其自研积累形成于消费电子,说明系统公司参与芯片定义并非AI时代独有。2020年发布的M1延续了苹果在移动设备上的芯片经验,将CPU、GPU及其他功能集成于SoC,并采用统一内存架构;M1包含160亿晶体管和16核神经网络引擎。[33]这些历史参数说明集成范围,不能与数据中心加速器的峰值算力直接比较。苹果自研收益的主要衡量对象是整机体验与产品经营,包括续航、性能、功能和产品节奏,因此不能只用处理器采购价解释其决策。
苹果能否把硬件优势转化为用户价值,也取决于软件迁移。2020年公布Mac转向Apple silicon时,苹果同时提供Universal 2、Rosetta 2与开发者过渡资源,使原有软件兼容与原生应用开发能够并行推进。[34]这一安排说明,迁移工具是芯片投资的一部分:它降低用户切换成本,也为开发者争取适配时间。AI自研企业可以借鉴这种组织方法,但不能假定存在一种工具即可消除所有模型迁移工作;算子覆盖、数值精度、内存管理和性能调优仍需持续投入。
进入生成式AI阶段,苹果将原有的产品协同延伸到模型设计。其2025年技术报告介绍了约30亿参数的端侧模型,并采用KV缓存共享与2位量化感知训练等优化。[35]这些选择说明,模型团队也可以主动适应终端的内存和能耗条件,而不是把未经调整的云端模型直接交给芯片团队。对企业而言,这要求模型质量、内存占用、响应时间、发热和电池消耗进入同一评审过程;某项功能是否值得增加芯片面积,应与实际使用频率和产品价值共同判断。
端侧能力也有边界。苹果2024年公布的Private Cloud Compute采用Apple silicon服务器,并把硬件安全与软件验证纳入云端处理架构。[36]从商业分析看,端云分工要求同时核算终端新增硬件成本和持续发生的云服务成本。如果某项功能使用频率较低或模型变化很快,将全部能力固化到每台设备上未必经济;若请求高频且适合本地处理,端侧执行则可能改善响应、隐私和服务成本。具体结果取决于请求结构,不能预先假定端侧越多越好。苹果与Google还在训练环节形成直接联系。苹果2025年技术报告披露,其服务器模型训练使用8192个v5p Cloud TPU加速器,分为4组2048芯片切片。[37]这一数据只对应报告中的训练配置,并不代表苹果的全部算力采购。它清楚表明,拥有自研终端芯片和云端推理平台,仍可以选择外部训练基础设施。自研边界应围绕比较优势配置,而不是把所有计算环节内部化作为成功标准。
苹果案例对供应链提出的要求与大型TPU系统有所不同。终端侧更重视低功耗、系统集成、封装尺寸、批量一致性及按产品节奏交付;云端侧则需要另行处理计算扩展与运营可靠性。统一内存是一种系统架构安排,不能直接等同于HBM,更不能由苹果自研推导出所有存储、封装和装备环节按相同比例增长。两种路径都说明,自研企业应掌握产品定义和软硬件协调,同时保留专业供应链分工;它们也都无法仅靠拥有设计来消除制造、工具和区域供应风险。
自研企业需要建设计算平台能力
真正稀缺的能力,是把业务问题转换成可制造、可编程并且具有经济回报的系统。为此,企业首先需要建立跨业务、模型、软件和硬件的工作负载研究团队。其产出应包括持续更新的模型与请求分布、算子和访存画像、通信与功耗预算,以及一组可以用于设计和验收的代表性基准。与单次跑分相比,这套基础资料更能保护企业在芯片设计中的信息优势。
架构团队需要区分稳定规律与快速变化。多代模型共享的数据移动和计算模式,可以通过硬件强化;尚未稳定的模型细节则需要保留可编程性。AI变化快会提高自研的价值,也会增加押错架构的风险。芯片投产时的模型与立项时不同,因此不能把一代模型的全部特征过度固化。企业需要性能模拟与情景分析,判断增加带宽、缓存或算力的边际价值,同时评估工艺、面积、封装和软件代价。
Meta的MTIA路线提供了具体观察。其2026年3月公布的规划,将MTIA450的HBM带宽设为MTIA400的两倍,MTIA500再提高50%;以MTIA400为1,后两代分别为2和3。图2仅比较内存带宽路线,并按原公告保留部署状态,既不是实际应用加速倍数,也不代表截至本文日期已完成全部部署。[8]对企业能力建设的启示是,模型路线需要通过计算、内存和互联的资源分配,形成可被工程团队执行的设计决策。
图2 Meta MTIA的HBM带宽路线
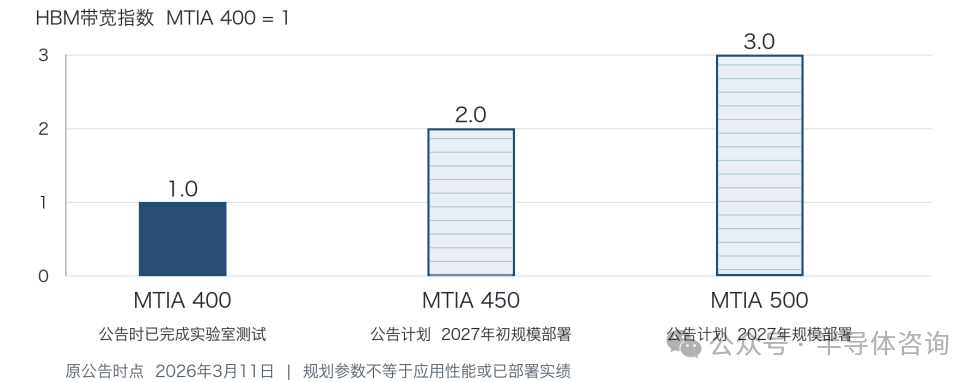
来源:[8],按2026年3月11日公告整理,MTIA400为基准。MTIA450与500为规划参数,横线填充表示公告中的后续部署计划;不表示应用性能倍数。
软件团队必须与芯片项目同期建设。AWS Neuron覆盖编译器、运行时、训练与推理库及性能分析工具,NKI支持底层算子开发和优化。[9]这说明自研芯片的商业产品实际上包含持续维护的开发平台。企业不必重建所有框架,却必须有能力缩短真实模型的迁移时间,定位性能问题,并支持新算子和多代硬件。软件开发者的时间与迁移成本,应进入芯片经济账。
验证也需要扩展到真实系统。功能正确、模型质量不退化、性能与功耗达标、长时间运行可靠,是不同层面的要求。虚拟原型、硬件仿真和FPGA原型可以把部分软件开发与验证提前到流片前;Synopsys的相关产品路线正服务于这一需求。[10]但工具不能决定测试是否覆盖真正重要的业务,最终验收仍应由使用芯片的业务及基础设施团队参与,避免设计团队仅选择最有利的场景证明成功。
工业化能力则把设计连接到稳定供货。即使选择ASIC伙伴提供一站式服务,自研企业也要配置产品工程、质量、供应链和技术采购能力,监督晶圆、存储、封装、测试、板卡与整机的进度。其内部团队必须能够评估良率、工艺变更、产能预约、质量责任和库存风险,不能将“委托执行”误认为不再承担交付责任。
这些能力需要统一的组织机制。较合理的安排,是由对业务结果负责的平台负责人协调需求、架构、软件、制造及部署,管理需求变更并决定阶段性投入。项目评审应分别判断需求是否成立、系统是否可行、样片是否达标、生产是否可用和收益是否兑现。流片成功是工程里程碑,尚不足以证明商业成功。资金安排还应覆盖首代爬坡、下一代开发和旧平台维护之间的重叠投入。
表1 自研企业需要掌握的责任与合作边界
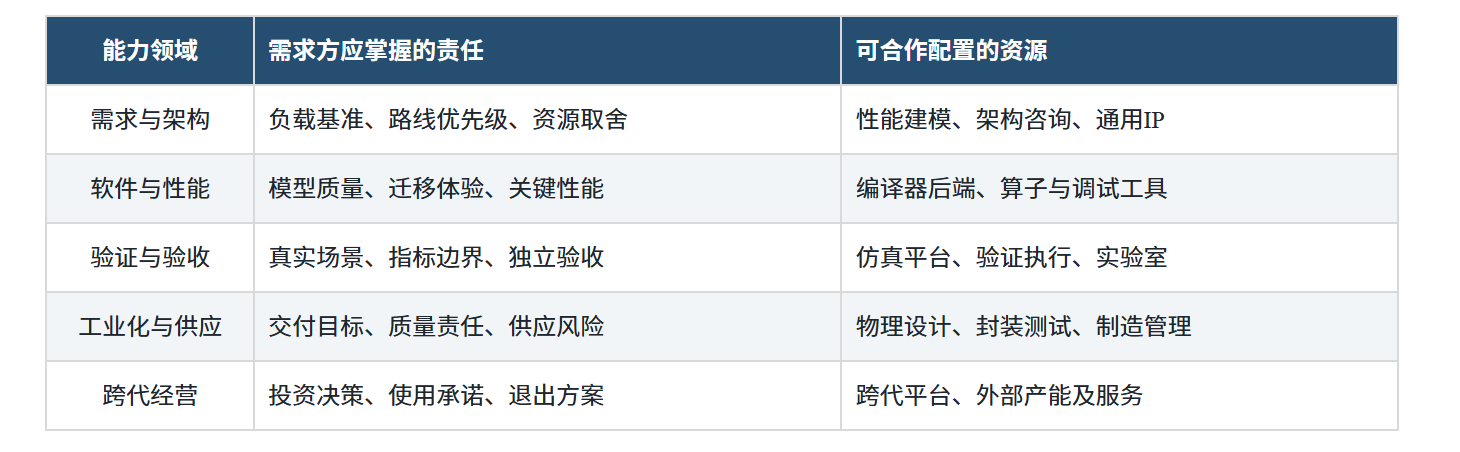
说明:本文分析。内部主导责任不等于全部工程内部执行;合作边界随企业能力和项目阶段调整。
能力配置的原则是掌握决定差异化和最终责任的环节,对可复用工程能力展开合作。模型路线、工作负载优先级、架构取舍和业务验收应由需求方主导;接口IP、物理设计、封装及部分底层软件可以联合开发。边界并非越靠内部越好,而应看内部化能否获得独有知识,以及外部伙伴能否通过跨项目复用提供更高效率。
产业链需要更早参与并共同承担交付
客户自研使上下游关系更紧密。设计服务商需要在需求和架构阶段参与,晶圆厂需要把工艺与产品目标连接,HBM和封装厂需要共同解决内存与数据移动问题,测试及装备企业需要把缺陷控制前移。产业链的评价指标由单颗芯片或单台设备的性能,扩展为在确定日期交付多少合格系统,以及每项有效任务的完整成本。
晶圆制造因此与封装平台进一步协同。台积电在2025年报中将CoWoS、SoIC等先进封装与三维堆叠作为支持高性能计算的重要技术。[11]多芯粒使计算、I/O等功能可以使用不同工艺,但也引入互联、测试与封装开销。芯片设计主体增加,并不必然分散制造环节:多个自研项目仍可能汇集到同一批先进工艺和封装平台。不同项目从GPU转向ASIC时,还需要区分制造份额转移与总需求净增加。
HBM的变化更能体现跨环节协同。SK海力士与台积电公布的合作,涉及以逻辑工艺制造HBM4基础裸片,并优化HBM与CoWoS集成。[12]存储器由此更深入地参与计算系统设计。接口、功耗、散热和认证需要共同安排,标准兼容也不等于更换供应商后无需验证。定制程度提高可以增加客户黏性,但也可能使库存难以转售,增加供应中断后的迁移成本。
制造资源的消耗同样不能只看存储容量。美光曾披露,同等位数的HBM3E所需硅面积约为DDR5的三倍,并预期后续代际的资源比例继续上升。[13]这一公司口径说明HBM需求可能影响整个DRAM制造资源分配,但三倍硅面积不等于三倍售价或利润,也不应推广为所有厂商和代际的固定参数。车端及成本敏感推理还可能采用其他存储体系,AI自研并不必然带来同等强度的HBM需求。
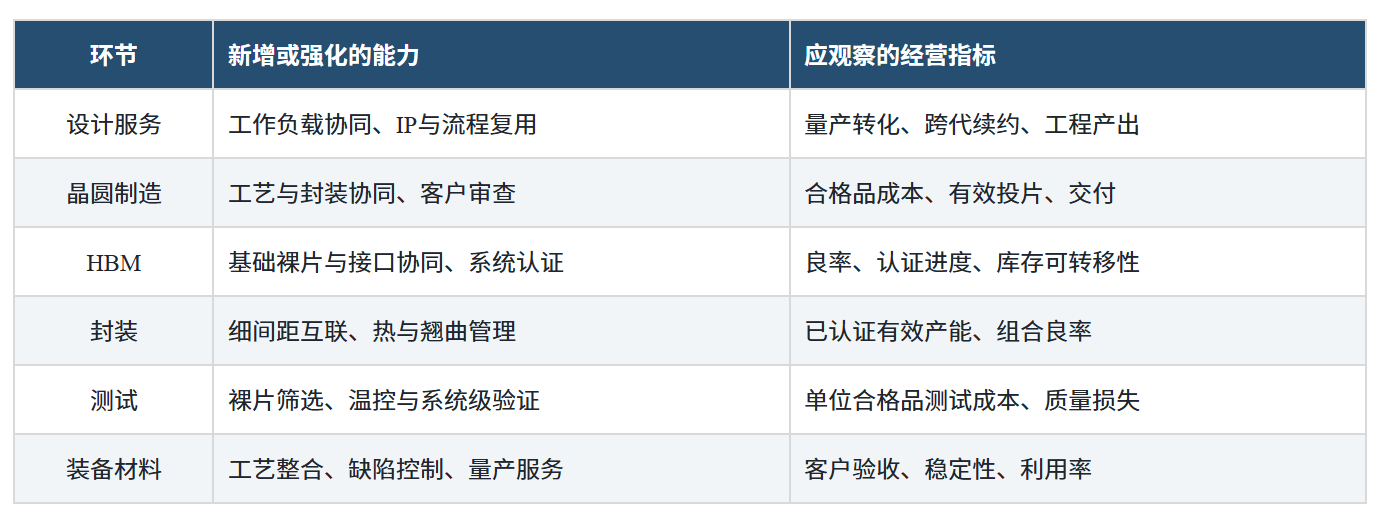
先进封装已成为架构约束的一部分。Broadcom的XDSiP平台把2.5D与三维集成纳入定制加速器设计,说明设计服务和封装技术正在交叉。[14]大尺寸封装、细间距互联和高功耗要求提升了对翘曲、热管理、供电及质量追溯的要求。传统封装产能无法直接等同于已获客户认证的先进封装有效产能,实际扩张仍取决于工艺、材料、设备与良率的共同成熟。
测试需求随组合价值提高而增加。若多个高价值裸片和HBM已经完成封装,缺陷造成的损失会更大,因此已知良品裸片筛选、组装过程验证和系统级测试具有更高经济价值。Advantest的V93000及相关存储测试方案覆盖AI与高性能计算的测试需求。[15]但增加测试会影响节拍,供应商最终需要证明单位合格品成本和质量损失改善,而非仅增加测试时间。
装备机会也应沿工艺变化判断。更先进逻辑、存储堆叠、细间距互联和大封装,分别对沉积、刻蚀、薄化、键合、清洗、量测及检测提出要求。Applied Materials与Besi的混合键合合作,体现了设备商参与工艺整合的方向。[16]不同键合技术仍可能在不同代际和场景并存;设备研发验证、客户量产验收与持续扩产,是三个不能混淆的阶段。
表2 自研需求对上游能力和经营指标的影响
说明:本文根据[11—16]及正文分析归纳。技术需求增长不等于所有供应商均匀受益。
上游供应商因而既获得新机会,也承担更强的项目相关性。客户的模型或产品延期,可能同时影响设计收入、晶圆预约、HBM交付和封装排程。供应链需要共享足够的预测与工程数据,并通过分阶段承诺明确变更和取消责任。厂商宣布的项目数量和理论产能,只有转化为已认证、可持续交付的产品,才构成稳定的经营基础。
专业ASIC企业获得新的客户边界与收入来源
需求方自研与ASIC企业成长具有互补关系。客户掌握不适合广泛共享的业务和模型知识,专业伙伴则积累可在多个项目复用的接口IP、设计流程、封装及量产经验。客户独立承担全部工程,会重复建设大量非差异化能力;ASIC企业独立定义全部产品,又难以获取客户内部的负载与路线信息。联合开发能够把两类知识结合起来。
博通的财务披露为这种机会提供了量化案例。其AI半导体收入由2024财年的122亿美元增至2025财年的202亿美元,公司披露同比增长65%,约占2025财年半导体收入的55%。[17—18]图3使用公司公布的四舍五入金额;该收入包含定制加速器及相关网络业务,不能视作纯ASIC收入,更不能作为整个行业规模。它支持的判断是,围绕大型AI客户提供计算与互联的组合能力,已经形成可观的业务收入。
图3 博通AI半导体收入变化
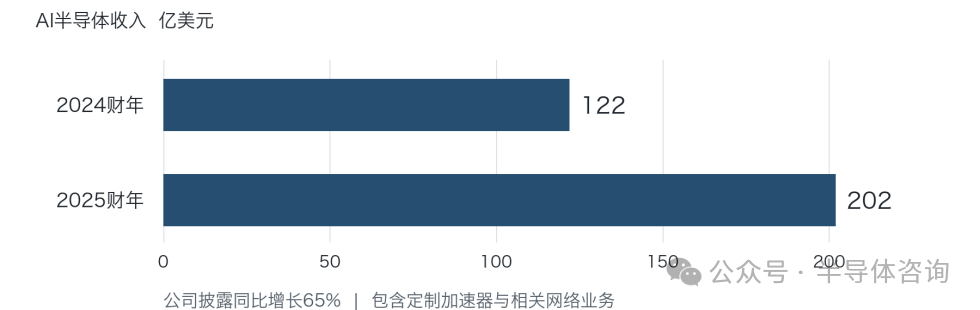
来源:[17—18],公司财年分别截至2024年11月3日与2025年11月2日。AI收入包含定制加速器及相关网络业务,不代表纯ASIC收入或行业市场规模。
市场机会覆盖不同深度的合作。客户拥有架构和RTL时,可以购买先进设计、封装及量产服务;客户缺少接口与子系统时,可以采用可复用IP平台;合作更深入时,ASIC企业可以参与架构和系统定义,持续交付多代产品。世芯电子公开的业务范围包含高性能ASIC设计、封装与生产服务,创意电子则披露了HBM及芯粒互联IP和CoWoS项目经验。[19—20]这些路线说明,传统设计服务可以通过工程复用和工业化能力形成更高门槛。
跨代合作进一步改变商业关系。Broadcom与Meta在2026年4月公布将合作延展至2029年的计划,说明客户自研可以为专业伙伴提供长期平台机会。[21]但未来合作计划不等于已经实现的收入。评估这类项目,应跟踪具体设计导入、样片验证、量产、部署及后续代际续约,而不能只使用远期算力或功率承诺估值项目质量。
ASIC企业自身也要升级。应用架构团队需要理解真实瓶颈,软件团队需要支持模型运行和性能定位,制造管理团队需要协调先进封装与存储,商业团队则要管理产能和资金承诺。若企业仍主要依赖增加工程师人数承接项目,收入规模增长可能伴随成本同比增加,难以形成平台收益。真正能够跨客户复用、经过验证的IP与方法,才有助于提高单位工程资源产出。
与此同时,定制业务天然面临客户集中和议价压力。大客户可能逐步收回部分设计工作,也可能要求更透明的成本;过深定制又会降低技术和库存的可转移性。合作合同需要区分基础IP与客户专属IP,明确数据和模型保密、需求变更、产能取消、软件维护及重新设计责任。对供应商而言,毛利额、现金转化、跨代续约和工程复用程度,比单纯营业收入更能反映商业质量。
地缘政治进入架构选择和投资回报
地缘政治会同时增强自研动机并限制自研的实现路径。企业可能希望降低对单一芯片供应商的依赖,但自主拥有架构并不等于自主获得EDA、IP、制造设备、晶圆、HBM和封装。供应链控制力需要逐环节评估;将部分设计搬到内部,不能自动解决关键投入品的可获得性。对受限制企业尤其如此,自研的战略收益只有在可交付的技术和制造路径上才能实现。
美国BIS在2024年12月公布的措施涉及特定HBM、半导体制造设备和相关软件技术,2025年1月又加强先进计算芯片相关的晶圆厂尽职调查要求。[22—23]这些案例说明合规问题可能在设计、接单和制造阶段就影响交付,不能等产品完成后再处理。架构、工艺、供应商及客户结构的选择,需要纳入具体适用规则的审查,芯粒拆分等技术方案也不当然改变监管适用性。
政策还存在变化。BIS在2025年5月宣布撤销此前的AI Diffusion Rule,2026年1月又宣布,在满足特定要求的情况下,对H200、MI325X等产品的相关出口许可逐案审查。[24—25]这些公告不能解释为所有先进计算交易均已放开,也不意味着旧限制在所有环节保持不变。企业需要为正常供货、许可延迟和关键环节不可得设置情景,并在重大投入节点更新判断。
地理分散能够降低部分风险,但需要完整链条支持。台积电2025年公布的美国扩张计划同时涉及晶圆、先进封装与研发,反映了区域制造生态的配套要求。[26]如果晶圆生产地改变,而封装、材料、设备备件和工程支持仍集中在原有地区,供应连续性依然受到约束。跨地区配置还会增加认证、库存、人才和初期利用率成本,不能把宣布投资直接等同于已经具备的独立交付能力。
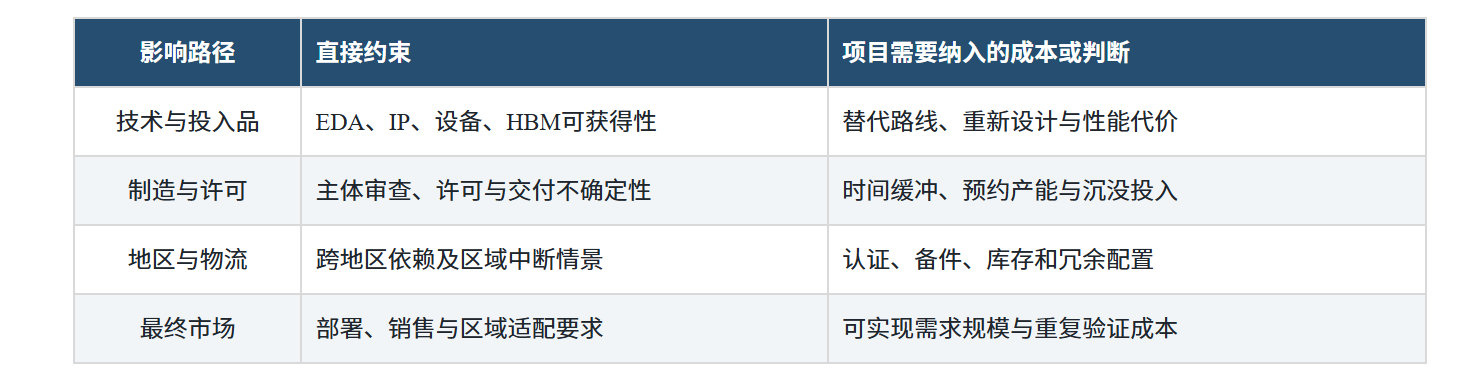
市场端同样受影响。美国2025年公布的联网汽车规则,针对与中国或俄罗斯具有特定关联的车联网硬件、软件及自动驾驶软件等交易设置限制,适用对象与实施节奏有具体区分。[27]这提示车企,统一自研平台未必能够在所有市场共享相同的装机基础。区域适配和市场准入会影响销量摊销,进而改变芯片投资回报。荷兰对先进半导体制造设备的出口管制调整,则说明供应路径还可能同时涉及多个司法辖区。[28]
表3 地缘政治影响项目的主要传导路径
说明:本文分析;政策事实见[22—28]。不构成对所有产品、主体或交易适用规则的统一判定。
因此,项目成本应包括供应链冗余、重新验证以及政策变化情景下的预期损失,同时避免对同一风险重复计价。备选方案也需要真实验证:不同工艺、IP和封装路线之间的切换,通常伴随重新设计和软件适配。只有明确切换时间、性能代价和资金需求,供应安全才是可以进入决策的能力,而非抽象口号。
从自研走向跨代经营
综合这些机制,自研潮更可能带来企业边界的重新安排。大型需求方把架构、软件和部署纳入长期经营,专业ASIC企业承担可复用技术与工业化,制造和存储供应商更早参与设计,封装测试及装备企业则通过良率和系统复杂度创造价值。单个环节的效率会越来越依赖相邻环节的配合,交付责任也需要随之明确。对自研企业,持续能力比首代成果更重要。内部应保留真实负载基准、跨代架构和软件、独立验收及全成本决策能力,并使研发投入与已验证需求匹配。对ASIC企业,最有价值的机会是把一次性工程沉淀成可复用平台,通过跨代合作提高工程效率和客户黏性。两类企业都需要保留面对模型变化、商用芯片进步和政策变化时调整路线的空间。
本文的核心判断是,AI市场推动需求方更深地参与芯片定义,而规模、技术和组织条件决定参与深度。自研不会消除专业分工,反而可能增加高质量设计、制造、存储、封装与软件协同的需求。最终能够获得长期回报的,是把业务知识转化为可持续交付的计算效率,并在技术迭代和地缘政治约束下保持经营弹性的企业。
资料来源
[1]台积电 2022年第四季度法说会简报。2023-01-12。全年平台收入结构,第7页。
[2]台积电 2023年第四季度法说会简报。2024-01-18。全年平台收入结构,第7页。
[3]台积电 2025年第四季度管理报告。2026-01-15。Net Revenue by Platform,2025年与2024年全年口径。
[4] NVIDIA Disaggregated Serving。动态文档。输入处理与生成阶段的资源差异及部署条件。
[5] Anthropic Powering the next generation of AI development with AWS。2024-11-22。与AWS共同优化后续Trainium。
[6] Anthropic Expanding our use of Google Cloud TPUs。2025-10-23。TPU、Trainium与NVIDIA GPU多平台策略。
[7]蔚来 ET9官方产品页面。动态页面。NX9031与其他供应商芯片的整车配置。
[8] Meta Four MTIA Chips in Two Years。2026-03-11。带宽路线、软件生态与公告时部署状态。
[9] AWS AWS Neuron。动态文档。编译器、运行时、库、开发工具及NKI。
[10] Synopsys Virtual Prototyping for Software Development。动态页面。流片前软件开发与系统验证方法。
[11]台积电 2025年年度报告。2026年发布。先进逻辑、CoWoS与SoIC技术发展。
[12] SK海力士 与台积电合作加强HBM技术领导力。2024-04-19。HBM4基础裸片与CoWoS协同。
[13]美光 2025财年第二季度业绩演示材料。2025-03-20。同位数HBM3E相对DDR5硅面积需求约3倍。
[14] Broadcom 3.5D XDSiP平台说明。动态页面。2.5D与三维集成用于定制加速器。
[15] Advantest V93000 SoC Test Systems。动态页面。AI与高性能计算相关测试能力。
[16] Applied Materials Next Gen Chipmaking Products to Supercharge AI Performance。2025-10-07。逻辑、HBM、先进封装及与Besi合作。
[17] Broadcom 2024财年第四季度及全年财务结果。2024-12-12。AI收入122亿美元,包含XPU与以太网网络组合。
[18] Broadcom 2026年股东大会委托书DEF 14A。2026-03-02。2025财年AI收入202亿美元及同比65%。
[19]世芯电子 Alchip Introduces 2nm Design Platform。2025年发布。先进ASIC、封装与制造管理服务。
[20]创意电子 GLink与HBM IP及CoWoS生产经验资料。2024—2025年资料。芯粒互联、HBM与生产项目能力。
[21] Broadcom 与Meta延展MTIA合作公告。2026-04-14。跨代合作计划延展至2029年。
[22]美国BIS 先进半导体制造及HBM出口管制公告。2024-12-02。特定HBM、制造设备及软件技术。
[23]美国BIS 先进计算芯片与晶圆厂尽职调查公告。2025-01-15。先进计算相关制造与客户审查。
[24]美国BIS AI Diffusion Rule撤销相关公告。2025-05-13。政策调整与原规则执法安排。
[25]美国BIS 对华半导体出口许可审查政策调整。2026-01-13。H200、MI325X等在特定条件下逐案审查。
[26]台积电 宣布扩大美国投资意向。2025-03-04。当时公布的晶圆、先进封装与研发配套计划。
[27]美国BIS 联网汽车供应链最终规则公告。2025-01-14。特定车联网硬件、软件与自动驾驶软件交易限制。
[28]荷兰政府 先进半导体制造设备出口管制调整。2025-01-15。2025年4月1日起的国家出口管制措施调整。
[29] Google Research In-Datacenter Performance Analysis of a Tensor Processing Unit。2017年论文。自2015年部署的TPU及生产推理负载与延迟约束。
[30] Google研究团队 TPU v4 An Optically Reconfigurable Supercomputer。2023-04。4096芯片系统、光路交换及SparseCore。
[31] Google Cloud TPU7x Ironwood技术文档。动态文档。采用规格表口径:192 GiB HBM、7380 GB/s带宽及双芯粒架构。
[32] Google Cloud Announcing Ironwood TPUs General Availability。2025-11-06。训练、推理及云服务部署说明。
[33] Apple Apple unleashes M1。2020-11-10。SoC集成、统一内存及160亿晶体管与16核神经网络引擎。
[34] Apple Mac transition to Apple silicon。2020-06-22。Universal 2、Rosetta 2与开发者过渡资源。
[35] Apple Machine Learning Research Foundation Language Models Tech Report 2025。2025-07。约30亿参数端侧模型、KV缓存共享及2位量化感知训练。
[36] Apple Security Research Private Cloud Compute。2024-06-10。Apple silicon云端节点与安全架构。
[37] Apple研究团队 Foundation Language Models Tech Report 2025全文。2025-07初版。第4.3节:8192个v5p Cloud TPU及4组2048芯片切片。