相聚 ICCAD,共话 AI 时代的芯片创新
11月19日至20日,2026集成电路发展论坛(北京)暨第三十二届集成电路设计业展览会(ICCAD-Expo 2026)在北京亦庄·北人亦创国际会展中心举行。本届大会以“芯聚北京,智联世界”为主题,通过高峰论坛、专题论坛与产业展览,汇聚芯片设计、IP、EDA、制造、封装测试及系统应用等产业链各环节力量,共同探讨技术演进与产业协同的新机遇。
围绕 AI 算力发展对高速互连与内存带宽提出的新要求,芯耀辉携 PCIe 6.0、112G SerDes 等多款前沿、高价值的高速接口 IP 及硅上实测成果亮相。从展台上的实测眼图、面对面的技术交流,到高峰论坛上的系统级思考,芯耀辉与客户及生态伙伴共同探讨,如何让数据更高效地流动,让芯片的性能潜力转化为系统中可用的有效算力,也让先进接口技术更扎实地走向客户应用。
展台亮点
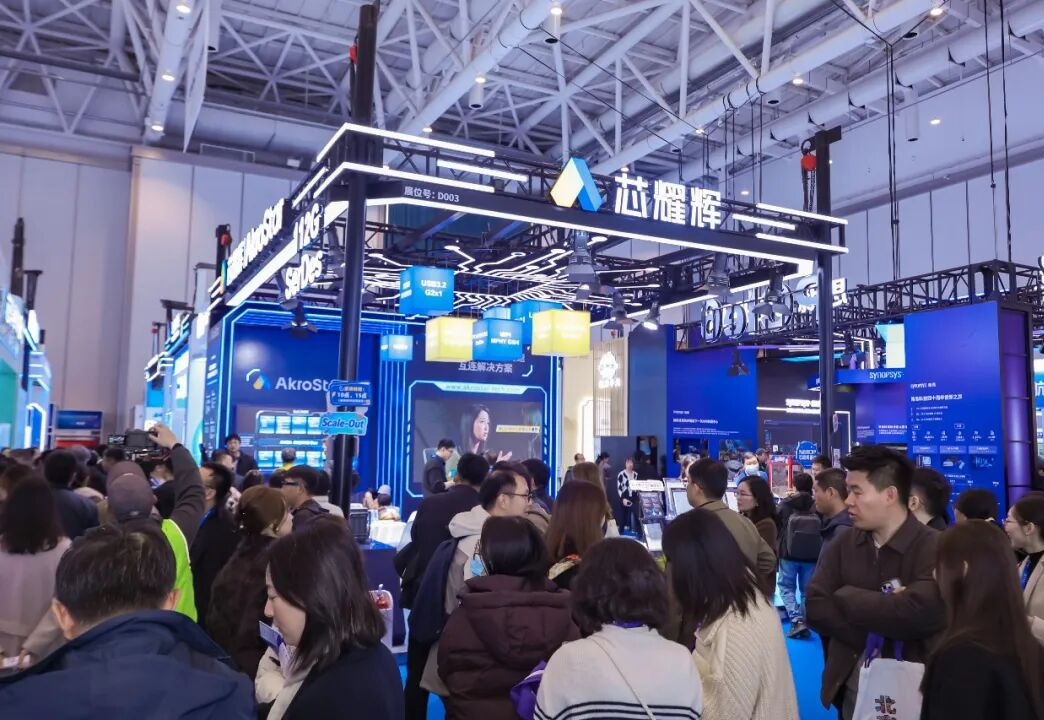
两组硅上实测眼图,让高速互连看得见
PCIe 6.0 与 112G SerDes,把高速接口实验室搬到展台
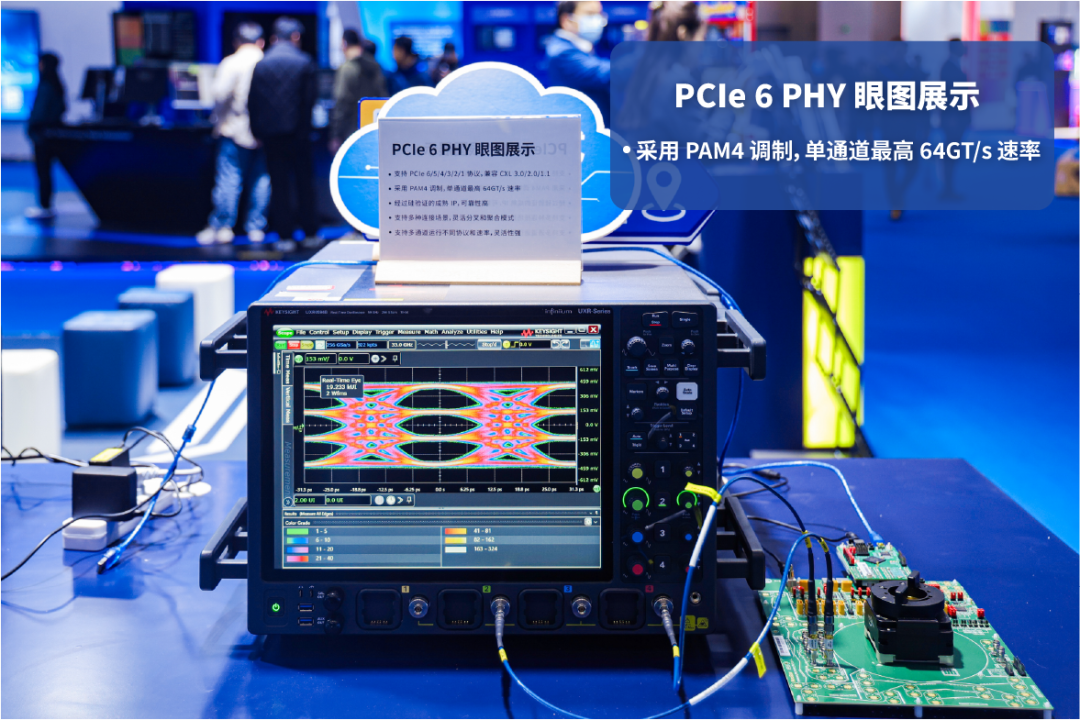
本届 ICCAD,芯耀辉展台的两组硅上实测眼图成为现场交流的焦点。PCIe 6.0 PHY 与 112G SerDes PHY 两款自研的前沿高速接口 IP,通过示波器展示发射端实测眼图,让 PAM4 高速信号的四个电平、三只“眼睛”直观呈现在观众面前。从眼图形态到板级误码测试结果,从通道损耗到实际设计裕量,现场交流围绕工程师关心的问题展开。高速接口 IP 在真实系统中表现如何,也因此有了更具体的讨论依据。
PCIe 6.0 PHY实测眼图
单通道速率提升至 64 GT/s,PAM4 信号的电平间距随之收紧,对收发器设计提出了更高要求。芯耀辉自研的高性能 PCIe 6.0 PHY 首次流片即成功,硅上实测发射端电平线性度(RLM)在最差情况下仍高于 98%。在板级测试中,面对 40 dB 链路损耗(比规范标称的 32 dB 高出 8 dB)及叠加 1 mV 串扰的严苛条件,两块评估板之间的原始误码率仍处于 10⁻⁸ 至 10⁻⁹ 量级,比规范要求的 10⁻⁶ 低两到三个数量级。展台上的 PAM4 实测眼图,与板级测试数据相互印证,展现了这款 PHY 在高损耗链路下依然充足的设计裕量。
112G SerDes PHY实测眼图
针对 AI 网卡、高带宽交换芯片等应用,芯耀辉自研的高性能 112G SerDes PHY 展示了单通道 112 Gb/s 下的发射端实测眼图。在样片测试中,该 PHY 在 42 dB 的高损耗通道条件下,仍测得 10⁻⁹ 量级的原始误码率,为长距离互连留出了充足裕量。围绕封装、PCB 走线与连接器带来的通道挑战,芯耀辉团队与现场观众展开深入交流,将示波器上的信号表现与具体应用中的板材选择、走线长度及功耗预算联系起来,共同探讨高速互连的实现路径。
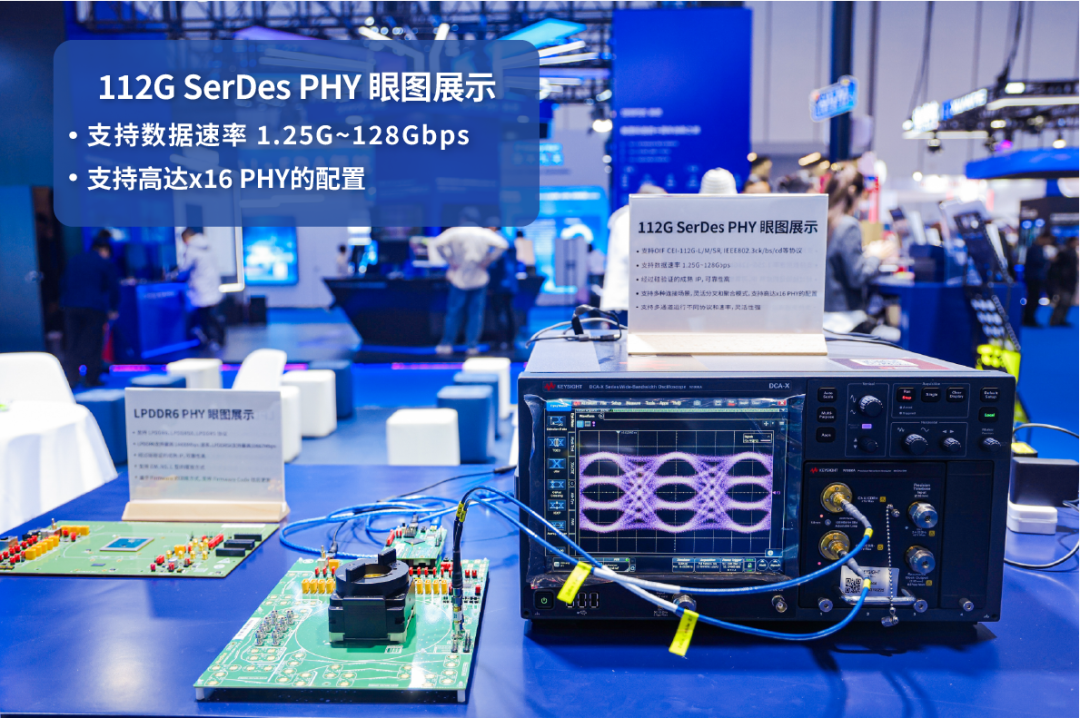
展台同时静态展示了 LPDDR6 板卡,呈现芯耀辉面向低功耗、高带宽内存访问的新一代接口 IP 布局。从芯片与内存之间的数据交换,到板卡及节点之间的高速互连,多类高速接口共同支撑 AI 系统的数据传输需求。
两场开放技术演讲,让交流从屏幕前延伸到应用中
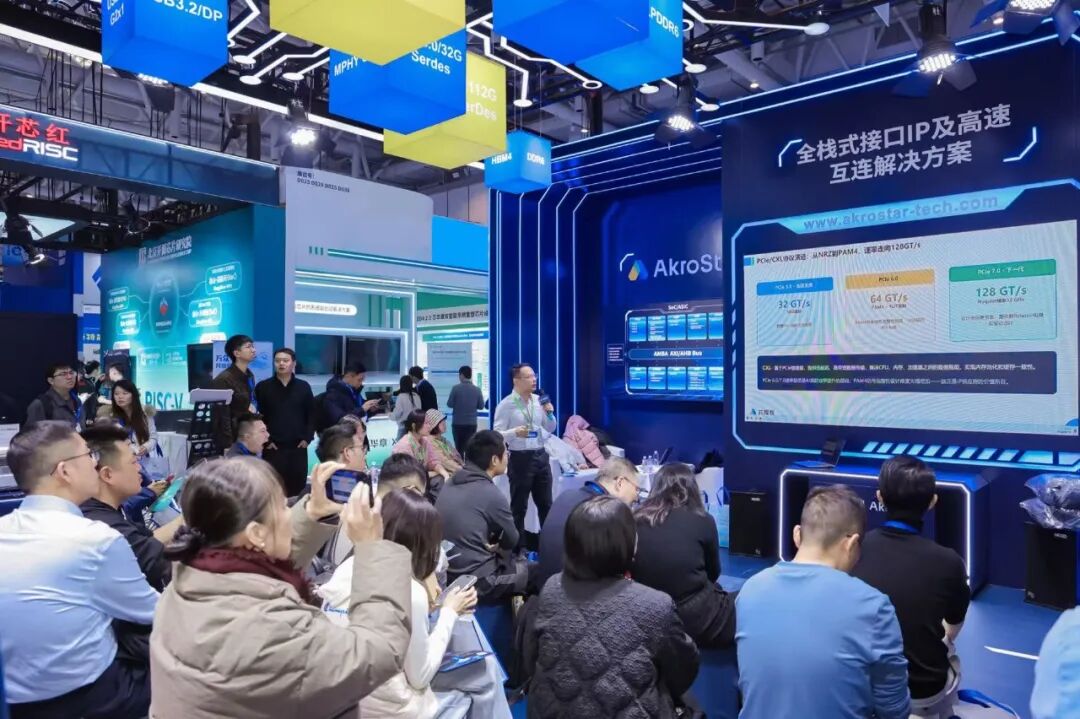
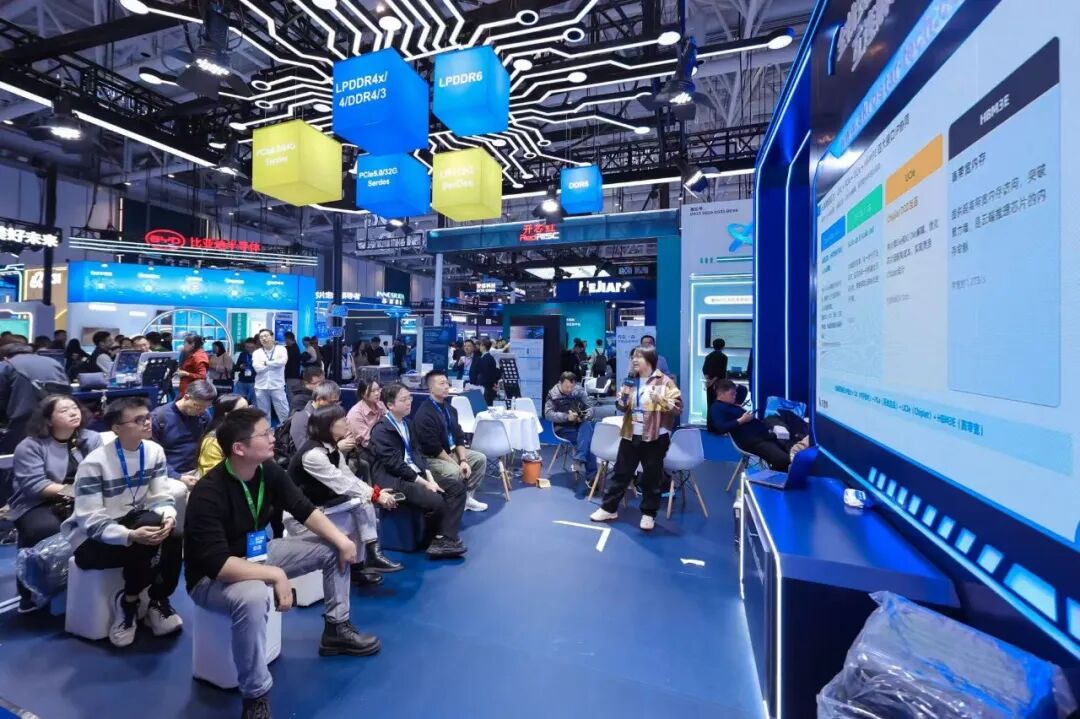
展会期间,芯耀辉在展台举办了两场免费开放的技术演讲:第一场《从Chiplet到集群——芯耀辉一站式IP赋能AI/HPC芯片设计》,第二场《芯耀辉一站式IP赋能AI云端推理芯片和边缘推理芯片设计》。两场演讲吸引了众多观众驻足聆听,展台前交流气氛热烈。技术团队结合产品特点与应用需求展开分享,观众积极参与互动,围绕关心的问题踊跃提问,现场讨论不断深入。从集中聆听到会后一对一交流,大家在轻松、开放的氛围中交换观点、分享经验。一次次具体问题的讨论,也让芯耀辉进一步听到客户在设计与应用中的真实需求,为后续技术合作积累了更多共识。
高峰洞见
从峰值算力走向有效算力
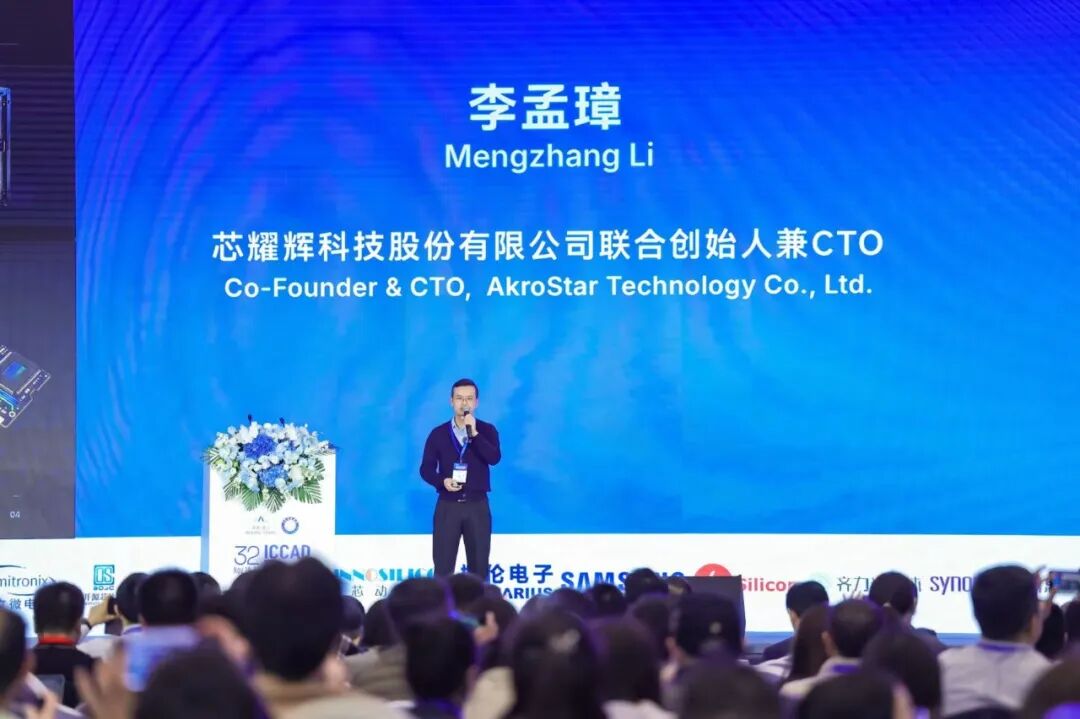
高峰论坛上,芯耀辉联合创始人兼 CTO 李孟璋带来《重塑 AI 算力底座:从单点 IP 迈向全栈系统级的优化赋能》主题分享,围绕 AI 算力面临的互连挑战,介绍芯耀辉从高速接口 IP 出发,推动芯片、封装与板级协同设计的实践。
数据走的每一跳,都关系到算力能否充分发挥
随着 AI 系统向超节点演进,峰值算力持续增长,系统的实际效率却越来越取决于数据能否及时、稳定地送达计算核心。李孟璋从性能墙、内存墙与互连墙出发,将数据传输路径拆解为三个关键环节——芯粒之间、芯片与内存之间,以及计算节点之间。UCIe、DDR、HBM、PCIe 与高速 SerDes 等接口技术,分别承担着这些环节中的连接任务,也共同影响整条数据链路的带宽、时延与功耗。芯耀辉的全栈系统级赋能,正是围绕完整数据路径展开,让数据以足够的带宽、合理的功耗和可量产的方式流动,帮助客户将芯片性能转化为系统效率。
用硅验证成果,回答真实系统中的工程问题
演讲中,李孟璋结合 UCIe、LPDDR6、PCIe 6.0 与 112G SerDes 的硅验证成果,介绍了芯耀辉在芯粒互连、内存接口与高速串行互连方面的技术进展。其中,UCIe 测试芯片单通道最高速率达到 32 GT/s,支持标准封装与先进封装。LPDDR6 测试芯片发射端实测速率达到 14.4 Gb/s,并完成与 12.8 Gb/s DRAM 颗粒的联调。
这些结果背后,更值得关注的是接口 IP 在客户实际系统中的适用性。充足的信号与通道裕量,有助于增加封装及板级设计的灵活性,为系统成本优化提供空间。而从测试芯片走向客户产品,还需要持续应对真实通道、复杂环境及系统集成带来的挑战。
将协同设计前移,让量产更有确定性
如何将硅验证成果转化为可复制的工程能力,是此次分享的另一重点。
芯耀辉通过融合接口架构、高速信号处理算法、SI/PI 设计方法学与快速工艺移植平台,将不同产品与项目中积累的经验持续沉淀到研发体系中。同时,向客户研发早期延伸,参与芯片布局规划,开展芯片、封装与 PCB 的协同设计,并在流片前推进系统级签核,尽早识别和处理影响系统表现的关键问题。
李孟璋强调,芯耀辉希望通过全流程的工程支持,帮助客户缩短芯片点亮与调试时间,提高一次流片成功和后续量产的确定性。“算得快、算得好,还要传得快、跑得稳、可量产。”这一目标,也需要芯片设计客户、晶圆制造与封装测试伙伴、硬件与整机厂商共同参与。芯耀辉期待与产业链伙伴更早开展架构讨论与协同验证,将各环节的技术优势落实到客户项目中,释放 AI 系统的整体效率。
期待明年,再次相见
感谢每一位来到芯耀辉展台、参与技术交流的客户、伙伴与行业同仁。
示波器前的驻足、演讲现场的提问,以及一次次围绕实际项目展开的讨论,都让这次相聚更加充实。芯耀辉将继续推进前沿高速接口 IP 的研发与硅验证,深化从芯片到系统的协同设计,与大家共同推动更多创新走向应用。期待将本次展会上的交流,延续为更多项目中的携手合作。明年 ICCAD,我们再见!