10月13日上午,由国芯展主办、半导体行业观察承办的第二届工业算力芯引擎研讨会在上海市国家会展中心举办。壁仞科技AI框架架构副总裁丁云帆在会上发表了题为《光互连GPU超节点,引领智算“芯”发展》的主题演讲。
丁云帆认为,Agentic AI时代,大模型落地正面临着前所未有的机遇与挑战。从大模型结构看,业界正从Full Attention走向线性/混合Attention;从参数规模看,已出现Kimi K3这样2.8万亿参数的超大模型,明年大模型参数或将迈入5万亿级别;此外,代码、Agent等应用场景也驱动了1M级超长上下文的需求。
在大模型结构日趋复杂、参数规模和上下文长度持续突破的背景下,超节点与PD分离技术成为破局关键。即通过高速低时延通信提升大规模EP专家并行的效率,并通过PD分离降低预填充与解码之间的相互干扰。
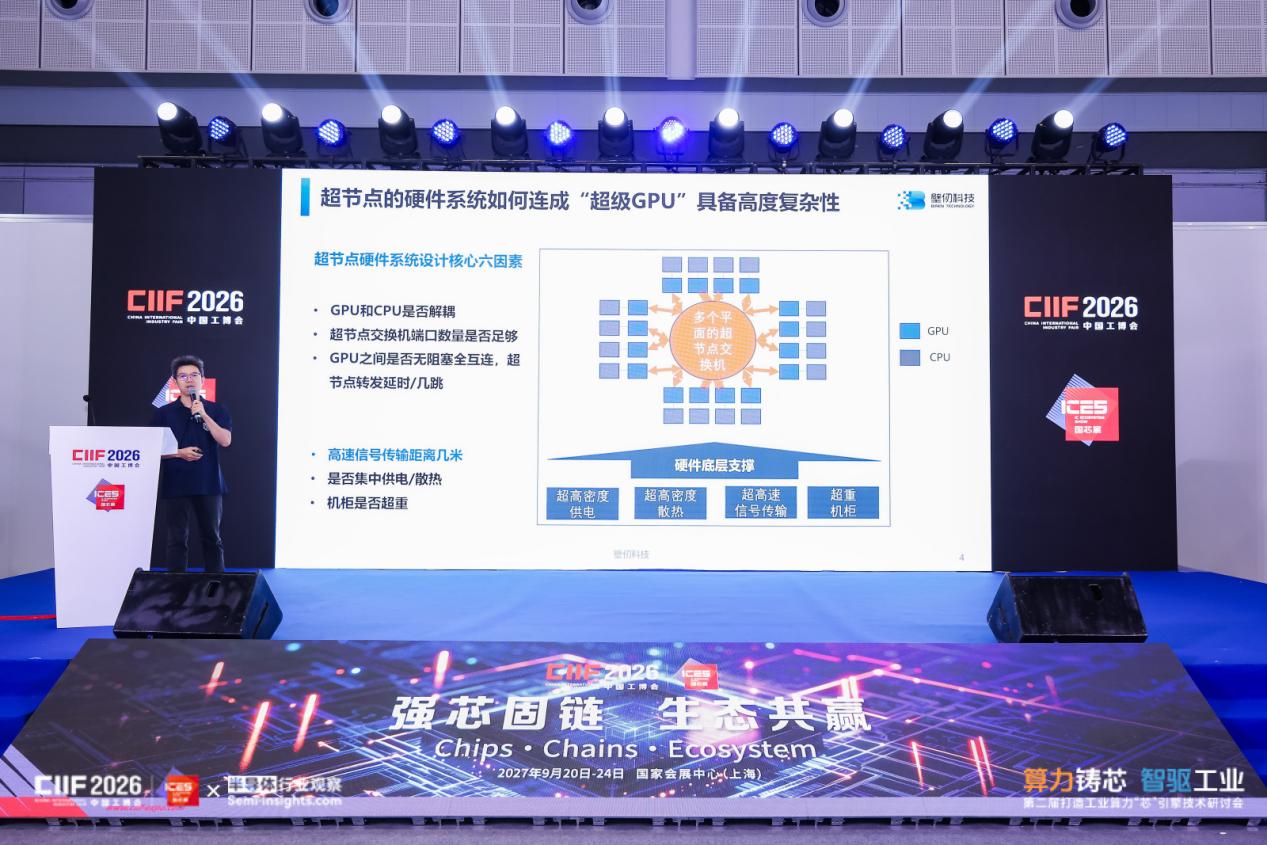
不过,超节点硬件系统本身也具有高度复杂性。要将大量GPU连接成一个对软件透明的超级计算机,超节点需要具备超高的互连能力:GPU端口数量要足够多、带宽要足够高,同时Scale up网络的延迟要足够低。
目前,主流超节点架构可分为Cable Tray、正交背板和融合架构三类。然而,高密整机柜电互连的持续演进正面临挑战。现有典型电互连架构最大仅支持128卡,难以进一步扩展。当大模型参数量达到5万亿级别时,64卡、128卡的超节点已很难提供理想的性价比。与此同时,随着GPU算力持续增长,互连带宽将超过1TB/s,端口速率将达到224Gbps。在此趋势下,光互连成为必然选择。
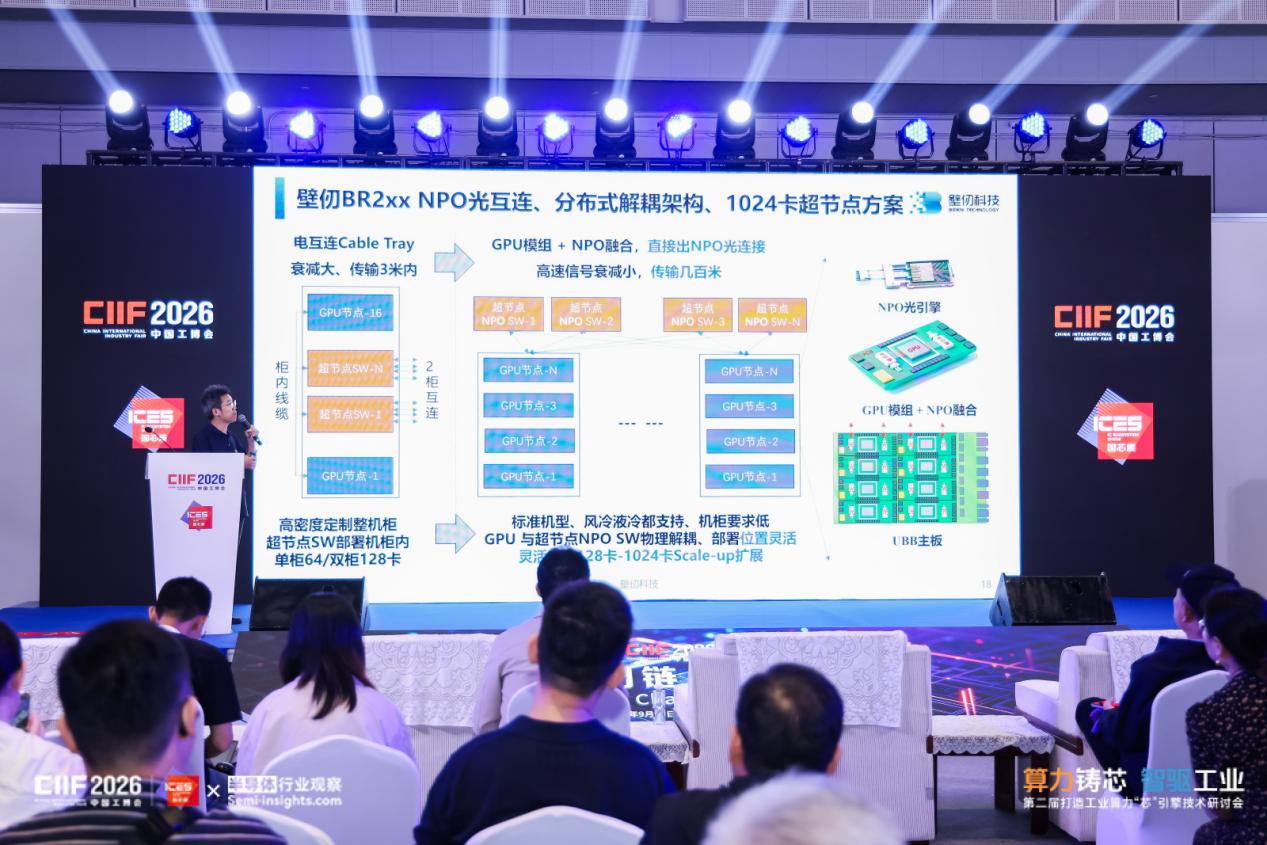
壁仞科技在光互连领域早已前瞻布局。2025年,壁仞科技联合曦智科技、中兴通讯推出基于分布式dOCS的光互连超节点解决方案,并斩获WAIC 2025 SAIL大奖。2026年WAIC期间,壁仞科技进一步推出下一代NPO光互连、分布式解耦架构超节点方案,支持单个超节点扩展至1024卡,形成覆盖芯片、协议、系统和应用的端到端解决方案。
值得注意的是,超节点的核心虽是高速互连,但同样离不开硬件底层的支撑,例如超高密度供电、超高密度散热和超重机柜。
壁仞科技的NPO光互连、分布式解耦架构超节点方案的优势恰恰在于,无需定制化高密机柜,采用标准化机柜即可;同时,由于光互连在长距离传输中信号几乎无损耗,计算节点与交换节点得以分离部署,超高密度散热、超高密度供电、超重机柜等带来的数据中心承重、运维等难题随之大幅化解。
超节点不仅仅是硬件的互连,也需要统一内存语义等软件能力。在协议层面,壁仞科技自研的BLink™2.0超节点互连协议,是连接所有GPU的“神经系统”。其核心能力可概括为四个方面:一是内存语义互连,让最多1024张GPU共享同一内存空间,多卡如同一台“超级GPU”;二是在网计算,将通信中的数学运算下沉到交换机完成,为GPU减负;三是智能拥塞控制,有效避免网络堵塞;四是多层链路自愈,从物理层到框架层逐级防护,保障训练推理不中断。
基于BR2XX系列GPU和BLink™2.0协议,壁仞科技构建了三级超节点产品矩阵:16卡标准服务器超节点(电互连)、128卡高密整机柜超节点(电互连),以及1024卡分布式解耦架构超节点(NPO光互连)。其中,16卡/128卡超节点适用于中小客户及千亿至万亿参数的落地需求;NPO光互连大规模扩展超节点则尤其适用于大客户及数万亿参数场景。客户可按需选择、灵活扩展。在应用层面,壁仞科技还推出了“Token工厂”解决方案。
从电互连到光互连,壁仞科技正以开放自主的超节点方案,推动千卡级Scale up互连走向现实,国产算力的“超节点时代”已然启幕。