10月8日电 光子计算凭借高速传播、天然并行和低能耗潜力,为突破人工智能算力与能效瓶颈提供了重要技术路径。然而,光子芯片的训练仍普遍依赖离线数字建模,实际器件不可避免地受到制造偏差、损耗和复杂光场传播的影响,使数字模型难以完全反映芯片的真实物理状态。现有原位训练方法往往受限于特定光路拓扑,难以适配复杂光子系统。能否直接在真实光子硬件中获得梯度,让芯片依据自身物理状态完成训练优化?针对这一问题,清华大学电子工程系方璐教授课题组提出INSPIRE物理梯度原位训练架构,将梯度计算直接引入光子硬件,实现光子系统的精准原位训练与高效优化。
片上物理梯度,让训练成为光子硬件的内在能力。基于合成时间反演(Synthetic Time-Reversal)原理,团队在光子芯片上构建STR硬件单元,设计与正向传播相对应的共轭光路,将网络正向传播的数据光场与反向传播的误差光场引导至同一位置,并通过片上全息测量获得两者的复光场及干涉关系。光场之间的干涉关系包含损失函数对器件参数的梯度信息,基于洛伦兹互易原理,系统可直接从真实光场中获得训练所需的物理梯度,无需依赖高精度全波数值仿真。由此,光子芯片能够依据器件中的光传播状态获得梯度并完成参数更新,使训练过程直接发生在真实光子硬件中,实现原位学习。由于梯度获取依赖光场之间的物理关系,而非特定光路拓扑,INSPIRE可进一步适配散射介质、波导Mesh网络等不同类型的光子计算架构。
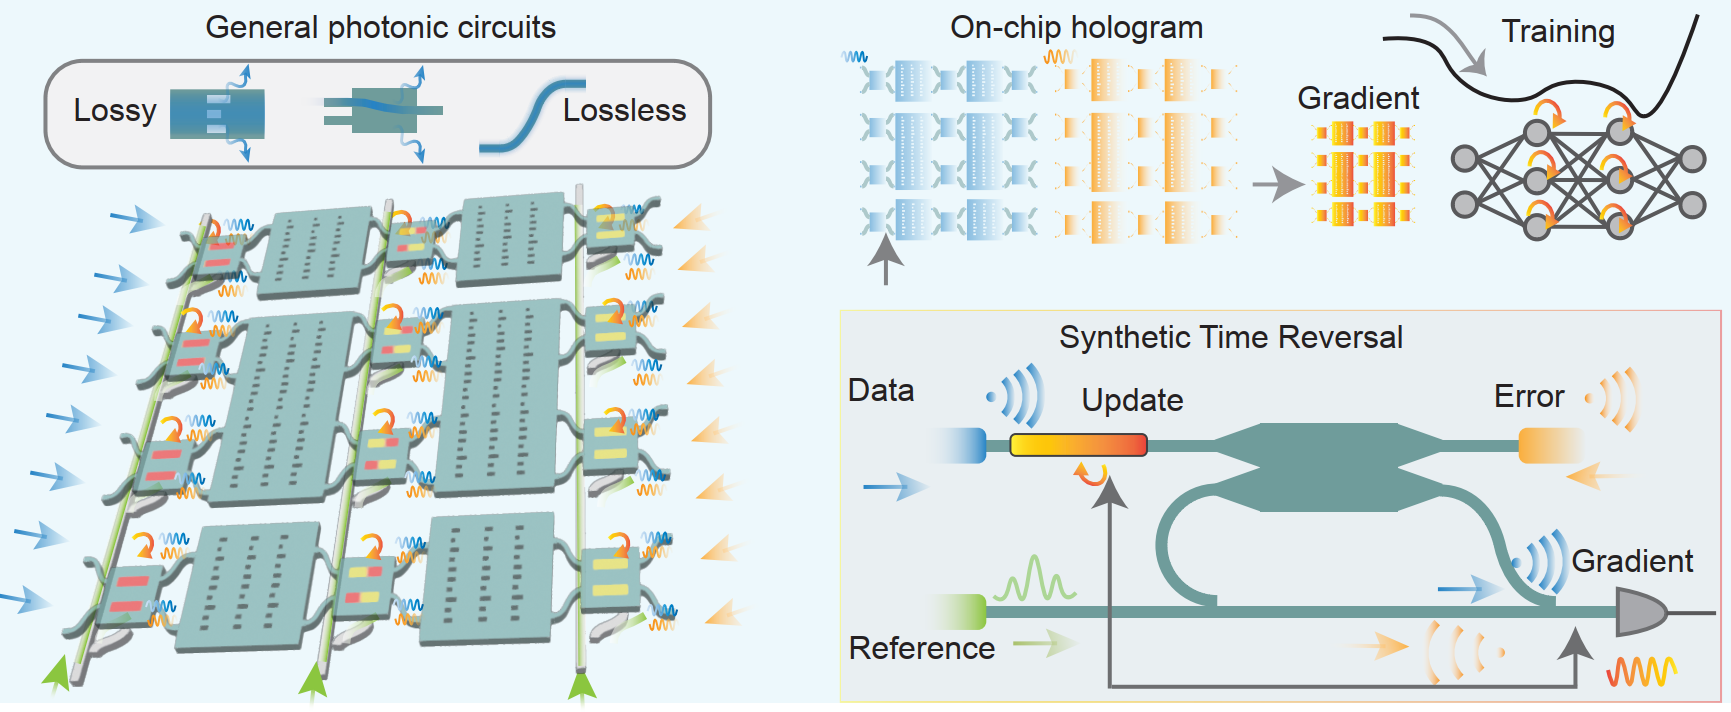
INSPIRE原位物理梯度训练架构
从原位优化到快速适配,释放复杂光子系统的学习能力。原位物理梯度不仅能够修正真实器件中的误差,也为挖掘复杂光学系统的高维物理响应提供了新的训练方式。借助散射介质的空谱色散特性与STR阵列的原位训练能力,团队在仅16个可调单元的芯片上,同时利用4个波长,实现独立的4×4复矩阵映射计算,拓展了有限物理调控单元可承载的计算维度。针对流片过程中引入的散射结构形变,经过200轮原位训练,平均均方误差由0.53降低至0.0012~0.0014,验证了INSPIRE在复杂散射和器件非理想条件下的原位优化能力。
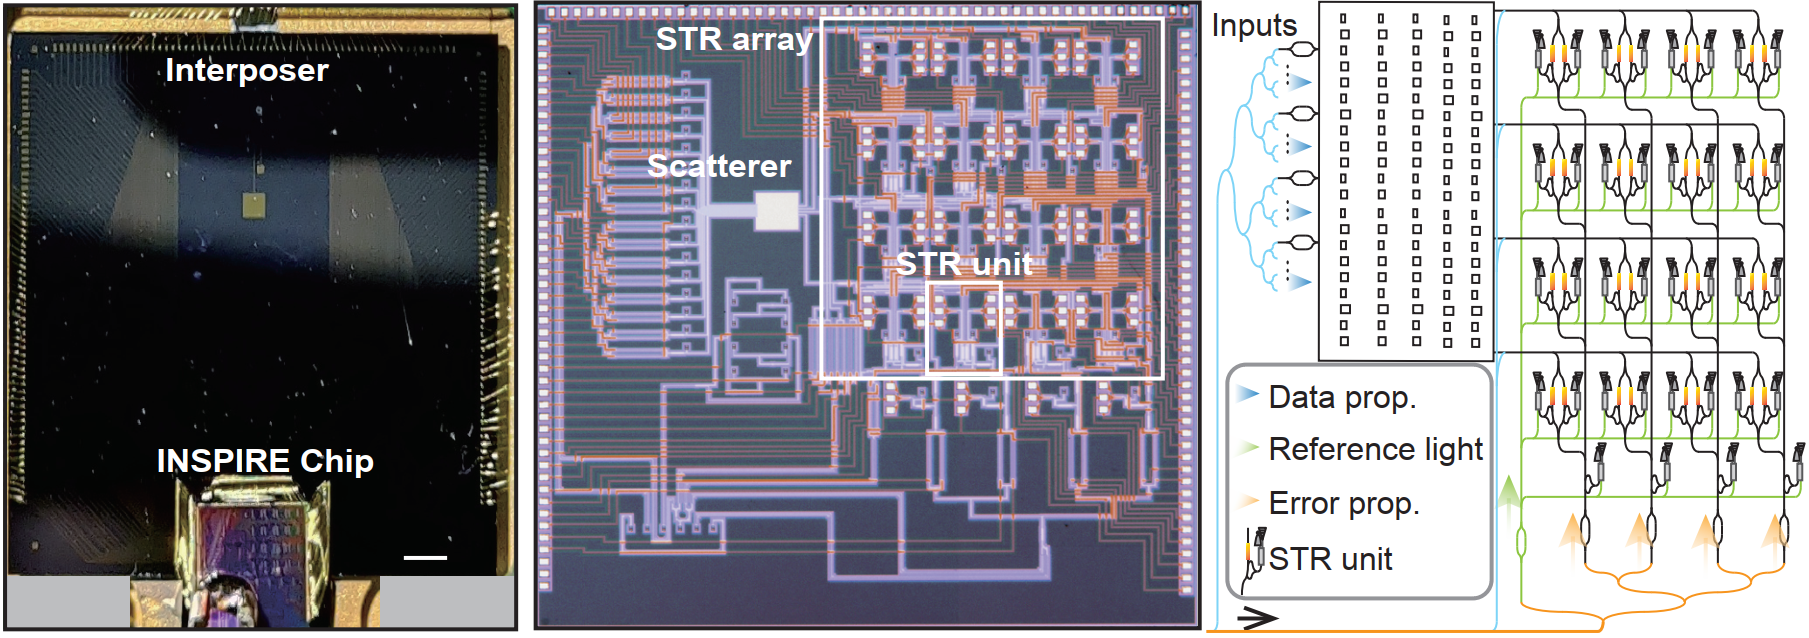
光子芯片实物与梯度探测光路
物理梯度的意义并不止于器件误差校正,更在于赋予光子硬件面向新任务的学习与快速适配能力。团队进一步构建“无源散射预训练+有源STR快速适配”的光子元学习架构,无源散射层预先学习并固化不同任务间共享的通用特征,仅由STR阵列对新任务更新少量参数,等效模型压缩比达251倍。在Omniglot单样本学习任务中,INSPIRE仅需1次迭代,5分类和20分类任务准确率可分别达到100%和92.7%。相比全参数重新训练所需的87次和136次迭代,大幅降低了新任务适配的训练开销。
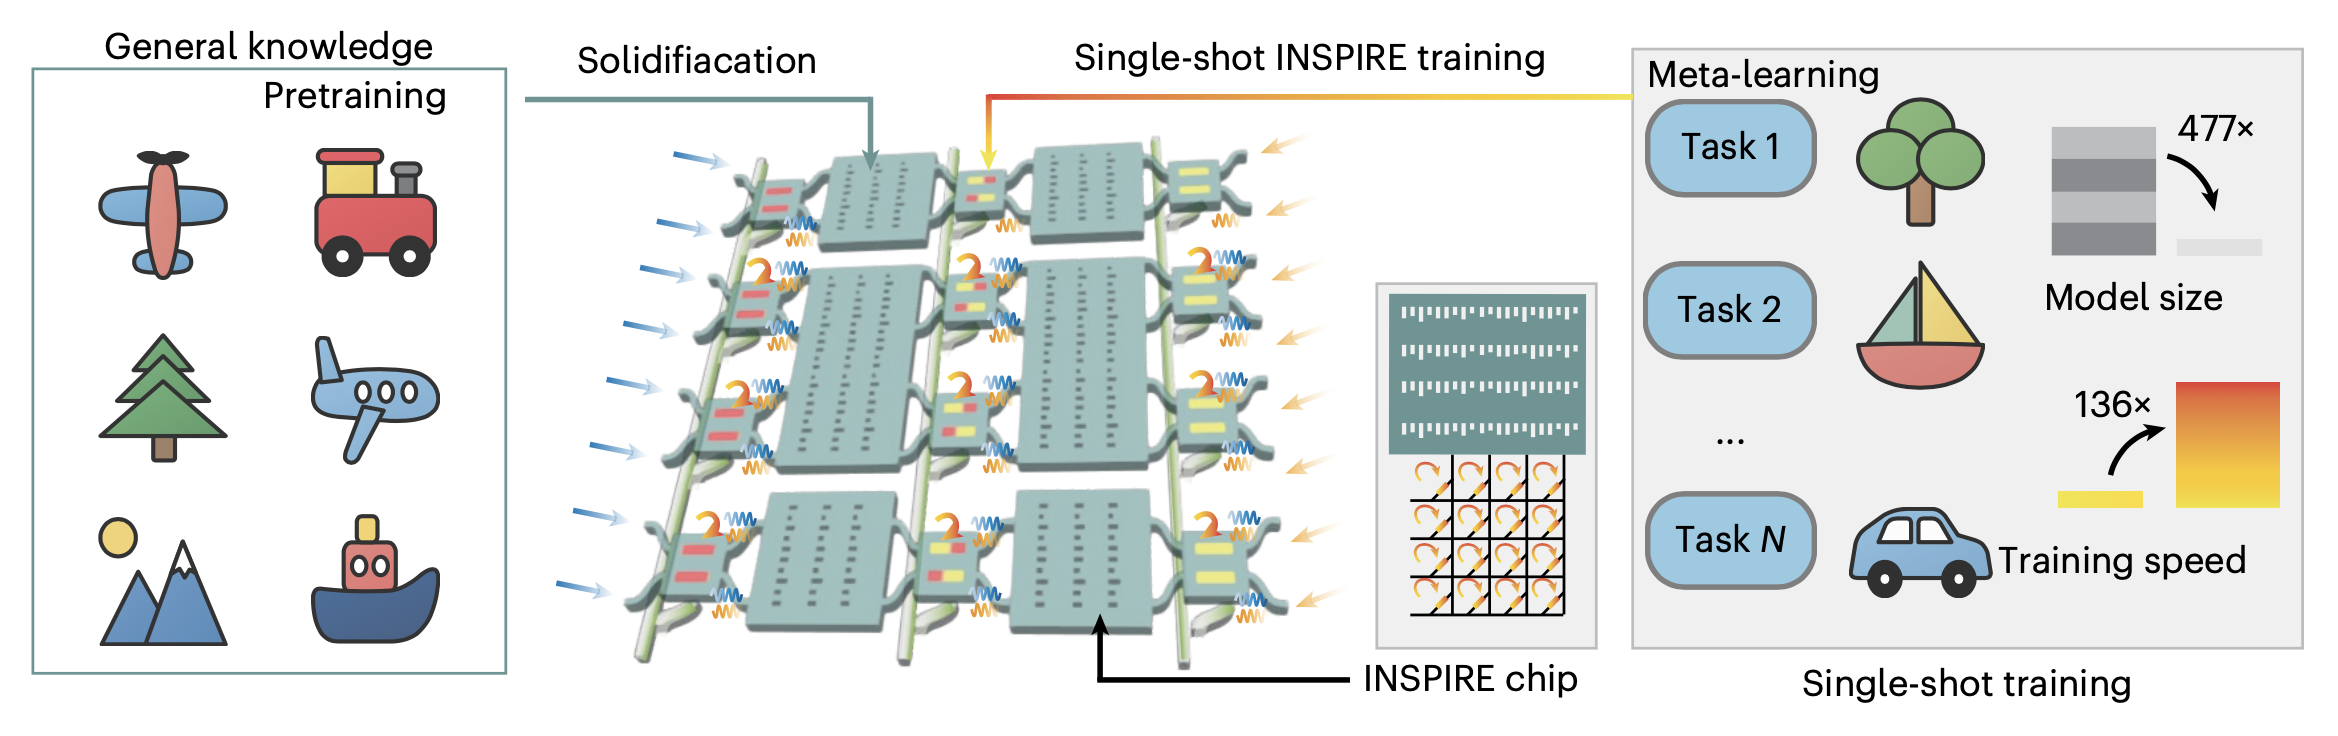
光子元学习架构
INSPIRE将梯度计算直接引入真实光子硬件,使光子芯片能够依据自身物理状态完成原位优化,并进一步适配新的计算任务。相比依赖离线数字模型的传统训练方式,这一物理梯度训练架构实现了从外部数字优化向硬件原位学习的转变,为构建可扩展、自适应的大规模智能光子计算系统提供了新的技术路径。
相关研究以“基于广义原位物理梯度下降的光子神经形态学习”(Photonic neuromorphic learning via generalized in situ physical gradient descent)为题,于10月5日发表在《自然·计算科学》(Nature Computational Science)。
清华大学电子工程系、北京信息科学与技术国家研究中心为论文第一单位。电子系水木学者博士后周天贶(现北京理工大学副教授)、深圳国际研究生院赵昀、电子工程系2024级博士生李尚龙为论文共同第一作者;清华大学电子工程系方璐教授、深圳国际研究生院黄儒麒副教授为论文共同通讯作者。
该项研究得到教育部基础与交叉学科突破计划、国家自然科学基金、XPLORER PRIZE及中国科协等支持。